
PerMIT: integritas memori jangka panjang agen LLM dan kepercayaan kolektif yang dapat diverifikasi mesin
Penulis mengusulkan arsitektur PerMIT yang membatasi masuknya data tak tepercaya dari lingkungan ke tindakan sensitif agen melalui antarmuka memori yang terbatas; dua teorema yang diverifikasi dengan Lean 4 dan akumulasi putusan komunitas mengurangi risiko peracunan tanpa menambah beban bagi pengguna individu. Dalam eksperimen pada Trojan Hippo dan τ²-bench, skema ini tidak mencatat injeksi yang berhasil dengan verifikator ringan dan meningkatkan hasil agen baru pada tugas yang ditunda.
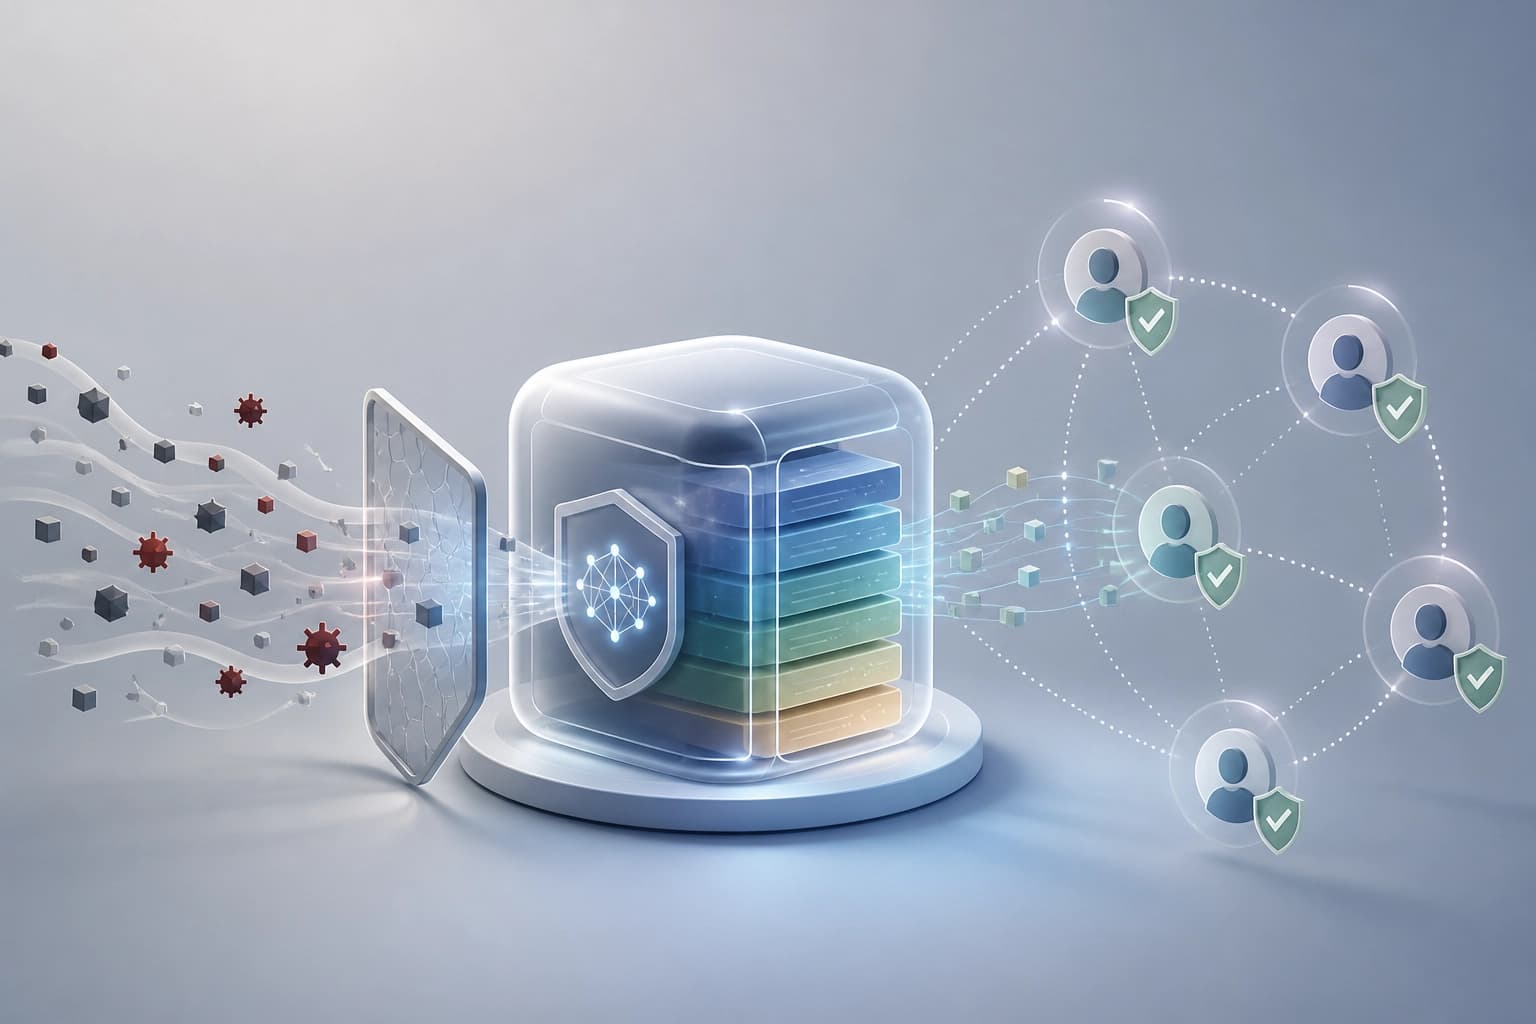
PerMIT — arsitektur memori untuk agen LLM. Artikel oleh Tanqiu Jiang, Min Bai, Sadat Shahriar, Wanyu Du, dan Sandesh Swamy diajukan pada 20 Oktober 2026; arXiv:2610.28987.
Model kepercayaan
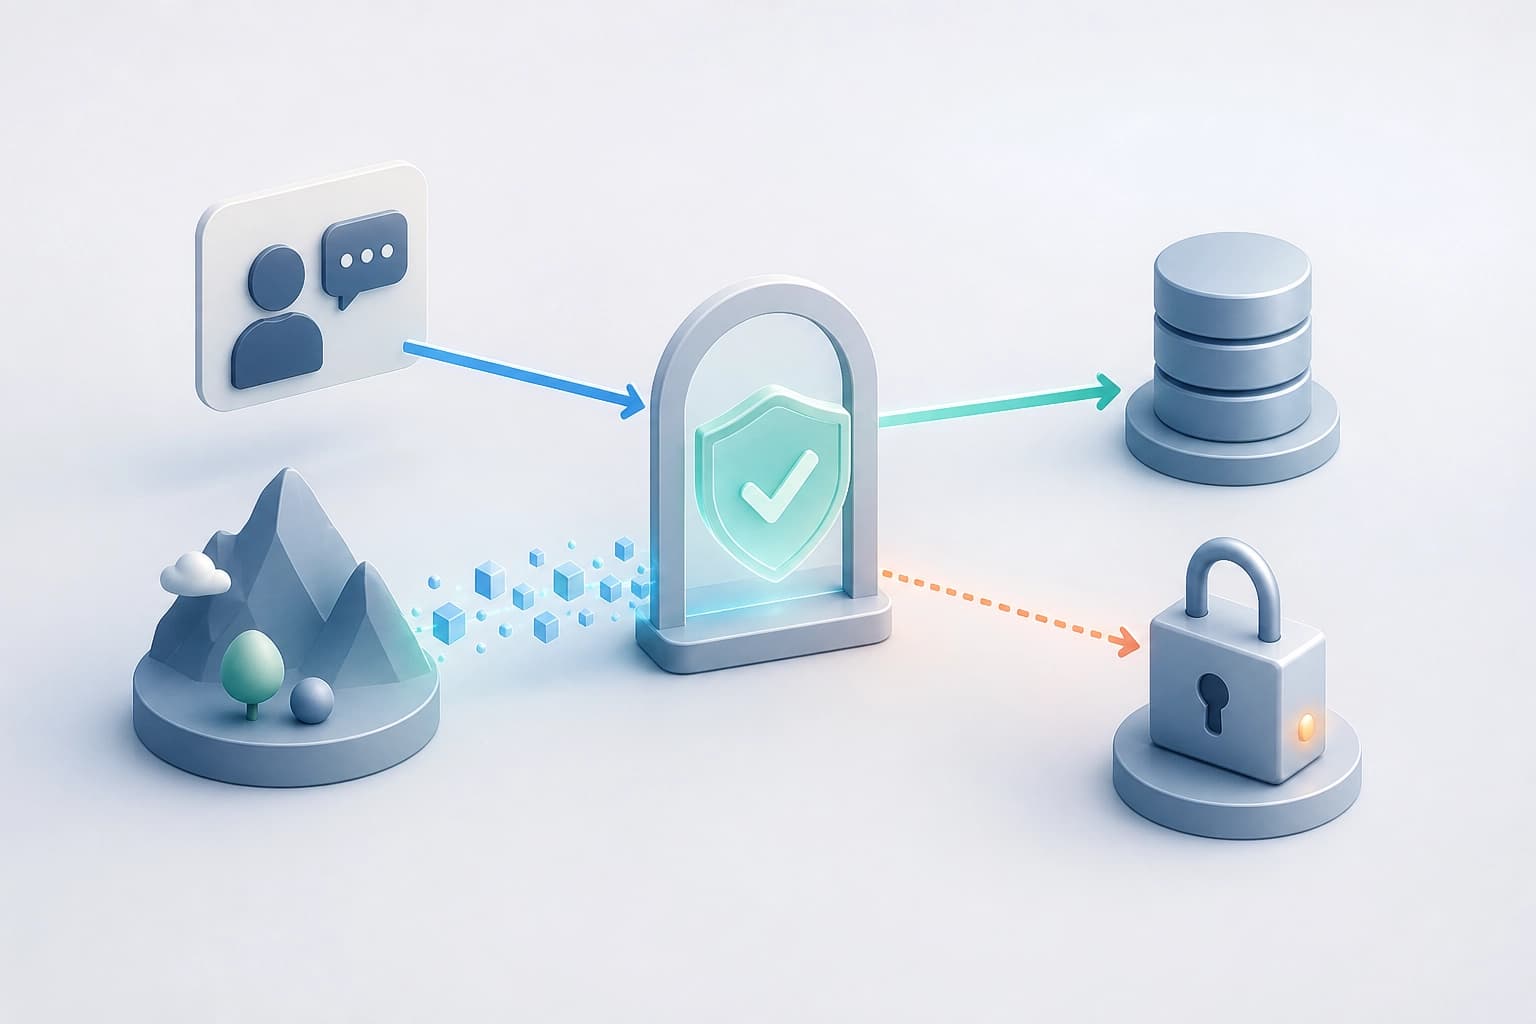
PerMIT menetapkan asumsi kepercayaan secara eksplisit. Hanya data yang dimasukkan pengguna dan nilai yang dikonfirmasi di gerbang yang dianggap tepercaya. Semua nilai dari lingkungan tetap tidak tepercaya. Arsitektur mengatur pemindahan dan penggunaannya melalui antarmuka memori yang terbatas. Perencanaan agen dalam beberapa langkah dan pemilihan alat tetap dipertahankan.
Kriteria praktis: skenario ini cocok jika masukan pengguna dianggap tepercaya, sedangkan data dari lingkungan tidak.
Gerbang dan keputusan yang dapat diverifikasi
Antarmuka memori yang terbatas mengandalkan gerbang. Para penulis membuktikan dua teorema integritas untuk antarmuka tersebut. Teorema-teorema ini diverifikasi dengan mesin di Lean 4. Secara bersama-sama, keduanya menjamin dua properti. Memori dari lingkungan hanya dapat mencapai tindakan sensitif setelah dikonfirmasi di gerbang. Perilaku agen hanya dapat berubah melalui hal yang ditampilkan gerbang.
Dalam model ancaman ini, setiap serangan dapat disederhanakan menjadi satu keputusan yang dapat diverifikasi. Dalam praktiknya, keputusan tersebut dibuat oleh manusia, verifier LLM, atau keduanya.
Kriteria praktis: perlindungan ini dapat diterapkan dalam model ancaman yang serangannya dapat disederhanakan menjadi satu keputusan yang dapat diverifikasi.
Konfirmasi dan kepercayaan kolektif
Setiap konfirmasi adalah keputusan tercatat atas konten tertentu. Konfirmasi terakumulasi di antara para pengguna. Item yang mendapat dukungan cukup menjadi terkonfirmasi oleh komunitas tanpa perlu pemeriksaan lebih lanjut.
Dengan asumsi yang dinyatakan secara eksplisit, para penulis membuktikan properti penskalaan bersama. Mereka juga mengonfirmasinya melalui simulasi. Seiring bertambahnya komunitas, risiko promosi data beracun dan penghapusan keliru atas pengetahuan yang baik berkurang. Upaya pemeriksaan setiap pengguna tidak bertambah.
| Perubahan seiring bertambahnya komunitas | Arah |
|---|---|
| Risiko promosi data beracun | Menurun |
| Risiko penghapusan keliru atas pengetahuan yang baik | Menurun |
| Upaya pemeriksaan setiap pengguna | Tidak bertambah |
Kriteria praktis: lapisan kolektif ini sesuai ketika keputusan terkait dengan konten tertentu dan terakumulasi di antara para pengguna.
Pengujian
Pada Trojan Hippo, PerMIT menunjukkan nol keberhasilan serangan yang teramati. Hasil ini diperoleh melalui pemeriksaan mandiri dan penggunaan verifier ringan.
Pada τ²-bench, komunitas yang terdiri hingga 90 agen otonom membuat basis pengetahuan bersama menggunakan PerMIT. Tidak ada injeksi langsung ke memori yang berhasil dipromosikan. Pengetahuan yang diperoleh secara signifikan meningkatkan hasil agen baru pada tugas-tugas yang ditahan untuk pengujian.
Kriteria praktis — dua hasil: tidak ada promosi injeksi langsung dan peningkatan kinerja agen baru pada tugas-tugas yang ditahan untuk pengujian.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Sistem AI multiagen komposit dengan siklus evidensi untuk perencanaan proton pada tumor kepala dan leher
Karya ini menguraikan integrasi kebijakan PPO terlatih yang menghasilkan beberapa opsi rencana dengan agen LLM yang melakukan klarifikasi melalui dialog, disertai pemeriksaan metrik klinis dan batasan; berdasarkan data dari 21 pasien, Qwen3-14B yang telah disesuaikan lebih baik dalam mengikuti instruksi dan membantu menggeser kompromi agar lebih mengutamakan tujuan prioritas. Kesimpulan praktisnya: perencanaan DRL otomatis dapat dilengkapi dengan dialog terarah, sambil tetap mempertahankan kendali atas batasan-batasan yang saling bersaing.
20 November 2026
Seleksi komputasional alih-alih coba-coba empiris: pendekatan baru untuk material baterai
Materi ini menunjukkan bagaimana basis data komputasi, machine learning, dan model generatif mempersempit pilihan komposisi yang menjanjikan, sementara laboratorium otomatis mempercepat pengujiannya; hasil akhirnya tetap bergantung pada sintesis dan pengujian, karena prediksi dapat berbeda dari konduktivitas yang sebenarnya.
20 November 2026
Evolusi benchmark agen seiring peningkatan skala kumpulan tugas: peran seleksi bukti dan perlombaan berurutan
Studi ini menjelaskan mengapa menambah jumlah tugas dapat menghambat evolusi lingkungan pengujian agen: penyebabnya adalah pemilihan bukti yang buruk, bukan volume data itu sendiri. Successive Scale Racing yang diusulkan memilih kombinasi tugas yang beragam secara bergiliran dan membandingkan kandidat dengan biaya rendah; pada tiga benchmark, metode ini meningkatkan proporsi uji coba yang berhasil saat kumpulan tugas bertambah dari 40 menjadi 200, sedangkan metode dasar mengalami penurunan, dan jumlah peluncuran verifikasi berkurang sekitar 60%.
19 November 2026