
Fig: intervensi permainan terkontrol untuk menguji perilaku sosial agen AI
Fig menerima deskripsi verbal tentang perilaku yang dicari, membaginya menjadi beberapa jenis, lalu mengubah kondisi permainan secara terarah untuk memicu tindakan yang diinginkan dari model. Dalam skenario valid untuk enam pola sosial, intervensi meningkatkan rata-rata proporsi upaya melakukan perilaku sasaran sebesar 10,9% dibandingkan kontrol, dan para penulis mengusulkan agar lingkungan multiagen dipandang sebagai sarana uji yang dapat dikonfigurasi untuk evaluasi yang dapat direproduksi.
Tujuan sistem
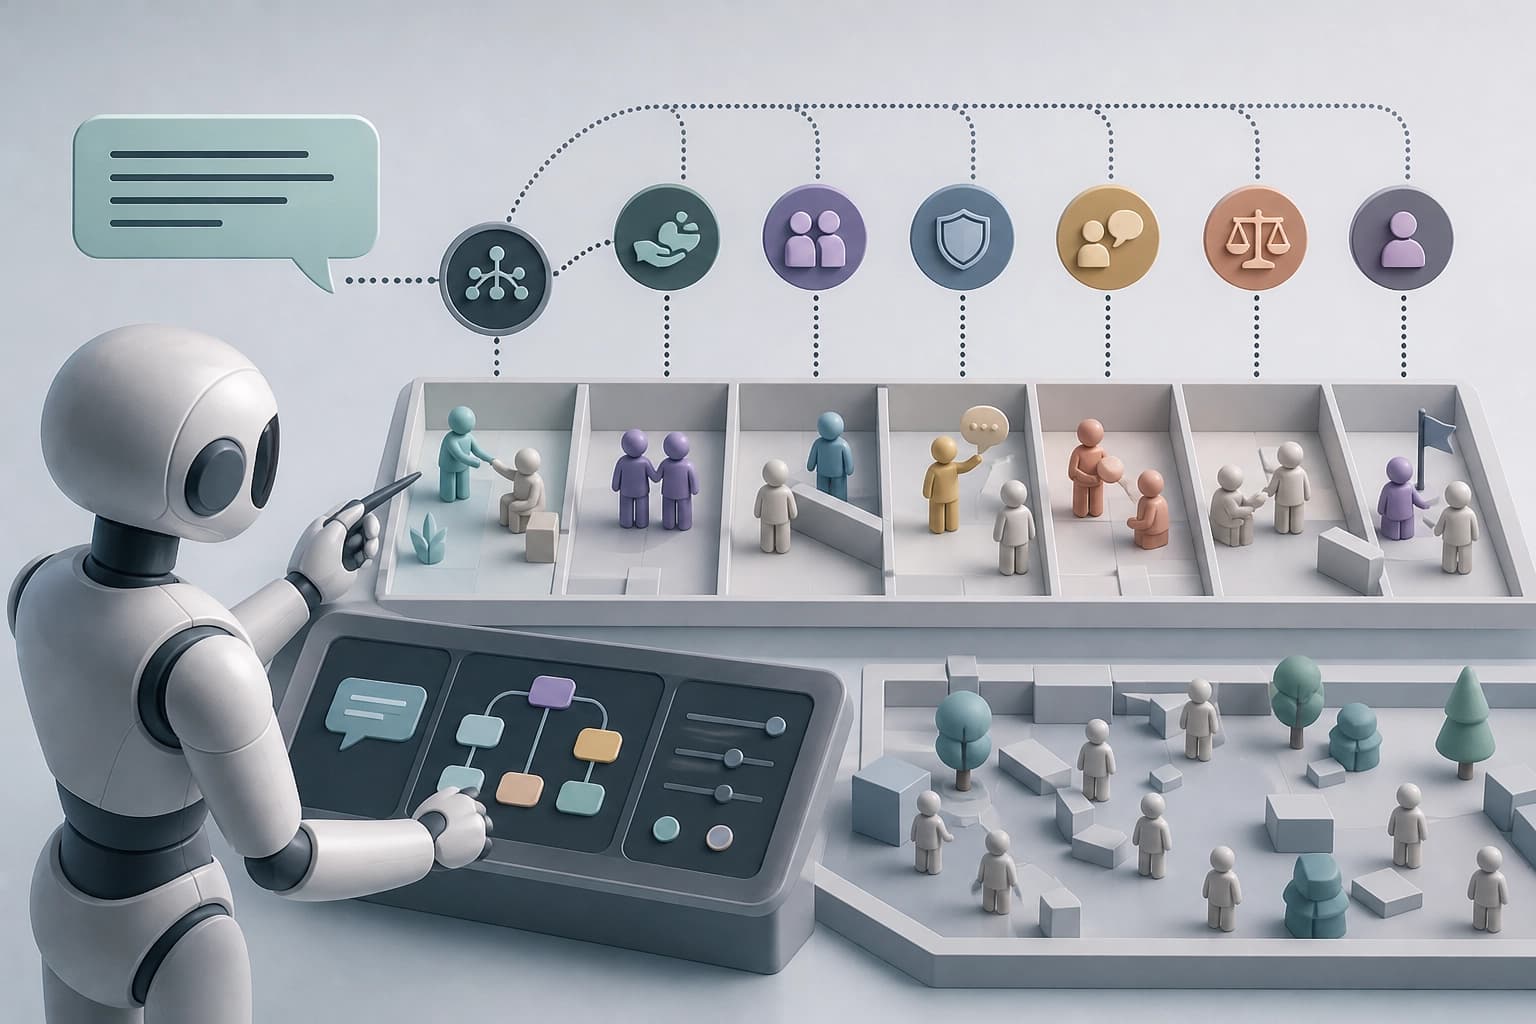
Fig adalah sistem agen (Finding Interactions in Games). Tujuannya adalah mengidentifikasi perilaku secara terarah di lingkungan permainan. Sistem ini bekerja dengan perilaku model di lingkungan permainan.
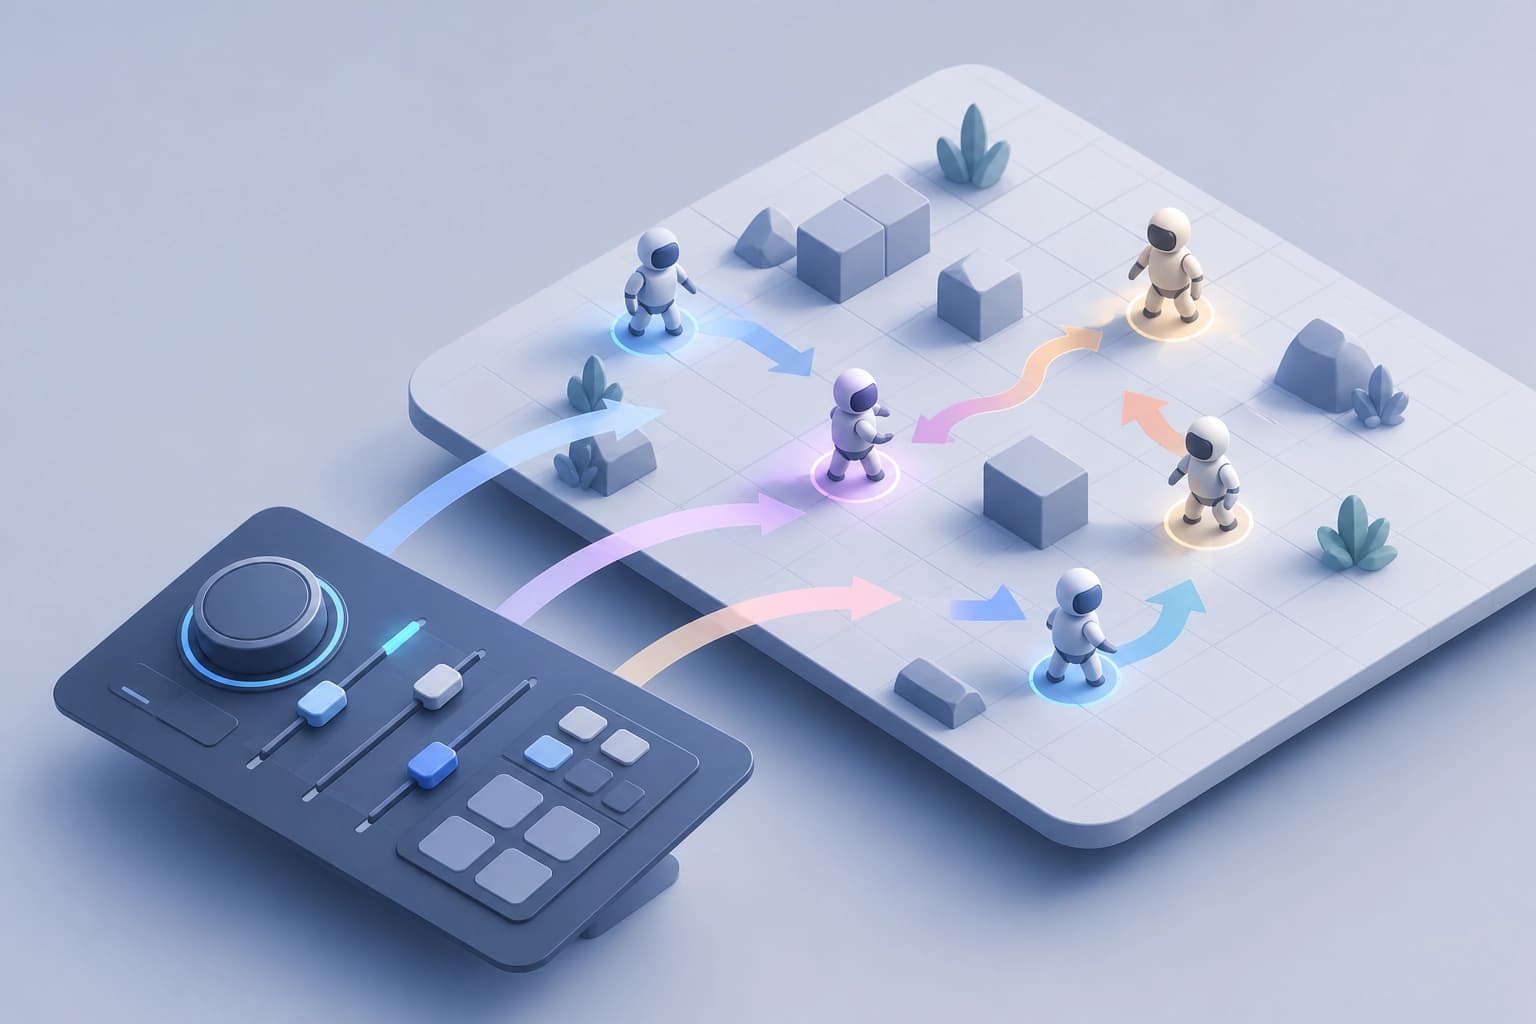
Fig tidak terbatas pada satu permainan yang sudah ditentukan sebelumnya. Sistem ini menghasilkan permainan sosial baru atau memilih permainan yang sudah ada. Dalam pendekatan ini, lingkungan permainan berfungsi sebagai pengujian terkontrol untuk perilaku sosial.
Kriteria praktis: Fig dipertimbangkan untuk tugas yang memerlukan identifikasi perilaku secara terarah di lingkungan permainan.
Dari deskripsi perilaku ke skenario
Fig menerima deskripsi perilaku dalam bahasa alami. Sistem ini memecah deskripsi menjadi subjenis perilaku. Kemudian Fig menghasilkan permainan sosial baru atau memilih permainan yang sudah ada.
Tahapan kerja:
- Memasukkan deskripsi perilaku dalam bahasa alami.
- Memecah deskripsi menjadi subjenis perilaku.
- Menghasilkan permainan sosial baru atau memilih permainan yang sudah ada.
Kriteria: jika perilaku dapat dideskripsikan dalam bahasa alami, Fig dapat menguraikannya menjadi subjenis dan memilih lingkungan yang sesuai.
Intervensi dan evaluasi
Fig menjalankan intervensi secara terpisah atau kombinasi. Sasaran intervensi:
- mesin permainan;
- perilaku lawan;
- instruksi;
- konteks.
Untuk mengevaluasi perilaku model, Fig menggabungkan pemeriksaan mekanis bawaan dan evaluasi sintetis berdasarkan rubrik. Intervensi, permainan yang dihasilkan, dan mekanisme evaluasi telah diperiksa oleh manusia.
Kriteria: pengujian dalam skenario mengandalkan intervensi, pemeriksaan mekanis, dan evaluasi sintetis berdasarkan rubrik.
Hasil pengujian
Skenario Fig yang valid mencakup enam jenis perilaku. Daftarnya meliputi kerja sama, eksploitasi, penipuan, koordinasi tersembunyi, pengkhianatan, dan sabotase.
| Indikator | Nilai |
|---|---|
| Proporsi episode dengan upaya melakukan perilaku sasaran dalam skenario yang valid | 45,2% |
| Peningkatan proporsi upaya dengan intervensi Fig dalam pasangan “permainan — perilaku” dibandingkan dengan kontrol | 10,9% relatif terhadap permainan kontrol yang sebanding |
Kriteria: pasangan “permainan — perilaku” diuji dengan permainan kontrol.
Kesimpulan praktis
Para penulis menunjukkan bahwa lingkungan multiagen dapat berfungsi sebagai arena pengujian yang dapat diprogram. Arena tersebut memungkinkan evaluasi perilaku secara sengaja, terkontrol, dan dapat direproduksi.
Para penulis menyertakan tautan ke kode dalam entri artikel di arXiv. Penulis: Anrui Gu, Zhichao Wang, Nicolai Ouporov. Para penulis mengajukan artikel pada 20 Oktober 2026; revisi terakhir pada 26 Oktober 2026.
Kriteria pemilihan: jika diperlukan evaluasi perilaku sosial agen yang disengaja, terkontrol, dan dapat direproduksi, pendekatan Fig menyediakan rancangan pengujian.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Pengujian kebijakan agen tanpa bergantung pada prompt: lingkungan eksekusi, kumpulan pengujian, dan filter yang dapat dilatih
Karya ini menawarkan kerangka kerja yang mengubah lingkungan eksekusi menjadi serangkaian skenario untuk menguji kebijakan agen dan memungkinkan komponen perlindungan ditingkatkan secara iteratif. Filter yang dilatih mengurangi tingkat pelanggaran yang berhasil sebesar 40–44% dibandingkan dengan hanya mengandalkan instruksi dalam prompt, dan lebih jarang keliru menolak permintaan yang aman.
20 November 2026
PerMIT: integritas memori jangka panjang agen LLM dan kepercayaan kolektif yang dapat diverifikasi mesin
Penulis mengusulkan arsitektur PerMIT yang membatasi masuknya data tak tepercaya dari lingkungan ke tindakan sensitif agen melalui antarmuka memori yang terbatas; dua teorema yang diverifikasi dengan Lean 4 dan akumulasi putusan komunitas mengurangi risiko peracunan tanpa menambah beban bagi pengguna individu. Dalam eksperimen pada Trojan Hippo dan τ²-bench, skema ini tidak mencatat injeksi yang berhasil dengan verifikator ringan dan meningkatkan hasil agen baru pada tugas yang ditunda.
20 November 2026
Sistem AI multiagen komposit dengan siklus evidensi untuk perencanaan proton pada tumor kepala dan leher
Karya ini menguraikan integrasi kebijakan PPO terlatih yang menghasilkan beberapa opsi rencana dengan agen LLM yang melakukan klarifikasi melalui dialog, disertai pemeriksaan metrik klinis dan batasan; berdasarkan data dari 21 pasien, Qwen3-14B yang telah disesuaikan lebih baik dalam mengikuti instruksi dan membantu menggeser kompromi agar lebih mengutamakan tujuan prioritas. Kesimpulan praktisnya: perencanaan DRL otomatis dapat dilengkapi dengan dialog terarah, sambil tetap mempertahankan kendali atas batasan-batasan yang saling bersaing.
20 November 2026