
Masalah: tesnya sedikit, tapi hadiahnya untuk semuanya
Pembelajaran dengan penguatan pada hadiah yang dapat diverifikasi (RLVR) telah menjadi cara utama untuk membawa model bahasa ke tingkat yang layak dalam generasi kode. Skemanya sederhana: model menulis solusi, pemeriksaan khusus menjalankannya melalui tes, dan berdasarkan hasilnya model diberi hadiah. Semuanya bertumpu pada satu asumsi — bahwa tes benar-benar menggambarkan tugas secara keseluruhan.
Dalam praktiknya, asumsi ini hampir selalu dilanggar. Kumpulan kasus uji sempit, cakupannya berlubang, dan model cukup cepat menemukan bukan tugasnya, melainkan celahnya: menyesuaikan kode dengan pemeriksaan spesifik alih-alih belajar menyelesaikan kelas tugas serupa. Selanjutnya spiral yang sudah dikenal pun berputar — reward hacking, yang diikuti degradasi kebijakan. Model kehilangan keterampilan umumnya sebesar keberhasilannya dalam tipu daya sempit.
Analogi kasarnya: ujian yang terdiri dari dua pertanyaan. Mahasiswa yang menghafal jawaban kedua pertanyaan itu mendapat nilai A, tapi tidak menguasai mata kuliahnya. Dan semakin lama pembelajaran seperti itu berlangsung, semakin buruk kemampuannya dalam segala hal lainnya.
Ide RobustTests: kesalahan sebagai generator tes
Biasanya tes diciptakan berdasarkan kondisi tugas: input seperti apa yang ada, di mana batas rentangnya, apa yang terjadi pada input kosong. Logis, tapi justru jalur inilah yang menghasilkan cakupan sempit — penulis tes dan penulis solusi memandang tugas dari sisi yang sama dan sama-sama buta terhadap tempat yang sama.
RobustTests membalik prosesnya. Dasar kerangka ini adalah sintesis kasus uji yang dipandu kode cacat (faulty-code-driven test case synthesis). Ini bukan tentang kode rusak acak, melainkan tentang solusi yang "hampir benar": solusi yang berbeda dari yang benar hanya karena perubahan logika kecil — tanda perbandingan yang tertukar, batas perulangan yang salah, cabang yang terlewat. Setiap solusi seperti itu hampir berfungsi, dan justru karena itulah ia berharga.
Selanjutnya dicari input di mana kode yang hampir benar menyimpang dari kode acuan. Input yang ditemukan itulah yang menjadi tes. Tes semacam itu memiliki daya diagnostik yang tinggi: ia bukan sekadar "memeriksa sesuatu", melainkan membedakan dua perilaku yang berdekatan — yang kita inginkan dari model, dan yang terlihat masuk akal tetapi keliru.
Karya ini dijelaskan dalam pracetak arXiv:2608.24135 (Yiwen Zhang dan delapan penulis lainnya, di antaranya Xiaodong Yan, Zhenyu Huang, Deng Zhao dan lain-lain; v1 — 25 Agustus 2026, v2 — 27 Agustus 2026, DOI 10.48550/arXiv.2608.24135, diterima untuk EMNLP 2026). Para penulis menggolongkan materi ini ke dua bagian sekaligus — cs.AI dan cs.SE, yang masuk akal: ini tentang pelatihan model sekaligus tentang rekayasa pengujian.
Penyaringan: agen validator dan pengelompokan
Sintesis tes otomatis apa pun mudah berubah menjadi generator sampah. Sebagian input yang diciptakan akan tidak valid, sebagian akan saling menduplikasi, sebagian lagi memeriksa perilaku yang sama dari sudut berbeda. Sinyal berguna dari kumpulan seperti itu sedikit, sedangkan kebisingannya banyak.
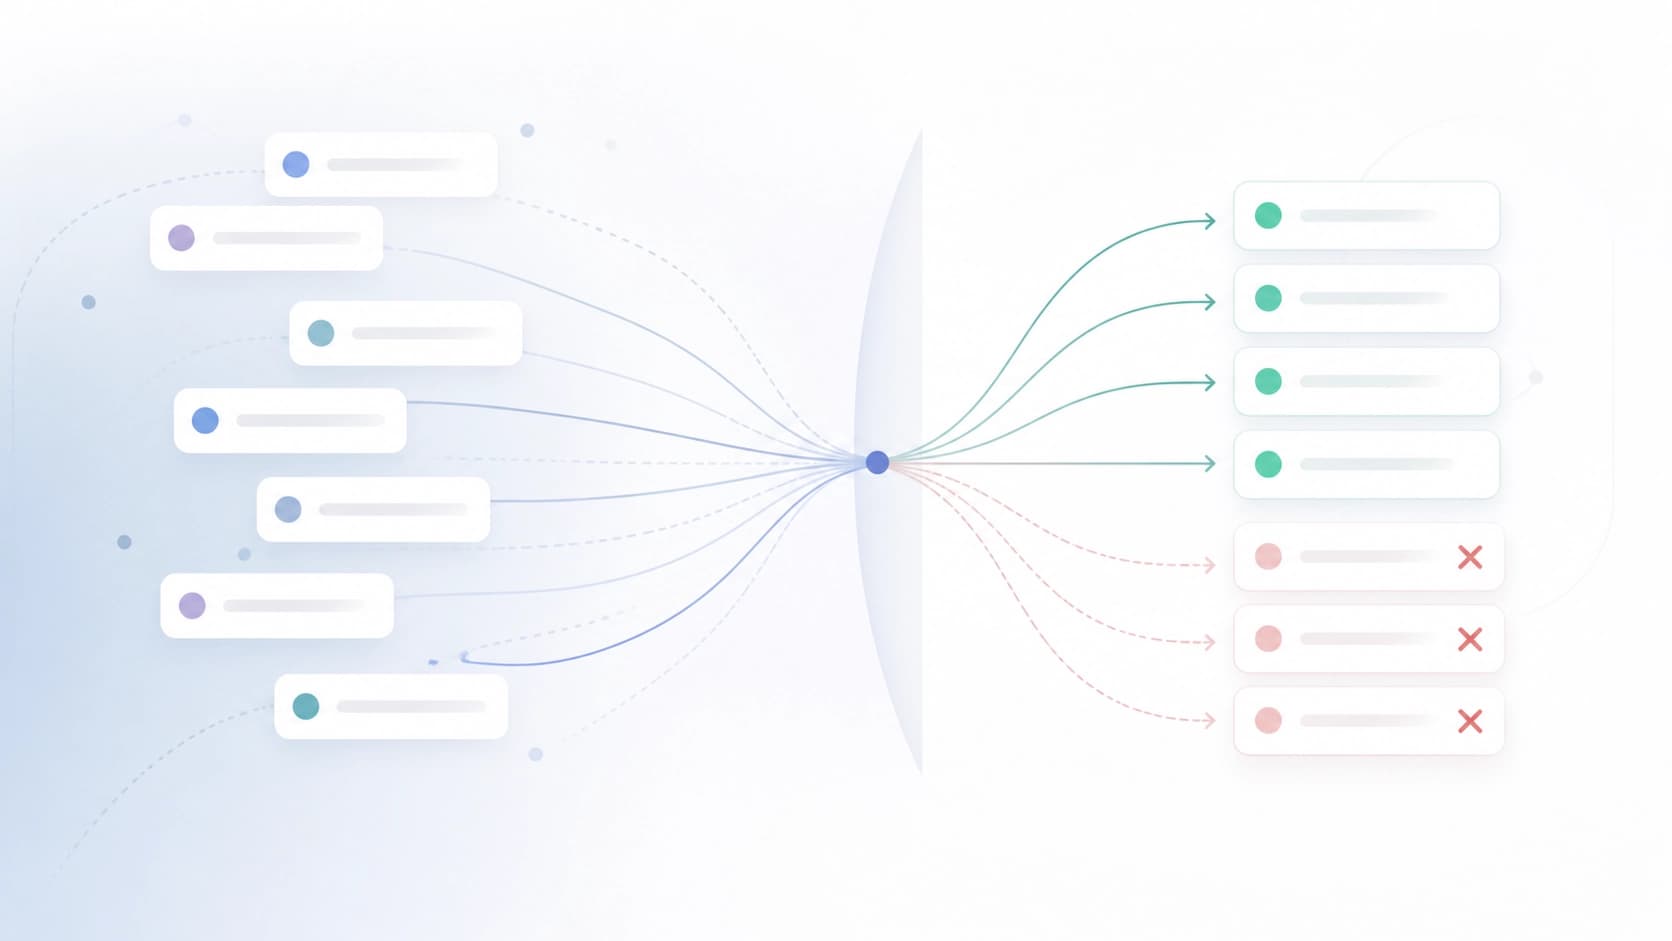
Karena itu, dalam pipeline disediakan lapisan kedua — agen validator yang menyaring kasus uji yang tidak benar dan berlebihan. Ditambahkan pula pengelompokan berdasarkan ciri perilaku: tes dikelompokkan menurut perilaku kode mana yang mereka bedakan, dan duplikat dalam kelompok diciutkan. Hasilnya adalah kumpulan yang ringkas, di mana setiap elemen menambah informasi baru, bukan mengulang tetangganya.
Hadiah padat alih-alih sinyal langka
Komponen kedua kerangka ini bukan tentang tes, melainkan tentang bagaimana hadiah dihitung darinya. Pendekatan biner klasik — "semuanya lulus atau tidak ada yang lulus" — bekerja buruk ketika tes menjadi banyak dan tingkat kesulitannya beragam: model menyelesaikan hampir semuanya, tersandung pada satu kasus tepi, dan mendapat nilai nol yang sama seperti solusi yang sepenuhnya rusak. Sinyal pembelajaran terputus, dan hampir tidak ada yang bisa dipelajari darinya.
RobustTests memperkenalkan fungsi hadiah padat bertahap (stepwise dense reward), yang bertumpu pada proporsi pemeriksaan yang lulus — pass rate. Model menerima sinyal parsial dan memahami arah pergerakannya: bukan "gagal", melainkan "tersisa dua tes dari tiga puluh". Ini menyelesaikan dua masalah sekaligus. Pertama, mengurangi jumlah positif palsu (false negatives), ketika solusi yang benar ditolak karena tes yang terlalu ketat atau sekadar keliru. Kedua, membuat pembelajaran lebih stabil: hadiah berhenti menjadi peristiwa langka dan berubah menjadi skala.
Perlu ditekankan secara khusus keterkaitan kedua ide ini. Hadiah padat hanya bermakna ketika tes benar-benar membedakan berbagai jenis kesalahan — jika tidak, Anda hanya merata-ratakan kebisingan. Dan sintesis tes dari solusi yang hampir benar tanpa hadiah padat akan meninggalkan pemutusan sinyal yang sama. Komponen-komponen ini bekerja berpasangan.
Dataset dan hasil
Dengan pipeline ini, para penulis menyusun versi yang diperluas dari dataset CodeContests+ — dengan kegunaan diagnostik yang jauh lebih tinggi: kumpulan tes menjadi lebih tepat dalam menunjukkan pada langkah mana model melakukan kesalahan.
Ukuran utamanya bukan ukuran dataset, melainkan perilaku model setelah pelatihan lanjutan. Pelatihan RL Qwen3-32B dengan menggunakan RobustTests memberikan peningkatan absolut 3% pada LiveCodeBench. Kode dan datanya dipublikasikan secara terbuka oleh para penulis.
Di sini perlu tetap bersikap bijak. Tiga poin persentase pada satu benchmark saat melatih lanjut satu model — ini bukan revolusi di bidangnya, melainkan peningkatan yang rapi dengan mekanisme yang jelas. Nilai karya ini lebih terletak pada metodologinya: ia menawarkan resep yang dapat direproduksi untuk memeras lebih banyak sinyal dari tes, tanpa memperbanyaknya secara manual. Keterbatasannya juga jelas — pemindahan hasil ke model, bahasa, dan jenis tugas lain masih perlu diuji.
Apa yang layak diambil dari ini ke dalam praktik Anda
Bahkan jika Anda tidak menyusun pipeline RL dan hanya mengevaluasi kualitas generasi kode, logikanya dapat dipindahkan hampir tanpa perubahan:
- Tulislah tes dari kesalahan, bukan hanya dari kondisi. Ambil solusi yang hampir berfungsi, dan temukan input di mana ia rusak. Tes seperti itu hampir selalu lebih informatif daripada sepuluh tes yang diciptakan secara "langsung".
- Hitunglah proporsi pemeriksaan yang lulus, bukan fakta kelulusannya. Skor parsial memberikan gradien baik dalam pembelajaran maupun dalam analitik kualitas — terlihat di mana tepatnya model gagal.
- Saringlah tes yang disintesis. Tanpa validasi dan deduplikasi, kumpulan yang dihasilkan secara otomatis cepat berubah menjadi tumpukan pemeriksaan yang saling mirip.
- Perhatikan apa yang sebenarnya didorong oleh hadiah. Skala padat mengurangi kecenderungan mencari jalan pintas, tetapi tidak menghilangkannya: jika tes tidak membedakan perilaku, hadiah apa pun cepat atau lambat akan dibobol.
Ide yang dibawa RobustTests secara manusiawi sederhana: sumber terbaik untuk tes yang sulit bukanlah imajinasi penulisnya, melainkan hampir-kesalahan sistem itu sendiri. Apa yang hampir dilakukan dengan benar oleh model adalah indikator paling jujur tentang di mana letak batas antara "mirip solusi" dan "solusi".


