
Hakim yang terlalu mudah dipercaya
Model multimodal semakin sering berperan sebagai arbiter: mereka melihat gambar, video, atau mendengarkan audio dan menjatuhkan putusan — apakah hasilnya sesuai dengan permintaan teks. "Hakim serba bisa" semacam ini dipakai baik untuk menilai sistem generatif maupun untuk anotasi data otomatis, ketika pakar manusia tidak cukup untuk menangani semuanya.
Logikanya jelas: jika sebuah model mampu memahami beberapa modalitas sekaligus, mengapa tidak menyerahkan pemeriksaan text-to-image, text-to-video, dan text-to-speech kepadanya? Namun di sini tersimpan pertanyaan yang tidak nyaman. Akurasi akhir yang baik dari hakim semacam itu belum berarti ia benar-benar melihat apa yang dinilainya. Kumpulan tes dan dataset pelatihan yang ada biasanya condong ke contoh-contoh yang berhasil, sementara berbagai jenis kegagalan dicampur menjadi satu.
Hasilnya — gambaran yang terdistorsi. Hakim menghasilkan angka yang lumayan karena ia belajar mengatakan "ya", sementara titik butanya yang sebenarnya tetap tidak terlihat. Inilah masalah yang dibahas dalam karya terbaru dari arXiv.
Apa yang ditawarkan para penulis: D3-Omni
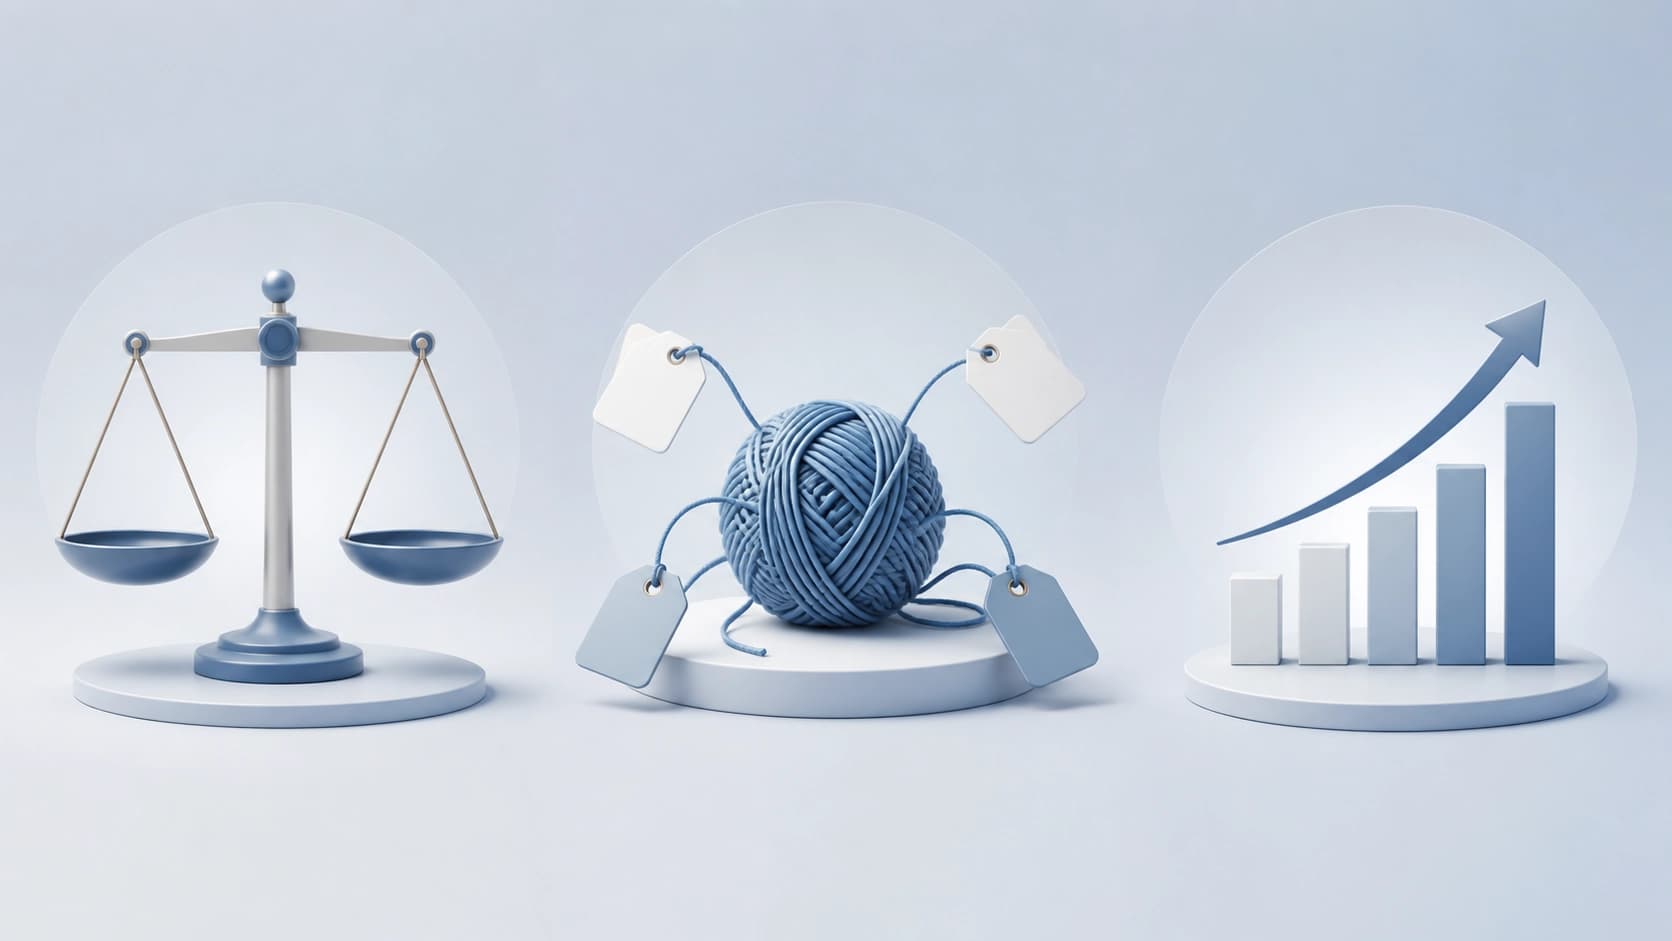
Penelitian ini terbit dengan judul yang dibangun para penulis di atas kontras: "OmniJudge or OmniBias?". Alih-alih peringkat lain, mereka menyusun alat diagnostik — D3-Omni, sebuah benchmark yang dirancang agar tidak memberi hakim kesempatan bersembunyi di balik statistik umum. Namanya dijabarkan melalui tiga prinsip, dan masing-masing menyerang kelemahan spesifik dari tes yang biasa.
Dual-balanced: kecenderungan ke arah "semuanya baik" dihilangkan
Prinsip pertama bertanggung jawab atas keseimbangan. Alih-alih mengumpulkan contoh seadanya, kumpulan data diseimbangkan: untuk setiap karakteristik yang diuji harus ada jumlah kasus berhasil dan gagal yang sebanding. Dengan begitu hilanglah situasi ketika model mengumpulkan poin hanya karena jawaban yang benar lebih sering "ya".
Decoupled: satu kesalahan — satu penyebab
Prinsip kedua — pemisahan. Setiap cacat dalam tes terikat pada tepat satu kemampuan. Jika hakim membuat kesalahan, jelas apa yang kurang darinya: pemahaman komposisi, warna, sinkronisasi suara, atau hal lain. Tidak ada contoh gabungan yang membuat tidak jelas pelanggaran mana dari ketiganya yang membingungkan model.
Dynamic: tes menyesuaikan diri dengan kemajuan generator
Prinsip ketiga — dinamika. Konstruksi tes diarahkan ke tempat yang representasi contohnya masih kurang, seiring model generatif menguasai bidang baru. Tujuannya — menjaga keseimbangan sekitar satu banding satu untuk setiap karakteristik dan pengisian yang merata di semua tingkat skor akhir.
Bagaimana kumpulan data disusun
Skala D3-Omni cukup besar: 53 karakteristik biner, terbagi ke dalam tiga tugas (17, 22, dan 14 untuk masing-masing), dan 10.671 contoh (3.526, 1.998, dan 5.147 secara berurutan). Karakteristiknya dipilih secara ortogonal — tidak saling menduplikasi.
Detail rekayasa tersendiri — bagaimana contoh negatif diperoleh. Para penulis secara prinsip menolak regenerasi output: jalur semacam itu menyebabkan kebocoran informasi antar karakteristik, dan tesnya tidak lagi bersih. Sebagai gantinya, mereka mengambil "benih" yang sudah terbukti sepenuhnya positif, lalu memasukkan pelanggaran secara terkendali — menulis ulang prompt dan menambahkan gangguan yang ditargetkan, yang mengisolasi satu karakteristik.
Apa yang terungkap: hakim dengan yakin memuji dan buruk dalam menangkap cacat
Hal paling menarik dalam karya ini — bukanlah konstruksi benchmark-nya, melainkan apa yang ditunjukkannya. Bahkan hakim multimodal yang kuat tersandung pada karakteristik yang berkaitan langsung dengan modalitas. Sederhananya, mereka justru kesulitan pada hal yang menjadi alasan mereka diambil sebagai penilai.
Pengamatan kedua bahkan lebih tidak menyenangkan. Model jauh lebih andal mengonfirmasi persyaratan yang terpenuhi daripada menemukan yang dilanggar. Asimetrinya konsisten: mengatakan "di sini semuanya sesuai permintaan" jauh lebih mudah bagi hakim daripada menangkap ketidaksesuaian tertentu.
Ketiga — atribut yang secara nominal berbeda cenderung dipersepsikan model sebagai satu keputusan utuh. Perbedaan antar sifat terkikis, dan hakim menjatuhkan putusan yang digeneralisasi alih-alih mengurai per poin.
Mengapa persentase agregat menipu
Dari pengamatan-pengamatan ini tersusun kesimpulan utama: akurasi akhir bisa menutupi titik buta yang sistematis. Hakim yang secara konsisten menebak jawaban "positif" akan tampak lumayan pada kumpulan data yang condong — dan akan gagal di tempat yang perlu menangkap kesalahan generator.
Optik yang seimbang dan terpisah diperlukan bukan untuk keindahan metrik, melainkan agar zona-zona ini menjadi terlihat. Dan setelah terlihat — bisa ditutup secara terarah: melatih ulang pada karakteristik bermasalah, bukan mengejar skor rata-rata.
Untuk praktik, ini berarti satu hal sederhana. Jika Anda menyusun pipeline di mana model-hakim memfilter hasil generasi atau menganotasi dataset, ia harus diuji pada kumpulan data yang condong ke negatif, bukan pada sampel nyaman yang berisi contoh-contoh berhasil. Jika tidak, penilai akan meloloskan cacat, dan Anda akan mengetahuinya dari pengguna, bukan dari metrik.
Singkatnya
- D3-Omni — benchmark untuk mendiagnosis hakim multimodal, bukan peringkat model.
- Tiga prinsip: keseimbangan contoh positif dan negatif, pengikatan setiap kesalahan pada satu kemampuan, penyesuaian tes dengan perkembangan generator.
- 53 karakteristik dan hampir 11 ribu contoh pada tugas text-to-image, text-to-video, dan text-to-speech.
- Negatif dibuat dengan menulis ulang prompt dan gangguan yang ditargetkan, bukan regenerasi — agar karakteristik tidak tercampur.
- Kesimpulan utama: hasil rata-rata yang tinggi bisa menyembunyikan titik buta yang konsisten, terutama di tempat yang perlu menyadari pelanggaran, bukan mengonfirmasi kesesuaian.


