
Data mentah alih-alih tabel siap pakai
Model semakin sering berperan sebagai agen kode: mereka ditugaskan menulis skrip untuk memproses data, membuat grafik, menghitung metrik, membedah hasil rekayasa. Namun ada satu kelas tugas yang hingga kini hampir belum diuji — bekerja dengan "bahan mentah" tingkat fisik. Justru ceruk inilah yang diisi oleh benchmark EMRB (Electromagnetic Reasoning Benchmark), yang dijelaskan dalam pracetak arXiv:2608.24086 (bagian cs.AI, cs.CE, cs.SE).
Ide utamanya sederhana dan karena itu meyakinkan. Pada inputnya — hanya rekaman I/Q mentah, yaitu sampel kuadratur sinyal, sebagaimana yang datang dari penerima. Tidak ada fitur yang telah diproses sebelumnya, tidak ada spektrogram berlabel, apalagi tabel dengan nilai yang sudah jadi. Besaran yang menjadi acuan pertanyaan harus terlebih dahulu ditemukan oleh model di dalam data — melalui kode yang ia tulis dan jalankan sendiri.
Apa bedanya dengan pengukuran yang biasa
Dalam beberapa tahun terakhir muncul banyak kumpulan tugas di mana model diminta bernalar tentang sinyal radio. Namun paling sering di sana pekerjaan sudah dilakukan untuk model: dari rekaman diekstraksi fitur, dihitung spektrum, diperkirakan tingkat derau, semuanya dirangkum ke dalam tabel terstruktur. Dalam pengaturan seperti itu yang tersisa hanyalah aritmetika dan pencocokan angka — keterampilan yang berguna, tetapi tidak berkaitan dengan radiofisika.
Perbedaannya mendasar. Ketika besaran sudah ditentukan sebelumnya, kesalahan model pada langkah awal tidak terlihat: perkiraan lebar pita atau frekuensi yang salah tidak akan muncul, karena nilai-nilai itu sudah diberikan dalam soal. Ketika datanya belum diolah — kesalahan apa pun pada tahap pengintaian sinyal akan menyeret seluruh perhitungan berikutnya. Karena itu EMRB menguji bukan pengetahuan istilah, melainkan kemampuan menyusun rantai: melihat sampel, memahami sinyal apa yang ada di sana, mengekstraksi karakteristik yang diperlukan, menghitungnya dengan benar, dan tidak kehilangan dimensi.
Bagaimana benchmark ini disusun
Para penulis — Mingxu Zhang, Ying Sun, Yuhan Li, Yang Ji, Dazhong Shen, Ke Zhang, dan Shan Huang — mengumpulkan 200 tugas. Tugas-tugas itu dibagi ke dalam lima tingkat kesulitan dan 27 jenis pertanyaan: dari deteksi sinyal yang sederhana hingga perancangan sistem OFDM. Sumber materinya adalah 11 jenis sinyal, dan untuk masing-masing telah disiapkan ground truth yang terverifikasi.
Lima tingkat
Tingkat-tingkat itu disusun berdasarkan peningkatan kemandirian model. Di bawah — pengukuran parameter dasar: menemukan sinyal, memperkirakan karakteristiknya. Di atasnya — interpretasi dan perbandingan, lalu analisis dengan beberapa langkah, kemudian diagnostik, dan akhirnya perancangan sistem, di mana model dituntut bukan untuk mengukur, melainkan merancang solusi sesuai persyaratan yang diberikan.
27 jenis pertanyaan dan 11 jenis sinyal
Keragaman seperti itu diperlukan agar hasilnya tidak bergantung pada satu rumusan yang kebetulan berhasil atau gagal. Jenis sinyal yang berbeda menghadirkan jebakan yang berbeda: di suatu tempat derau mengganggu, di tempat lain — tumpang tindih spektrum, di tempat lain lagi perlu penanganan yang cermat terhadap pencuplikan. Jumlah jenis pertanyaan dan sinyal bersama-sama membentuk ruang di mana sulit untuk menebak secara kebetulan.
Data terbuka
Semua materi dan kode tersedia di repositori GitHub publik, sehingga hasilnya dapat diverifikasi ulang secara independen. Untuk benchmark ini hal itu lebih penting dari biasanya: jika tugas-tugas dihasilkan, bukan dikumpulkan secara manual dari rekaman lapangan, pertanyaan tentang keakuratan acuan menjadi sentral — dan keterbukaan di sini adalah satu-satunya jawaban yang berhasil.
Apa yang ditunjukkan oleh model-model
Diuji 14 model bahasa: proprietary, terbuka bobotnya, dan secara terpisah model yang berfokus pada penalaran. Rentang hasil akhirnya — dari 24,1% hingga 78,9%. Rentang itu sendiri sudah banyak berbicara: perbedaan antara model terbaik dan terburuk di sini diukur bukan dalam persen, melainkan dalam kelipatan.
Namun yang lebih menarik adalah hal lain. Hasil rata-rata menurun tajam seiring meningkatnya tingkat kesulitan: dari 84,9% pada pengukuran dasar menjadi 21,2% pada perancangan sistem. Artinya, model cukup baik ketika harus menghitung besaran yang terukur, dan hampir runtuh ketika dituntut merakit solusi yang berfungsi dari besaran-besaran tersebut.
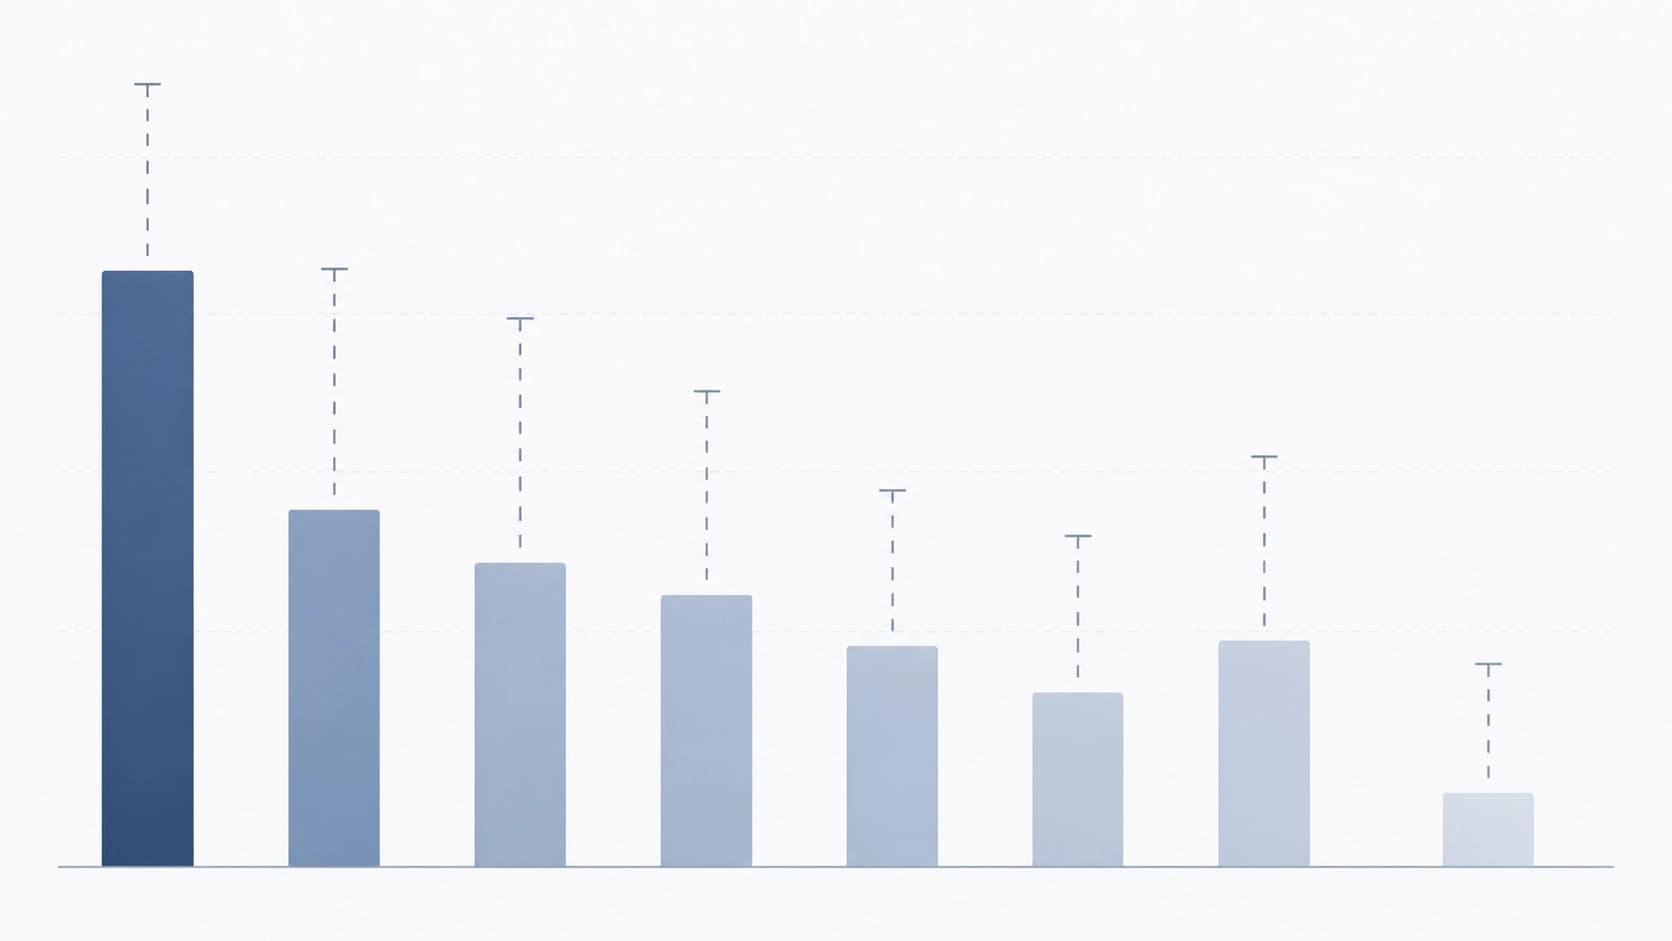
Ini sebaiknya dibaca sebagai diagnosis, bukan sebagai peringkat. Kekuatan model saat ini — eksekusi kode dan aritmetika di atas pengaturan yang sudah diketahui. Kelemahannya — menerjemahkan tugas rekayasa ke dalam bahasa langkah-langkah yang terukur: memahami besaran apa saja yang diperlukan, dalam urutan apa mencarinya, bagaimana memverifikasi bahwa yang ditemukan memang masuk akal. Justru kesenjangan inilah yang membuat benchmark ini bermanfaat.
ReconPilot: pengintaian, analisis, verifikasi
Para penulis tidak berhenti pada pengukuran. Mereka mengusulkan ReconPilot — pendekatan terstruktur di mana pekerjaan dibagi menjadi tiga tahap: pengintaian sinyal, analisis bertarget, dan verifikasi mandiri. Pertama, model mempelajari rekaman dan membentuk gambaran tentang apa yang dihadapinya. Kemudian menyelesaikan tugas spesifiknya. Lalu kembali ke hasilnya dan memeriksa konsistensinya.
Pada tiga model dasar, metode ini menambahkan 3,8 hingga 17,6 poin pada skor total. Peningkatan dicapai pada 13 dari 15 kombinasi "backbone + tingkat" yang diuji. Perhatikan rumusannya: keuntungannya tidak seragam, dan dalam dua kasus tidak ada sama sekali. Ini adalah tanda normal dari eksperimen yang jujur — tidak ditemukan obat mujarab yang universal, tetapi trennya konsisten.
Yang patut dicatat adalah bahwa yang membantu justru pemisahan fase yang eksplisit. Model yang hanya diminta "menganalisis sinyal" cenderung melompat ke perhitungan tanpa memastikan bahwa ia telah memahami datanya. Pengintaian sebagai langkah wajib yang terpisah memaksa untuk melihat terlebih dahulu, baru kemudian menghitung.
Apa implikasinya
Untuk praktik rekayasa, kesimpulannya cukup langsung: sebelum mempercayakan perhitungan berdasarkan pengukuran nyata kepada agen, ada baiknya mengujinya pada data tanpa petunjuk. Antarmuka yang nyaman dan jawaban yang mulus di chat tidak mengatakan apa pun tentang apakah model akan bertahan menghadapi hasil ekspor mentah dari penerima.
Ada pula gagasan yang lebih umum, yang melampaui ranah radio. Di bidang apa pun di mana penalaran bersandar pada pengukuran mentah — hidroakustik, getaran, telemetri — agen harus mampu terlebih dahulu menemukan besaran di dalam data, baru kemudian mengolahnya. Tabel dengan fitur menyembunyikan bagian pekerjaan ini, dan bersamanya tersembunyi pula kesalahan-kesalahan.
Keterbatasan dan langkah selanjutnya
Pertanyaannya belum bisa disebut sepenuhnya tertutup. 200 tugas — jumlah yang lumayan, tetapi tidak tak terbatas, dan generasi berdasarkan 11 jenis sinyal berarti rekaman lapangan nyata dengan segala artefaknya tetap tidak terwakili di sana. Evaluasi terhadap 14 model — potret sesaat, bukan vonis: komposisi pemimpin di bidang ini berubah dengan cepat.
Meski demikian, rumusan tugasnya tampak tepat. Jika kita ingin LLM bekerja bukan dengan rangkuman data, melainkan dengan datanya sendiri, kita harus mengujinya tepat di titik di mana petunjuk berakhir. EMRB melakukan persis itu — dan menunjukkan bahwa ruang untuk berkembang bagi model dalam pengintaian sinyal masih sangat besar.


