
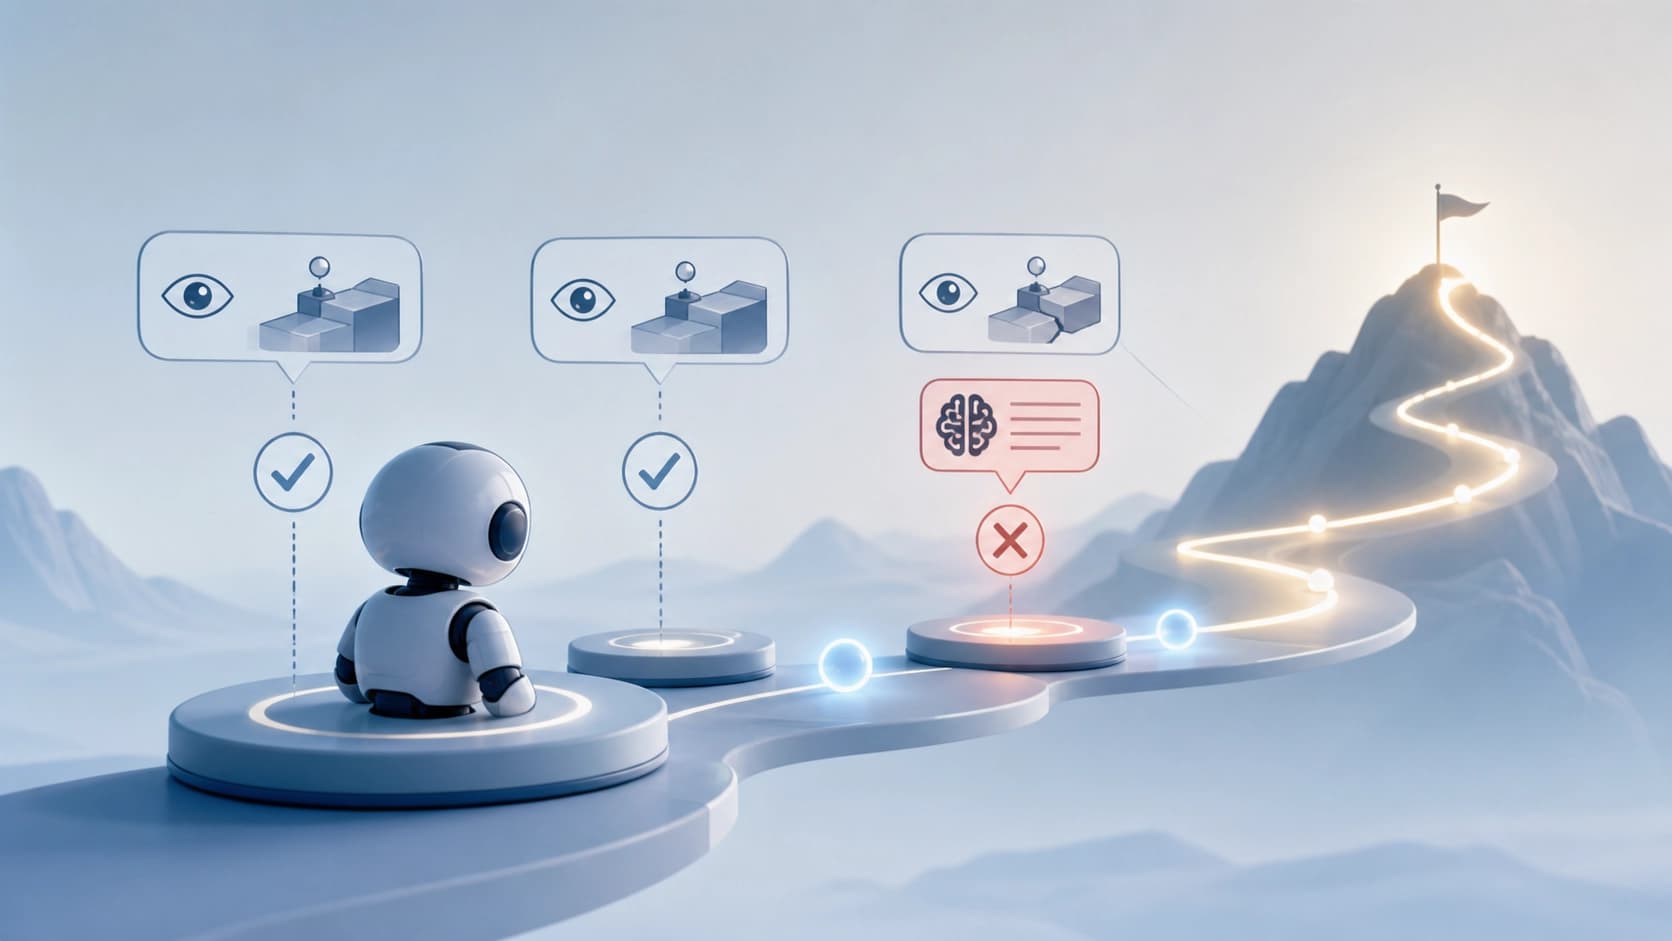
Masalah: satu reward untuk seluruh trajektori
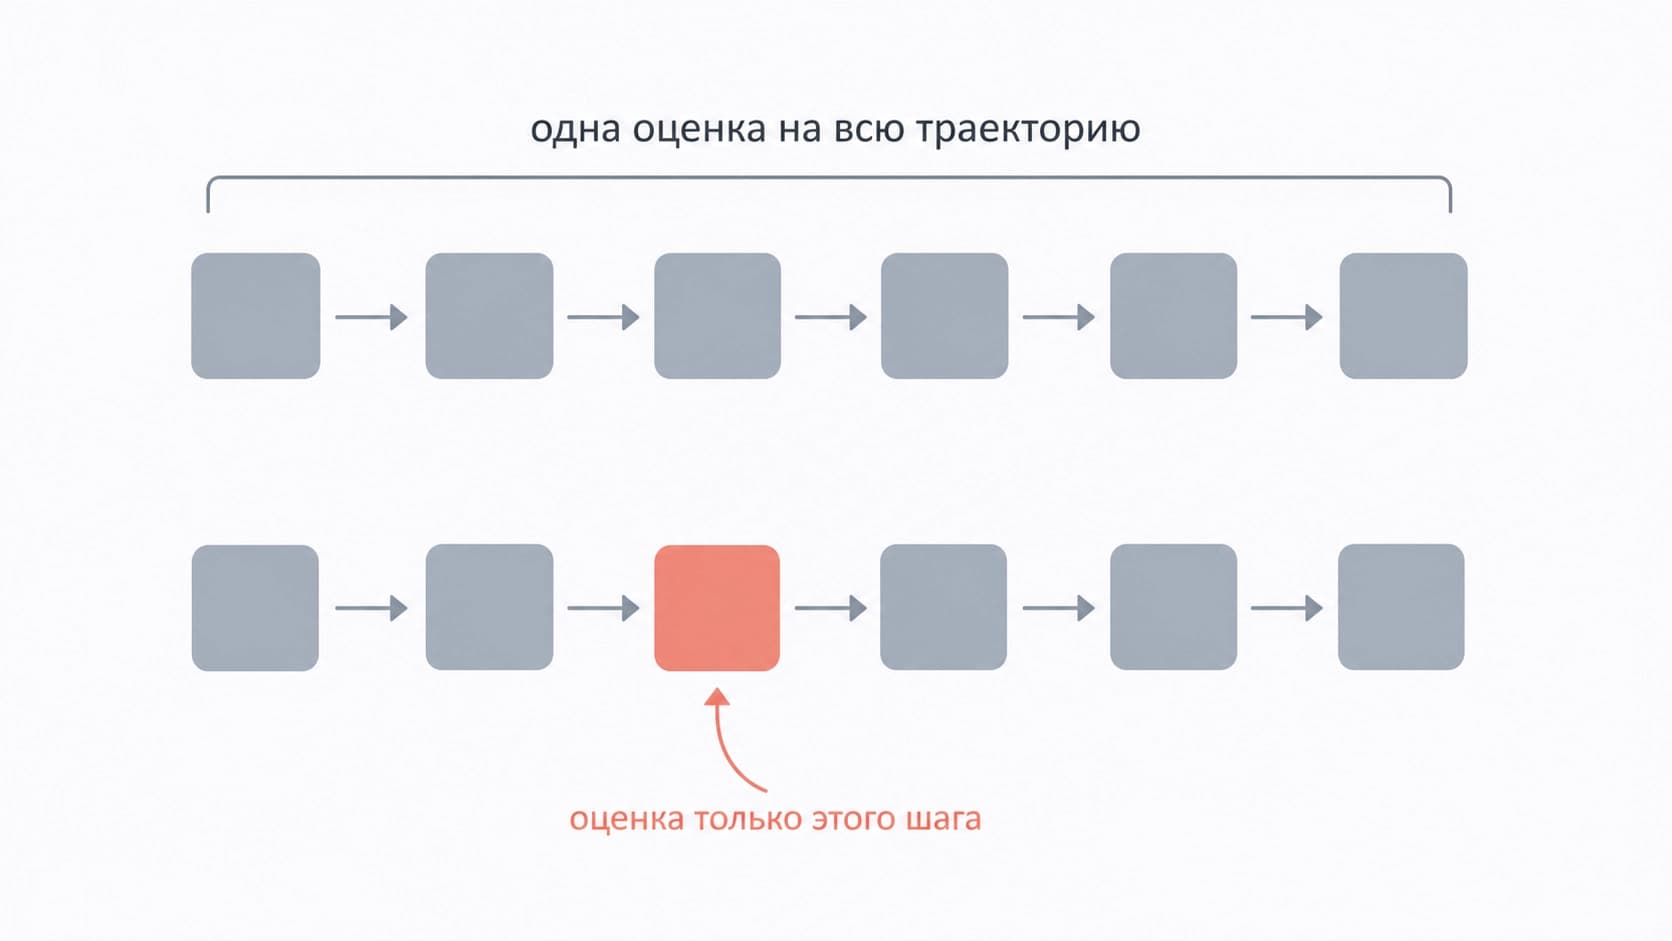
Agen multi-langkah berbasis LLM belajar melalui trial and error: menjalankan rangkaian tindakan, menerima penilaian akhir, lalu menyesuaikan perilaku berdasarkan penilaian itu. Masalahnya, penilaian ini biasanya diberikan untuk seluruh trajektori sekaligus. Agen mengetahui bahwa tugas berhasil atau gagal, tetapi tidak mengetahui pada langkah mana tepatnya segala sesuatunya mulai salah.
Selanjutnya muncul aritmetika yang kurang sejalan dengan akal sehat. Keunggulan yang sama diratakan ke semua langkah berturut-turut — baik pada pemilihan alat yang berhasil, pada salah ketik acak dalam kueri, maupun pada langkah rutin "konfirmasi tindakan". Akibatnya, model sekaligus memberi imbalan pada kesalahan acak dan pada langkah kerja yang wajar, asalkan hasil akhirnya sukses. Kredit atas keberhasilan dibagi rata ke semua, dan kesalahan atas kegagalan juga dibebankan ke semua.
Pengobatan klasiknya adalah self-distillation dengan informasi istimewa. Guru tahu lebih banyak daripada murid: ia memiliki akses ke lingkungan, ke sinyal antara, dan ke jawaban yang benar. Ia dapat memberi petunjuk pada setiap langkah, bukan hanya di akhir. Kedengarannya bagus, tetapi pendekatan ini menyimpan kelalaian tersembunyi: petunjuk yang sama diberikan ke semua langkah tanpa pandang bulu.
Asimetri langkah: rutinitas dan kesalahan membutuhkan hal yang berbeda
Gagasan kunci dari karya AHEAD adalah bahwa langkah-langkah dalam trajektori tidak setara, dan supervisi untuknya juga harus berbeda.
- Langkah rutin — membuka halaman, mengonfirmasi perpindahan, memanggil alat yang diperlukan — hampir tidak membutuhkan petunjuk. Model sudah mampu menanganinya. Bimbingan berlebih di sini hanya mengaburkan pembelajaran dan menghabiskan anggaran.
- Langkah kritis yang mengandung kesalahan — saat agen salah belok dan kehilangan peluang sukses — membutuhkan bukan sekadar pernyataan "di sini buruk", melainkan arahan konkret: apa yang seharusnya dilakukan sebagai gantinya.
- Umpan balik dari lingkungan sangat baik membumikan apa yang terjadi: ia memberi tahu apa yang sebenarnya terjadi. Tetapi ia tidak mampu menjelaskan bagaimana seharusnya bertindak. Sinyal "pintu tidak terbuka" tidak memberi petunjuk di mana kuncinya berada.
Jadinya, dua sumber supervisi saling melengkapi, tetapi tidak saling menggantikan. Umpan balik lingkungan memberikan sinyal yang padat dan jujur pada setiap langkah; petunjuk korektif yang dihasilkan model memberikan apa yang secara prinsip tidak ada dalam umpan balik lingkungan — niat dan alternatif. Mencampur keduanya secara membabi buta di seluruh trajektori berarti kehilangan kekuatan dari keduanya.
Bagaimana AHEAD disusun
Para penulis — Xiaolong Jin, Dingmin Wang, Vijay Lingam, dan Varun Kumar — mengusulkan kerangka kerja yang menyadari jenis langkah dan memilih sumber supervisi yang sesuai untuknya. Karya ini dipublikasikan di arXiv pada akhir Agustus 2026, rubrik cs.AI; panjangnya 22 halaman, 15 gambar, dan 7 tabel, jadi materinya cukup untuk detail.
Guru yang melihat lingkungan
Model guru menerima umpan balik lingkungan pada semua langkah — ini sinyal yang membumi dan padat, sama-sama tersedia baik pada bagian yang sukses maupun yang gagal. Guru semacam ini tidak berfantasi: ia bersandar pada apa yang benar-benar terjadi di lingkungan.
Petunjuk korektif — secara tepat sasaran
Di atas itu, guru menerima petunjuk yang dihasilkan LLM, tetapi tidak pada semua langkah, melainkan tepat pada langkah yang keliru. Logikanya sederhana: di tempat agen melakukan kesalahan, fakta dari lingkungan saja tidak cukup, diperlukan penjelasan ke arah mana seharusnya bergerak. Di tempat semuanya berjalan lancar, bimbingan tambahan tidak ditambahkan sama sekali.
Inilah "petunjuk tepat sasaran" dari namanya: bukan diratakan di seluruh trajektori, melainkan difokuskan pada titik-titik bermasalah. Pemetaan sumber supervisi yang sadar langkah alih-alih sinyal tunggal untuk seluruh rangkaian tindakan.
Perubahan minimal pada GRPO
Perlu dicatat secara khusus kesederhanaan rekayasa dari metode ini. GRPO — algoritma pembelajaran penguatan yang populer — tidak ditulis ulang dari nol: perubahan dilakukan secara tepat sasaran, di atas skema standar. Bagi praktisi ini penting, karena tidak menuntut pembangunan ulang seluruh pipeline pelatihan agen.
Apa yang ditunjukkan eksperimen
Evaluasi dilakukan pada tiga jenis tugas: ALFWorld — skenario multi-langkah dalam lingkungan teks, WebShop — interaksi dengan toko daring, dan tanya jawab pencarian. Tiga skala model diuji, sehingga kesimpulannya tidak terikat pada satu ukuran.
Hasil dibandingkan dengan GRPO biasa:
- +13,3 poin tingkat keberhasilan pada ALFWorld dengan model 7B;
- +11,0 poin pada WebShop dengan skala yang sama.
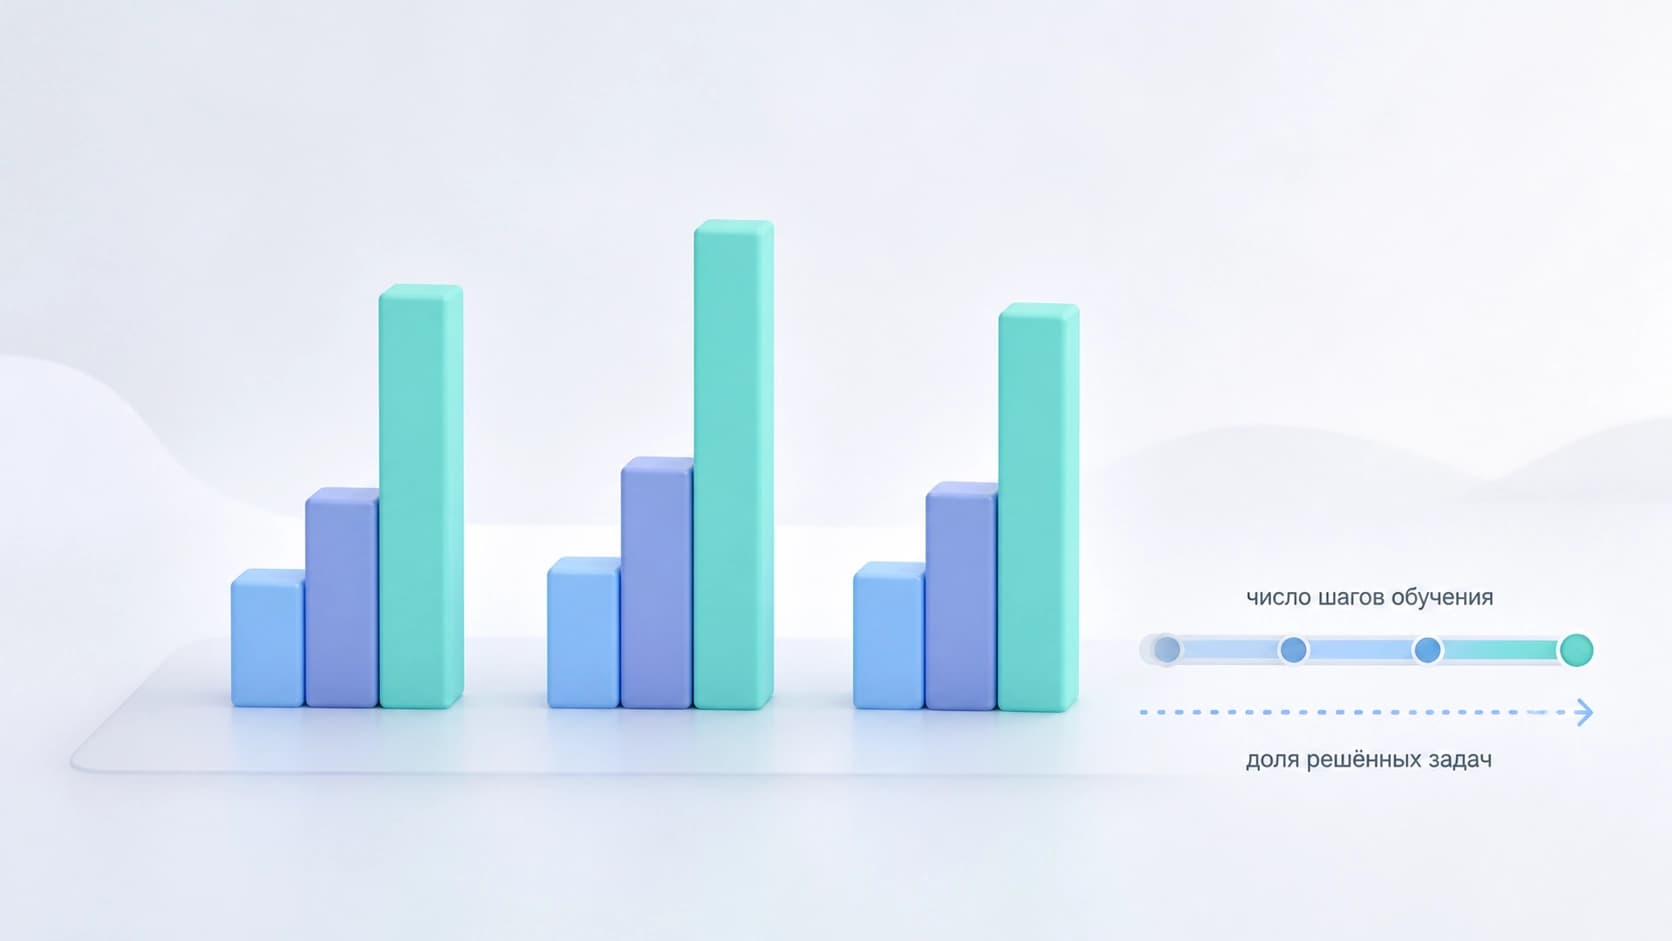
Selain angka absolut, ada dua efek yang tak kalah menarik. Pertama, tingkat keberhasilan yang ditargetkan dicapai dengan jumlah langkah pelatihan yang lebih sedikit — artinya metode ini bukan hanya lebih baik pada batasnya, tetapi juga lebih cepat mencapai kondisi kerja. Kedua, agen menyelesaikan tugas dalam anggaran interaksi yang lebih sempit dibandingkan pendekatan yang hanya berbasis reward akhir dan metode self-distillation sebelumnya.
Poin kedua, menurut saya, kurang dihargai. Penghematan langkah interaksi bukan sekadar metrik keindahan. Dalam skenario nyata, setiap pemanggilan alat memakan biaya, waktu, dan risiko. Agen yang mencapai tujuan dalam lima tindakan alih-alih sepuluh lebih berguna bukan sebesar 13 persen, melainkan berkali-kali lipat — terutama di tempat harga kesalahan itu tinggi.
Mengapa ini bekerja dan apa yang tetap tersembunyi
Penjelasan metode ini hampir bersifat pedagogis. Guru yang baik tidak mengomentari setiap gerakan murid — ia diam saat murid melakukan hal yang masuk akal, dan ikut campur tepat di tempat murid menyimpang dari jalan. Jika semua dikomentari, murid berhenti berpikir sendiri dan mulai menunggu petunjuk. Jika tidak ada yang dikomentari, ia akan mengulangi kesalahan yang sama.
AHEAD memformalkan intuisi ini dalam istilah pembelajaran penguatan: jenis langkah berbeda — sumber sinyal berbeda. Umpan balik yang padat dan membumi — sebagai latar, arahan korektif — sebagai aksen. Tidak ada sihir, hanya penolakan terhadap gagasan bahwa semua langkah setara.
Apa yang masih menjadi pertanyaan. Generasi petunjuk korektif itu sendiri membutuhkan model, yang berarti menambah biaya komputasi dan bergantung pada kualitasnya — jika guru menjelaskan secara keliru, murid akan menerima arahan yang meyakinkan tetapi salah. Masih terbuka juga sejauh mana metode ini dapat ditransfer ke tugas-tugas di mana harga langkah antara tidak begitu jelas seperti di ALFWorld atau WebShop, dan di mana "kekeliruan" suatu langkah tidak selalu dapat ditentukan segera, melainkan hanya dari konsekuensi yang tertunda.
Meski demikian, arahnya tampak sehat. Garis utama perkembangan metode agen beberapa tahun terakhir — bukan memperbesar model, melainkan mengelola sinyal pembelajaran dengan lebih cerdas. AHEAD — tepat dari garis ini: intervensi tepat sasaran alih-alih kontrol total.


