
Mengapa pemungutan suara berdasarkan keyakinan sama sekali berhasil
Ide yang akrab bagi siapa pun yang pernah membangun pipeline di sekitar model bahasa besar itu sederhana: jalankan tugas yang sama beberapa kali secara paralel, lalu pilih jawaban berdasarkan suara mayoritas. Tapi bukan mayoritas "datar", melainkan berbobot — setiap eksekusi mendapat bobot berdasarkan sinyal internal model, paling sering berdasarkan log-probabilitas token. Varian yang membuat model lebih yakin terdengar lebih lantang daripada yang lain.
Untuk penalaran satu langkah, skema seperti ini cukup baik: jika model salah, biasanya ia ragu, sedangkan jawaban yang benar disertai keyakinan tinggi. Selisih dalam log-probabilitas menjadi semacam detektor kesalahan bawaan, yang tidak memerlukan panggilan tambahan, anotasi, maupun model juri terpisah.
Runtuh di tempat yang sama saat dimulai: pada pencarian multi-langkah
Masalahnya, agen modern dibangun secara berbeda. Mereka tidak sekadar bernalar dalam satu lintasan: mereka merumuskan kueri, mengambil dokumen eksternal, menyematkannya ke dalam konteks, menyempurnakan kueri, dan seterusnya beberapa kali hingga mengumpulkan cukup materi untuk jawaban akhir. Setiap langkah menambahkan potongan teks asing ke jendela model.
Para penulis karya "Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding" (arXiv:2608.24024, diterima di Findings konferensi EMNLP 2026) — Hyunho Kook, Junhyuk So, Tianyu Fu, Haizhong Zheng, dan Beidi Chen — memeriksa apa yang terjadi pada pemungutan suara berdasarkan keyakinan dalam skenario ini. Hasilnya tidak menyenangkan: teknik yang sudah teruji pada tugas satu langkah tidak mudah ditransfer ke agen pencarian.
Mekanisme kegagalan: copy inflation
Penyebabnya para peneliti menyebutnya copy inflation — "penggembungan penyalinan". Ketika dokumen yang diambil masuk ke dalam konteks, token yang disalin model dari dokumen tersebut ke dalam jawabannya mendapat log-probabilitas yang secara sistematis terlalu tinggi. Menyalin adalah operasi yang mudah: melanjutkan teks yang terbaring tepat di depan mata secara statistik lebih sederhana daripada menghasilkan sesuatu sendiri. Model "yakin" pada token semacam itu bukan karena token itu benar, melainkan karena token itu benar-benar disalin.
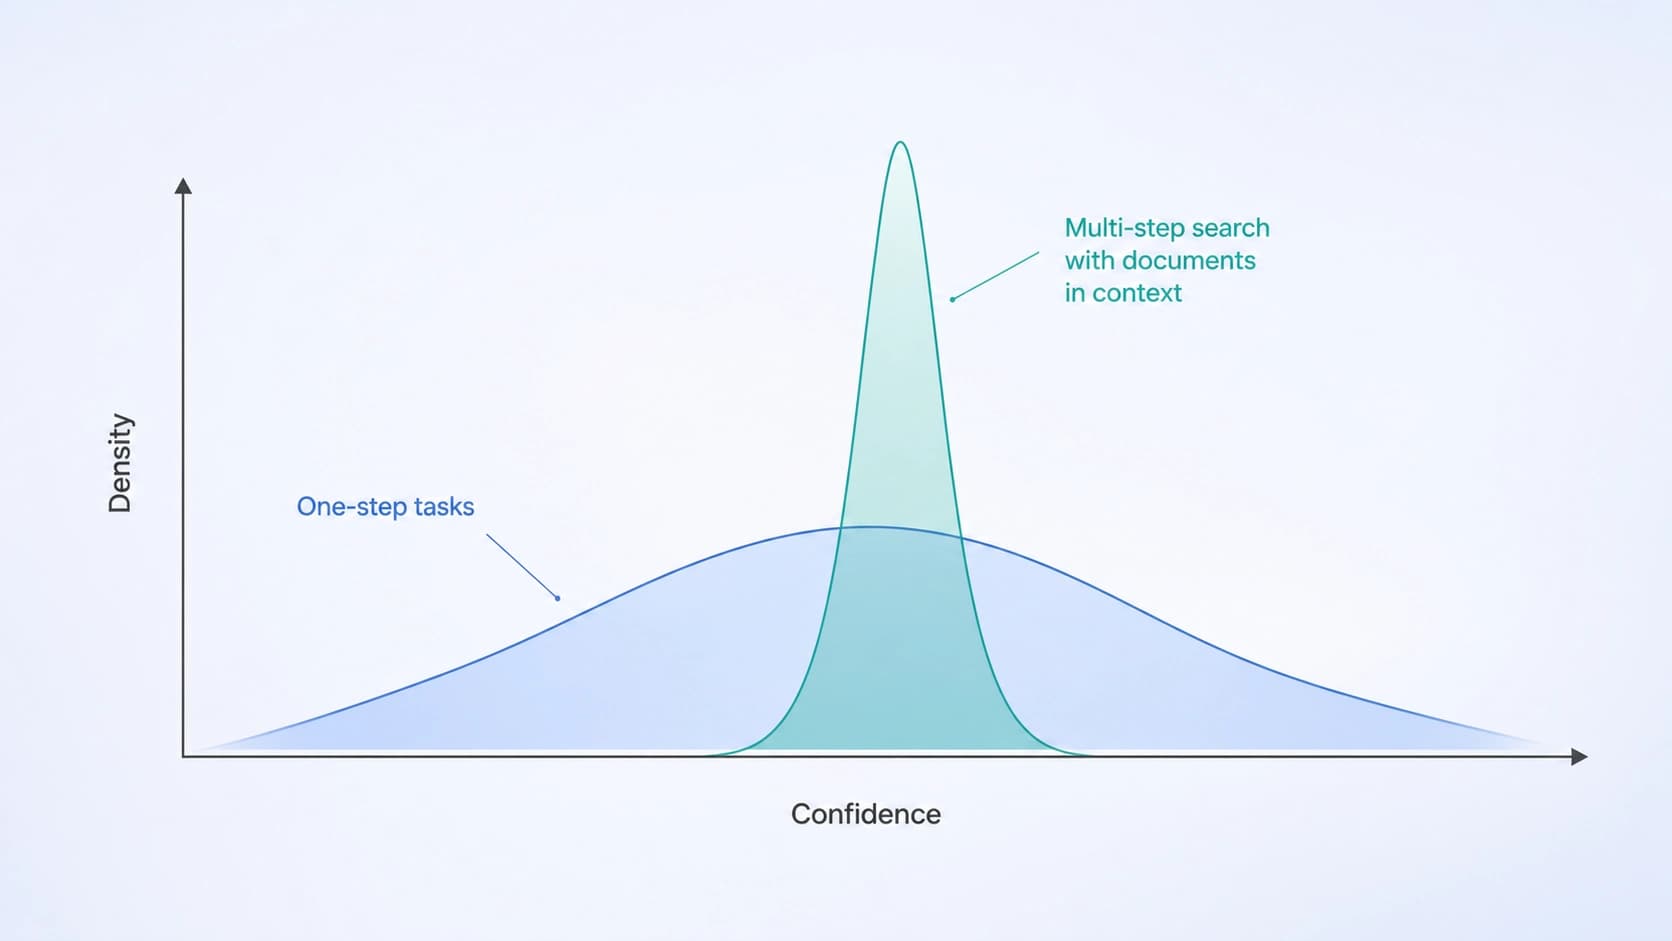
Selanjutnya efeknya menumpuk. Karena semua eksekusi dengan satu atau lain cara bersandar pada dokumen yang ditemukan, semuanya mendapat porsi probabilitas yang menggelembung. Penilaian keyakinan dalam satu pertanyaan menjadi setara, terkompresi ke rentang yang sempit — dan pemungutan suara berbobot kehilangan hal utama yang membuatnya ada: kemampuan membedakan eksekusi yang kuat dari yang lemah. Bobot menjadi hampir sama, dan agregasi merosot menjadi mayoritas biasa, hanya dengan beban komputasi berlebih.
Apa yang ditawarkan: Retrieval-Grounded Voting
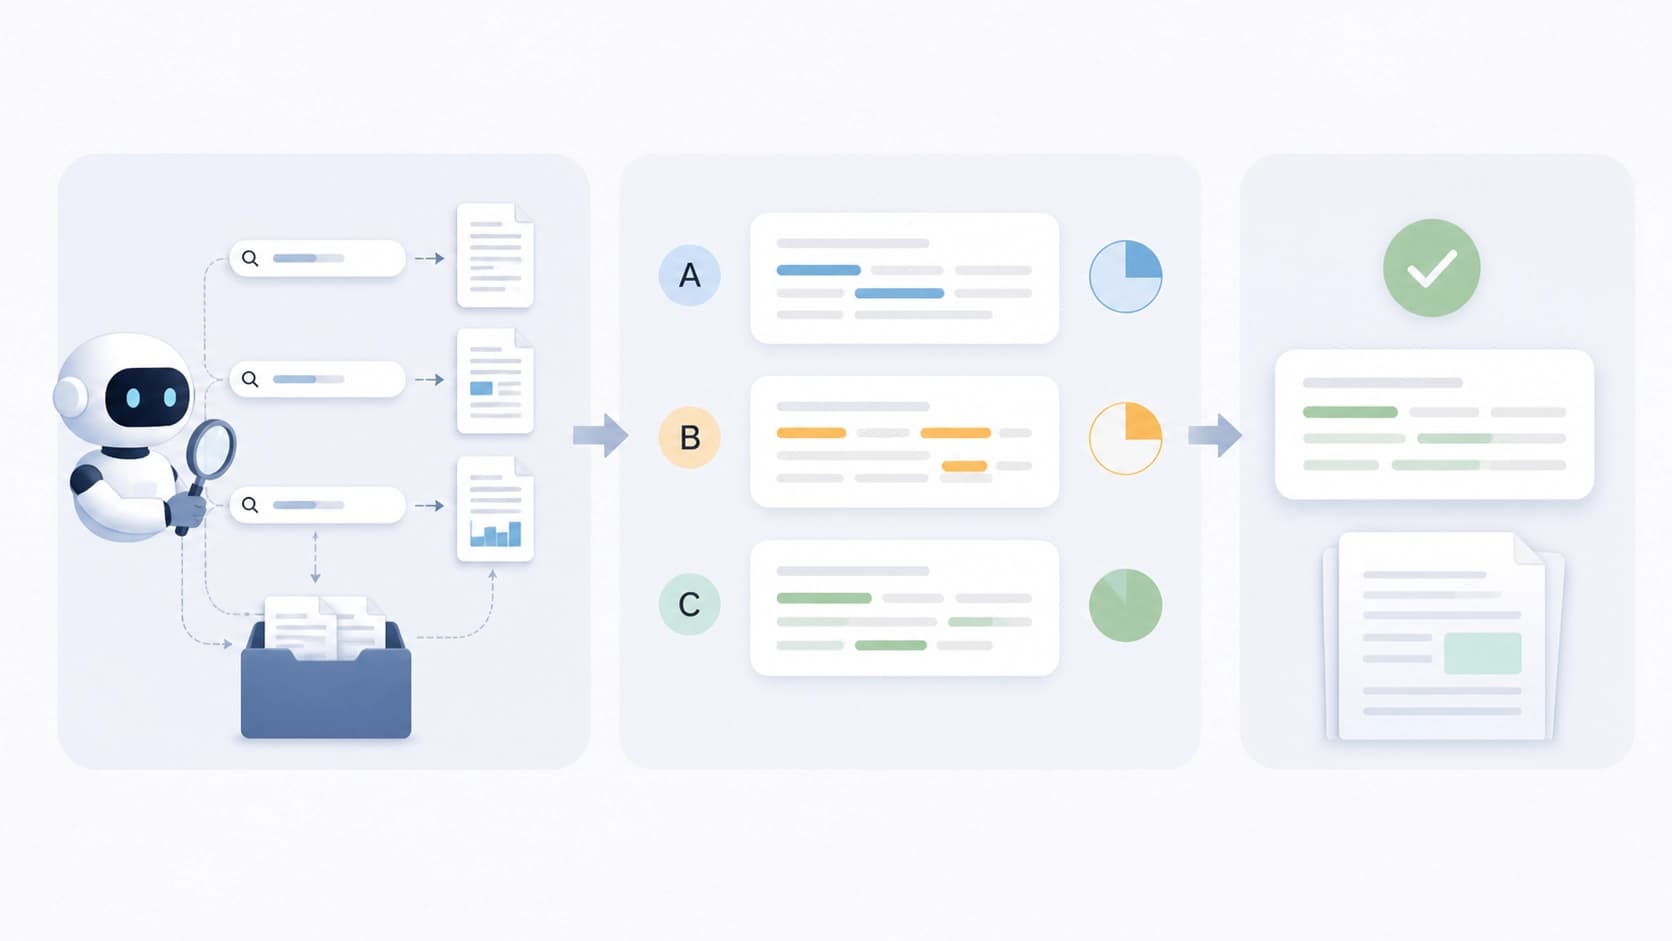
Sebagai pengganti, para penulis mengusulkan metode Retrieval-Grounded Voting (RGV). Metode ini juga menilai setiap eksekusi secara terpisah, tetapi tidak melihat ke dalam model, melainkan ke luar — pada keterkaitan jawaban akhir dengan dokumen-dokumen yang diambil oleh eksekusi itu sendiri.
Metriknya sengaja dibuat sederhana: irisan leksikal antara teks jawaban dan teks sumber yang diambil. Semakin kuat jawaban bersandar pada materi yang ditemukan, semakin tinggi skornya. Eksekusi yang mengarang sesuatu sendiri atau menyimpang akan berbagi lebih sedikit kata dengan dokumennya dan mendapat bobot lebih kecil.
Mengapa sinyal ini bekerja
Logikanya begini: jika agen benar-benar menemukan halaman yang relevan dan membangun kesimpulan di atasnya, rumusan jawaban pasti akan bersinggungan dengan rumusan sumber — istilah, nama, frasa. Ini bukan tanda ketepatan yang sempurna, tetapi ia stabil di tempat di mana log-probabilitas sudah rusak.
Keunggulan utama RGV — ia menghitung sinyal di luar konteks yang tercemar. Penilaian dibangun atas pasangan "jawaban — dokumen", bukan atas keadaan model pada saat generasi, sehingga copy inflation tidak memengaruhinya. Sekaligus metode ini tidak memerlukan akses ke log-probabilitas token dan tidak memerlukan panggilan tambahan ke LLM: tidak ada model juri, tidak ada lintasan kedua, hanya penghitungan irisan — operasi yang bisa dilakukan dengan kode biasa hampir tanpa biaya.
Hasil
Eksperimen dilakukan pada empat benchmark untuk agen pencarian dan lima model bahasa yang berbeda. Polanya berulang: RGV secara konsisten mengungguli pemungutan suara berdasarkan keyakinan.
Pengukuran paling menunjukkan adalah pada pertanyaan "minority-correct", di mana jawaban benar hanya muncul pada satu-dua eksekusi dari delapan. Di sinilah pembobotan berdasarkan keyakinan paling parah gagal: probabilitas yang menggelembung menarik pemungutan suara ke versi yang mayoritas tetapi salah. Peningkatan dari RGV pada pertanyaan semacam ini mencapai +35%, dan untuk akurasi secara keseluruhan hingga +5,4%.
Angka-angka ini perlu dibaca dengan catatan: ini bukan "tambah lima persen pada kualitas sistem pencarian apa pun", melainkan peningkatan prosedur agregasi dengan model dan kumpulan eksekusi yang tetap. Artinya, metode ini tidak mengubah apa pun pada agen itu sendiri — ia hanya memilih dengan lebih cermat dari apa yang sudah dihasilkan agen.
Apa artinya dalam praktik
Jika Anda membangun agen multi-langkah dan sudah menggunakan self-consistency atau pemungutan suara berbasis probabilitas apa pun, RGV memiliki tiga keunggulan praktis:
- Tidak memakan biaya inferensi. Panggilan model tambahan tidak diperlukan, bobot dihitung setelah fakta berdasarkan jawaban dan dokumen yang sudah ada.
- Bekerja dengan model tertutup. Log-probabilitas token tidak selalu tersedia, dan kadang sama sekali tersembunyi di balik API. Perbandingan teks bebas dari keterbatasan ini.
- Dapat di-debug secara terprediksi. Metriknya transparan: Anda bisa melihat kata mana yang menghasilkan kecocokan, dan memahami mengapa sebuah eksekusi mendapat bobot seperti itu.
Di mana metode ini bisa tersandung
Titik lemahnya jelas dari konstruksinya sendiri: irisan leksikal memberi imbalan pada kecocokan kata, bukan kecocokan makna. Jawaban yang diparafrase tetapi benar akan mendapat bobot yang tidak adil rendah; hasil numerik atau ringkasan singkat juga hampir tidak akan bersinggungan dengan teks sumber, bahkan jika sepenuhnya sesuai dengannya. Situasi sebaliknya bahkan lebih tidak menyenangkan: eksekusi yang sekadar mengutip panjang lebar apa yang ditemukan akan meraih skor tinggi tanpa menambahkan apa pun pada solusi.
Dari sini muncul strategi yang masuk akal — memandang RGV bukan sebagai pengganti semua sinyal, melainkan sebagai suara tambahan yang justru paling berguna di tempat di mana keyakinan model berhenti bermakna apa pun. Masuk akal juga untuk menggabungkannya dengan pemeriksaan jenis lain: perbandingan makna, penilaian oleh model terpisah, verifikasi berbasis fakta. Para penulis, dilihat dari rumusan masalahnya, bergerak tepat ke arah ini — dari "mempercayai perasaan internal model" menuju "menilai apa yang benar-benar dilakukannya".
Kesimpulan
Kisah copy inflation adalah ilustrasi yang baik dari masalah umum pipeline agen: teknik yang teruji secara terisolasi pada satu model dengan satu langkah penalaran diam-diam runtuh ketika pencarian, konteks, dan teks asing ditambahkan ke dalam siklus. Keyakinan model berhenti menjadi ukuran ketepatan dan berubah menjadi ukuran kemudahan penyalinan.
RGV menawarkan jalan memutar yang tampak hampir membosankan — menghitung irisan kata antara jawaban dan sumber. Tetapi justru kebosanan inilah yang membuat metode ini menarik: murah, transparan, tidak memerlukan bagian dalam model, dan memberikan keuntungan yang nyata di tempat di mana jawaban benar tenggelam dalam kebisingan. Bagi tim yang membangun agen pencarian dari API siap pakai, ini adalah kasus langka peningkatan yang berguna, yang tidak memerlukan pelatihan ulang maupun anggaran inferensi baru.


