
Vektor molekuler sebagai infrastruktur
Dalam kimia komputasi, embedding molekul sudah lama bukan lagi sekadar detail teknis. Ini adalah infrastruktur yang dapat digunakan kembali: representasi vektor yang sama melayani prediksi sifat senyawa, penyaringan virtual, dan pencarian molekul serupa. Hitung sekali — terapkan dalam puluhan skenario, dari peringkat pustaka hingga pemilihan kandidat untuk laboratorium.
Jalan buntu satu representasi
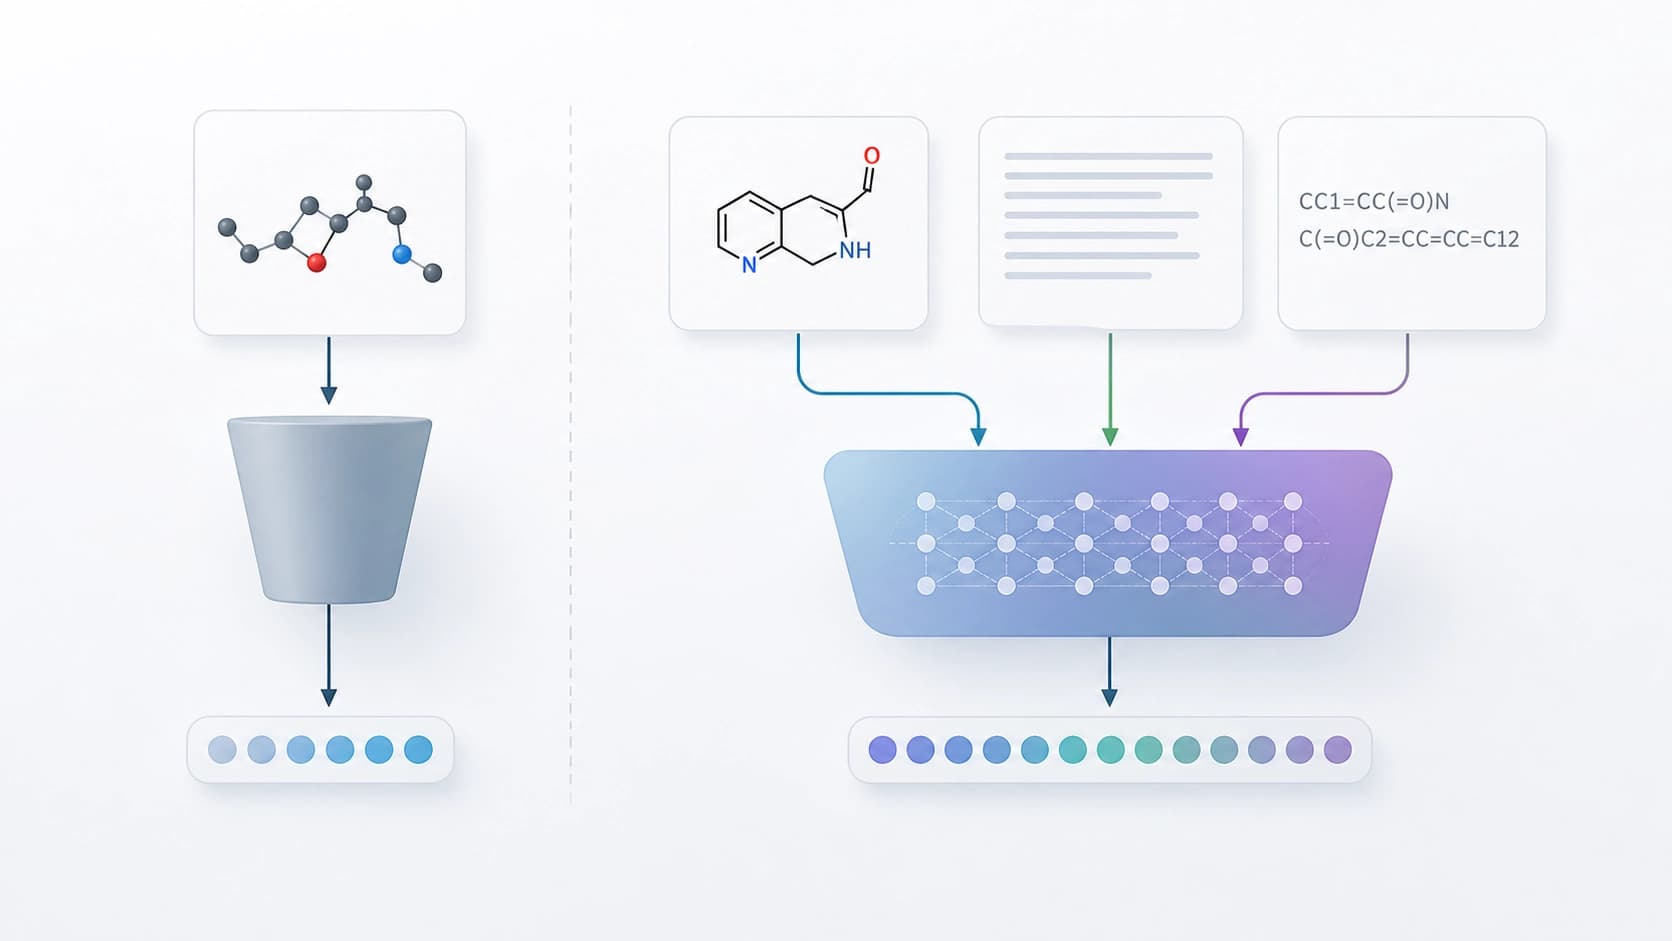
Hampir semua encoder molekul dibangun dengan satu skema: dipilih satu modalitas tunggal — graf atom, string SMILES, kumpulan deskriptor fisikokimia, atau konformasi 3D — dan model dilatih secara ketat pada modalitas itu. Vektor yang dihasilkan bersifat tanpa syarat. Tidak ada antarmuka untuk memperjelas permintaan: "butuh analog berdasarkan mekanisme aksi, bukan berdasarkan kerangka karbon" atau "senyawa serupa, tetapi dengan fokus pada kelarutan".
Dari sini muncul efek yang tidak menyenangkan. Molekul yang sama dilihat secara berbeda oleh model yang berbeda, dan representasi mereka tidak dapat dibandingkan secara langsung — ruangnya tidak selaras. Kimiawan pun terpaksa mengingat encoder mana yang cocok untuk tugas apa, alih-alih cukup merumuskan tugas dengan kata-kata.
Pertanyaan yang diajukan para penulis
Karya Xinjian Zhao, Xiangru Jian, Yaoyao Xu, Xiaozhuang Song, Wei Pang, Lei Bai, dan Tianshu Yu (arXiv:2608.23646, 24 Agustus 2026; dipresentasikan di workshop FM4LS dalam ICML 2026, non-archival) dimulai justru dari ketidakpuasan ini. Para peneliti bertanya: mengapa harus membangun encoder terpisah untuk setiap representasi molekul, jika LLM multimodal sudah mampu bekerja secara native dengan gambar, teks, dan notasi simbolik?
Logikanya sederhana. Jika model sudah "melihat" gambar rumus struktur, membaca deskripsi, dan mengurai SMILES, ia dapat diubah bukan menjadi asisten-konsultan, melainkan menjadi generator vektor. Terlebih lagi vektor yang terkondisi — bergantung tidak hanya pada molekul itu sendiri, tetapi juga pada apa yang ditanyakan tentangnya dalam bahasa alami.
Bagaimana kerangka kerja ini dibangun
MolEmb adalah lapisan tambahan yang ringan, bukan model besar baru. Ia mengadaptasi MLLM yang sudah ada agar profil molekul dan deskripsi tekstualnya berada dalam satu ruang embedding yang sama. Elemen kuncinya adalah tujuan kontrastif dua arah: ia mendekatkan pasangan "molekul — teks" dan sekaligus menjauhkan pasangan yang tidak cocok.
Mengapa ini lebih penting dari yang terlihat
Pembelajaran kontrastif di sini menyelesaikan dua tugas sekaligus. Pertama, ia menetapkan sistem koordinat bersama: vektor molekul dan vektor deskripsinya menjadi dapat dibandingkan. Kedua, ia memungkinkan pencarian lintas modalitas dua arah — dari molekul menemukan teks, dari teks menemukan molekul, dan semuanya dalam ruang yang sama, tanpa penerjemah perantara antar modalitas.
Hasil yang diklaim lebih sederhana daripada "mengalahkan semua benchmark", dan justru karena itu lebih masuk akal: representasi yang dihasilkan kompetitif dalam prediksi sifat molekul dan sekaligus mendukung pencarian antar modalitas. Artinya, antarmuka bahasa tidak dibeli dengan harga degradasi tugas-tugas klasik.
Bahasa sebagai tuas kendali
Perbedaan utama dari encoder tradisional terletak pada pengondisiannya. Model khusus menghasilkan satu vektor tetap untuk sebuah molekul. Kerangka kerja ini memungkinkan perumusan kondisi dengan kata-kata dan memperoleh representasi yang bergeser ke arah kondisi tersebut. Molekul yang sama dapat direpresentasikan secara berbeda tergantung apakah Anda tertarik pada toksisitas, kelarutan, atau kedekatan dengan kelas senyawa tertentu.
Pencarian molekul yang bergantung pada konteks
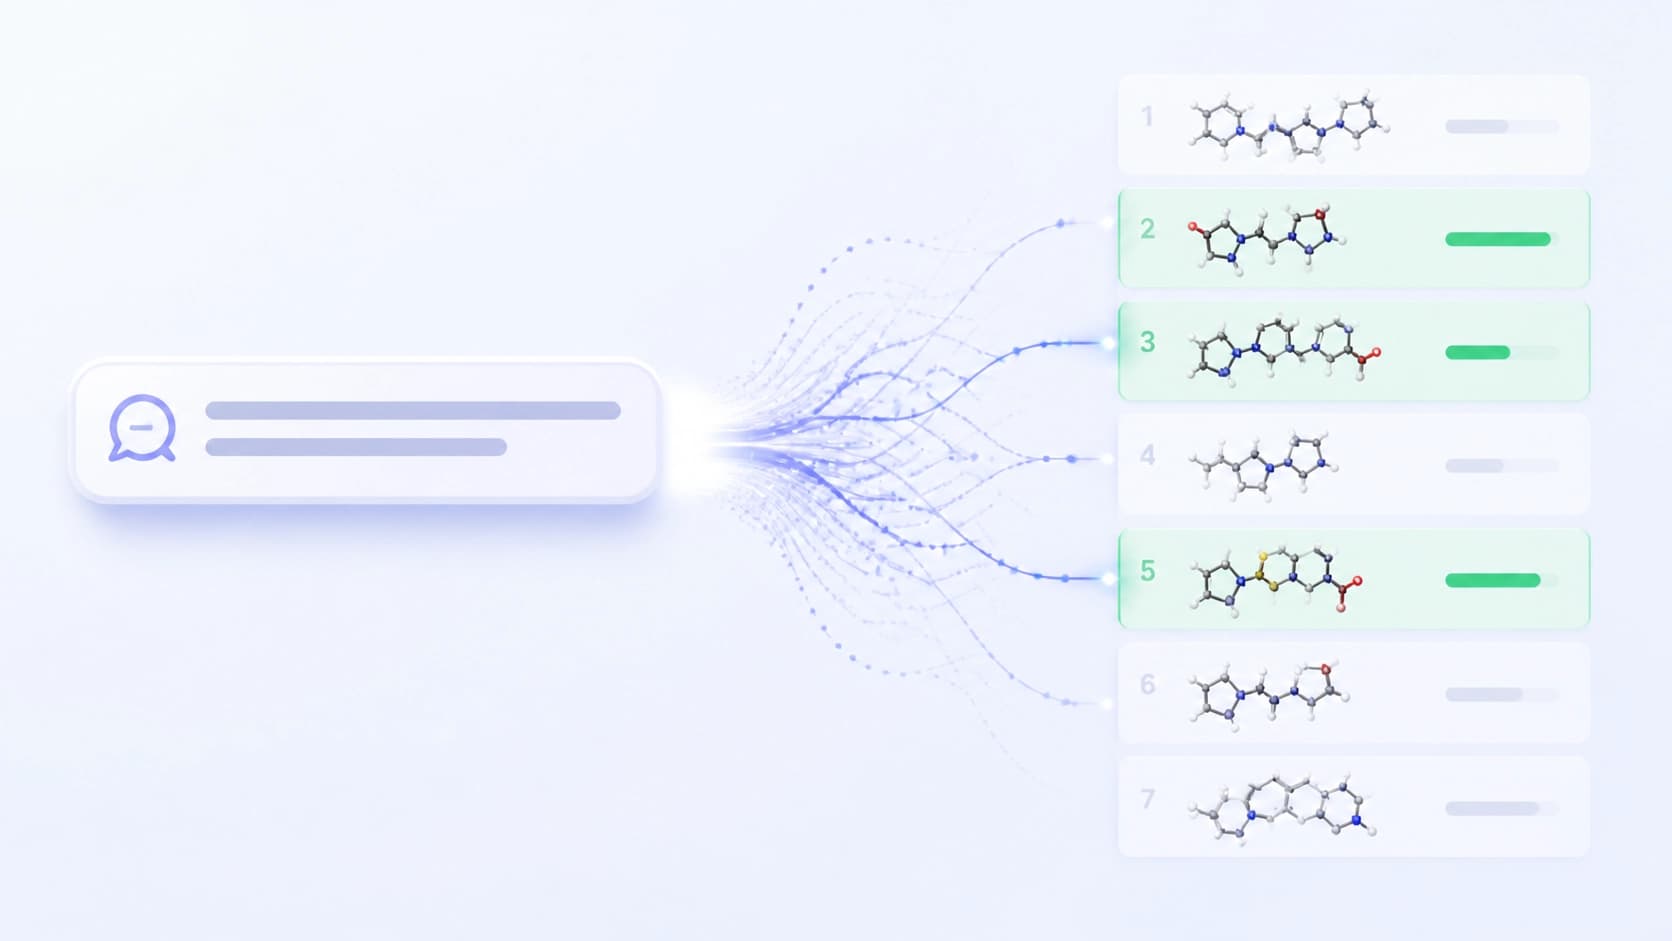
Bagian tersendiri dari karya ini adalah benchmark diagnostik MolCAR. Ia dibuat untuk menguji pencarian yang bergantung pada konteks, yaitu situasi ketika jawaban yang benar berubah tergantung pada rumusan permintaan. Ini secara prinsip lebih sulit daripada pencarian struktur serupa klasik: di sana acuannya satu, di sini acuannya bergantung pada perumusan tugas.
Temuan paling menarik
Mungkin observasi paling berharga dari para penulis terdengar hampir biasa: embedding molekul yang bergantung pada konteks terutama merupakan sifat data supervisi, bukan trik arsitektur. Dengan kata lain, model mulai membedakan konteks bukan karena ada modul canggih yang ditanamkan ke dalamnya, melainkan karena ia dilatih pada pasangan di mana konteksnya memang berbeda.
Kesimpulannya menyadarkan sekaligus berguna. Ia menggeser fokus dari perlombaan arsitektur ke kualitas dan struktur data pelatihan: jika deskripsi molekul dalam dataset seragam, tidak ada multimodalitas yang akan memberi model kepekaan terhadap nuansa permintaan.
Apa yang ini ubah dalam praktik
Jika pendekatan ini dapat diskalakan, keuntungannya terlihat seperti ini:
- Infrastruktur tunggal alih-alih kebun binatang encoder. Satu model menangani sifat, pencarian, dan permintaan lintas modalitas.
- Permintaan dengan kata-kata alih-alih memilih model. Pengguna tidak perlu tahu encoder mana yang terbaik untuk kasusnya.
- Ruang yang kompatibel. Vektor molekul dan teks hidup bersama, sehingga dapat dibandingkan dan dikombinasikan.
- Penggunaan kembali MLLM yang sudah ada. Kerangka kerja ini mengadaptasi model yang ada, bukan melatih dari nol.
Batas dan pertanyaan terbuka
Karya ini ditandai sebagai non-archival, yang berarti ini lebih merupakan arah daripada produk jadi. Masih banyak pertanyaan: seberapa tangguh pendekatan ini di luar kumpulan data yang telah diuji, bagaimana perilakunya pada kelas senyawa langka, apakah bagian bahasa mulai mendominasi bagian kimia dan apakah ini mengubah vektor menjadi parafrase teks, bukan representasi yang bermakna secara fisik.
Meski demikian, gagasan utamanya dirumuskan dengan jelas. LLM multimodal bukan hanya asisten kimia dan bukan hanya generator jawaban. Mereka mengklaim peran sebagai mekanisme umum embedding molekul: yang dapat diperluas, dikendalikan dengan kata-kata, dan terbuka untuk pelatihan lanjutan sesuai tugas baru.


