
Protokol yang tidak dijalankan siapa pun secara harfiah
Protokol laboratorium jarang dijalankan secara harfiah. Antara publikasi dan eksperimen nyata hampir selalu ada adaptasi: lini sel yang berbeda, reagen yang diganti, sampel lebih sedikit, alat milik orang lain, anggaran yang dipangkas. Bagi orang yang bekerja di meja basah, ini rutinitas, tetapi rutinitas yang berbahaya — setiap perubahan menarik rantai konsekuensi. Kamu mengubah volume reagen pada langkah awal, dan kamu harus mengingat apa dampaknya pada tahap pencucian dan bagaimana itu selaras dengan apa yang sudah dilakukan sebelumnya. Kemampuan inilah — menyimpan seluruh protokol di kepala dan mengubahnya secara bermakna — yang diuji oleh kumpulan tugas baru ini.
Penelitian ini terbit dengan judul BenchBench-Protocol dalam pracetak arXiv:2608.23898v1 (cs.AI), yang diajukan pada 24 Agustus 2026. Penulisnya adalah Aditya Sivakumar, Ashu Singhal, Nicholas Larus-Stone, dan Nithin Parsan. Ini terdiri dari 21 halaman dan 15 gambar, jadi materinya lebih bersifat metodologis daripada promosional.
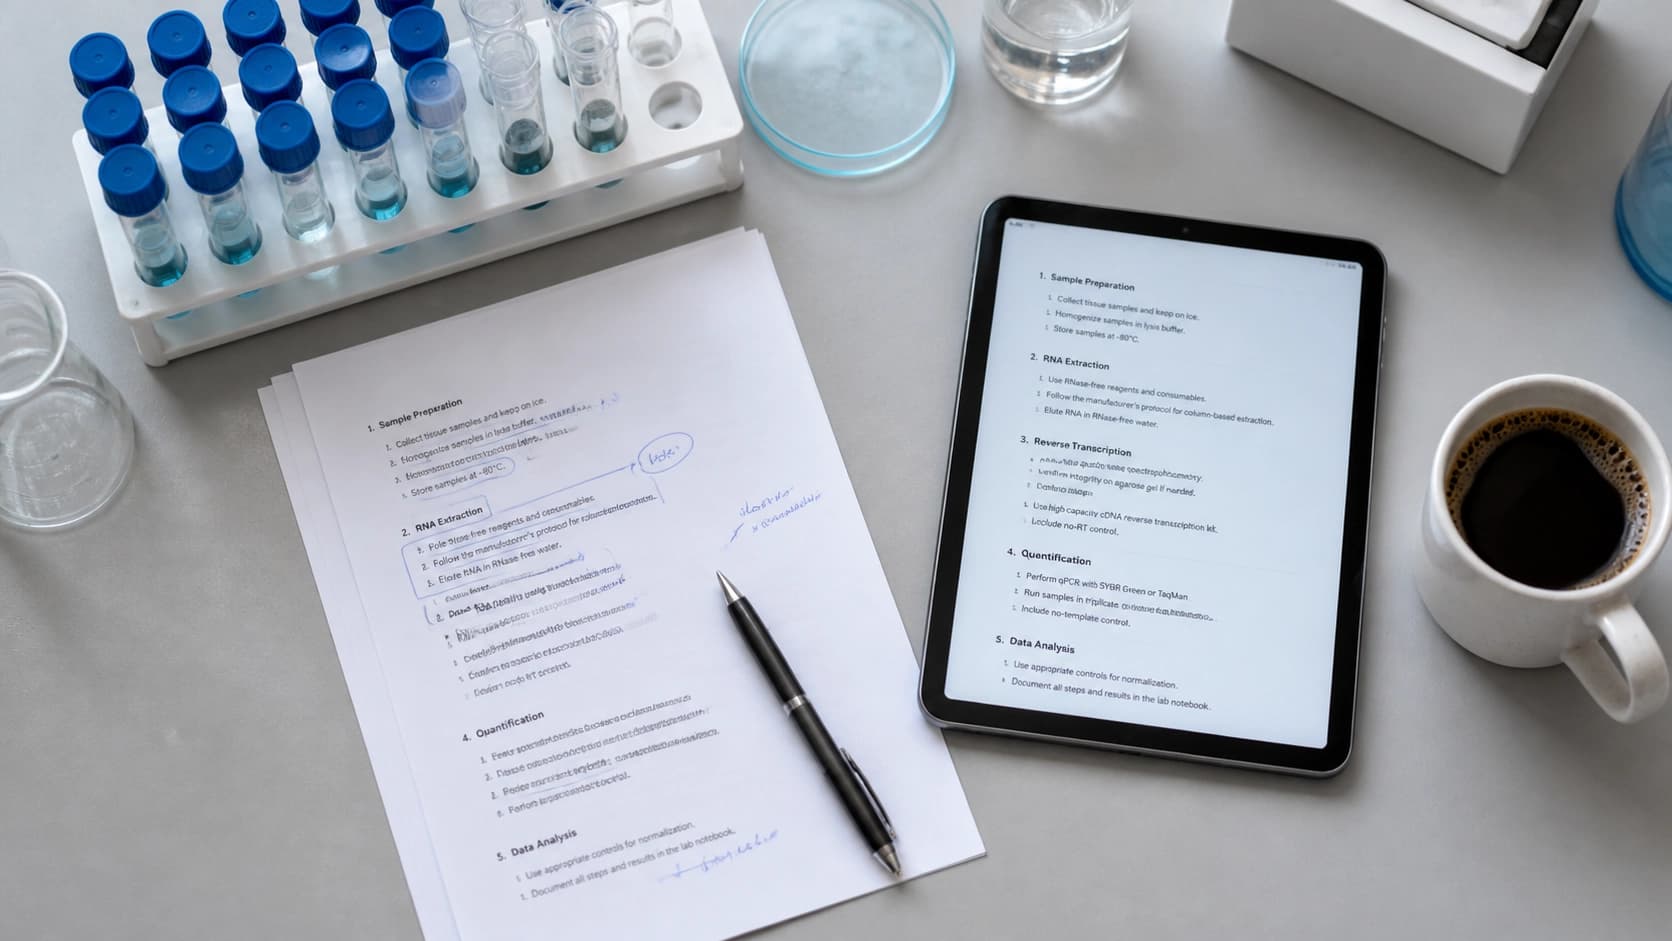
Bagaimana 149 tugas dirakit dari draf revisi
Mekanisme BenchBench-Protocol tidak biasa. Penulis tidak duduk menulis pertanyaan — mereka mengambil jejak kerja yang sudah ada. Setiap protokol yang dipublikasikan memiliki versi yang disunting ilmuwan untuk eksperimen spesifiknya. Perbedaan antara kedua dokumen inilah yang menjadi tugas: model ditunjukkan protokol asli dan kondisi eksperimen baru, lalu model harus mengusulkan modifikasi yang tepat.
Dari pendekatan ini langsung muncul detail penting: tugas ini tidak memiliki "jawaban benar" yang abstrak, melainkan rubrik berbobot. Sebab revisi yang dilakukan peneliti sungguhan sudah diketahui — revisi itu bisa diuraikan menjadi elemen-elemen dan dinilai seberapa jauh usulan model sesuai dengan solusi nyata secara makna, bukan secara rumusan. Ini menghilangkan masalah abadi tes biomedis, di mana model bisa memberi jawaban yang masuk akal tetapi tidak cocok dengan acuan dan mendapat nilai nol.
Basisnya pun solid: 96 protokol asli dari sembilan bidang biologi eksperimen laboratorium basah. Hanya tugas yang lolos pemeriksaan ahli dengan penilaian tinggi yang masuk ke kumpulan akhir — sisanya disaring. Hasilnya adalah 149 tugas tersebut.
Mengapa ini bukan sekadar kumpulan pertanyaan dari para ahli
Penulis secara khusus menjelaskan konteksnya. Dalam beberapa tahun terakhir, tolok ukur biomedis memang bergeser ke arah tugas terbuka dengan penilaian berbasis rubrik — ini kemajuan. Namun tugasnya sendiri masih sering dibuat oleh ahli: mereka duduk dan menulis pertanyaan berdasarkan pengalaman mereka. Pendekatan ini terbatas karena ahli menjawab pertanyaan yang ia sendiri rumuskan, sehingga secara implisit menyesuaikan diri dengan gagasannya sendiri tentang tingkat kesulitan.
Di sini logikanya terbalik. Tugas muncul di tempat di mana orang nyata sudah berhadapan dengan masalah nyata dan menghabiskan waktu untuk menyelesaikannya. Ini tidak menjamin kemurnian data yang sempurna, tetapi menjamin bahwa soalnya tidak dibuat-buat demi rumusan yang indah.
Siapa yang berhasil, siapa yang tidak
Sembilan model ikut serta dalam pengujian — baik tertutup maupun terbuka. Sebarannya cukup mencolok, meski tidak dramatis.
Hasil terbaik ditunjukkan Claude Opus 5 — 59,2% skor ternormalisasi menurut rubrik. Model lainnya berada dalam rentang 34,1% hingga 47,1%. Sederhananya, tidak ada yang menyamai pemimpinnya, tetapi juga tidak ada kegagalan hingga setengahnya: semua model bisa melakukan sesuatu, hanya saja caranya berbeda-beda dan tidak selalu tuntas.
Baris terpisah dalam laporan adalah uji saturasi. Penulis memberi model sepuluh percobaan dan memilih yang terbaik (best-of-10). Bahkan dengan skema yang begitu longgar, tolok ukur ini tidak "runtuh": plafonnya belum tercapai. Bagi penilaian ini kabar baik — artinya kumpulan tugas ini tidak akan usang setelah generasi model berikutnya muncul.
Apa implikasinya dalam praktik
Kesimpulan pertama bersifat terapan dan agak menyadarkan. Mempercayakan sepenuhnya adaptasi protokol kepada model bahasa untuk saat ini belum bisa. Bahkan hasil terbaik sebesar 59,2% berarti bahwa kira-kira dalam empat dari sepuluh kasus, usulan tersebut memerlukan campur tangan manusia. Model berguna sebagai draf, sebagai penghasil opsi, sebagai cara cepat memeriksa apa yang mungkin terlewat olehmu. Tetapi tanggung jawab akhir atas tabung reaksi tidak diembannya.
Kesimpulan kedua bersifat metodologis, dan ini lebih menarik daripada yang pertama. Penulis memandang karya mereka bukan hanya sebagai penilaian penalaran di laboratorium basah, tetapi juga sebagai bukti gagasan yang lebih umum: eksperimen nyata adalah sumber tugas yang diremehkan untuk tolok ukur. Jika di laboratorium sudah ada riwayat revisi, berarti ada pula bahan untuk menguji model — bahan yang mustahil diciptakan di meja tulis.
Kesimpulan ketiga menyangkut arah selanjutnya. Perbedaan antara 59,2% dan 47,1% tidak tampak seperti jurang mengingat kompleksitas tugasnya sendiri. Ini lebih merupakan petunjuk bahwa hambatan utamanya bukan pada banyaknya pengetahuan model tentang biologi, melainkan pada kemampuan menyusun rantai: mempertimbangkan keputusan sebelumnya dan memprediksi apa dampaknya pada langkah berikutnya. Justru kualitas inilah, bukan penghafalan fakta, yang menjadi fokus kumpulan 149 revisi ini.


