
Problem: jejak agen adalah log, bukan model perilaku
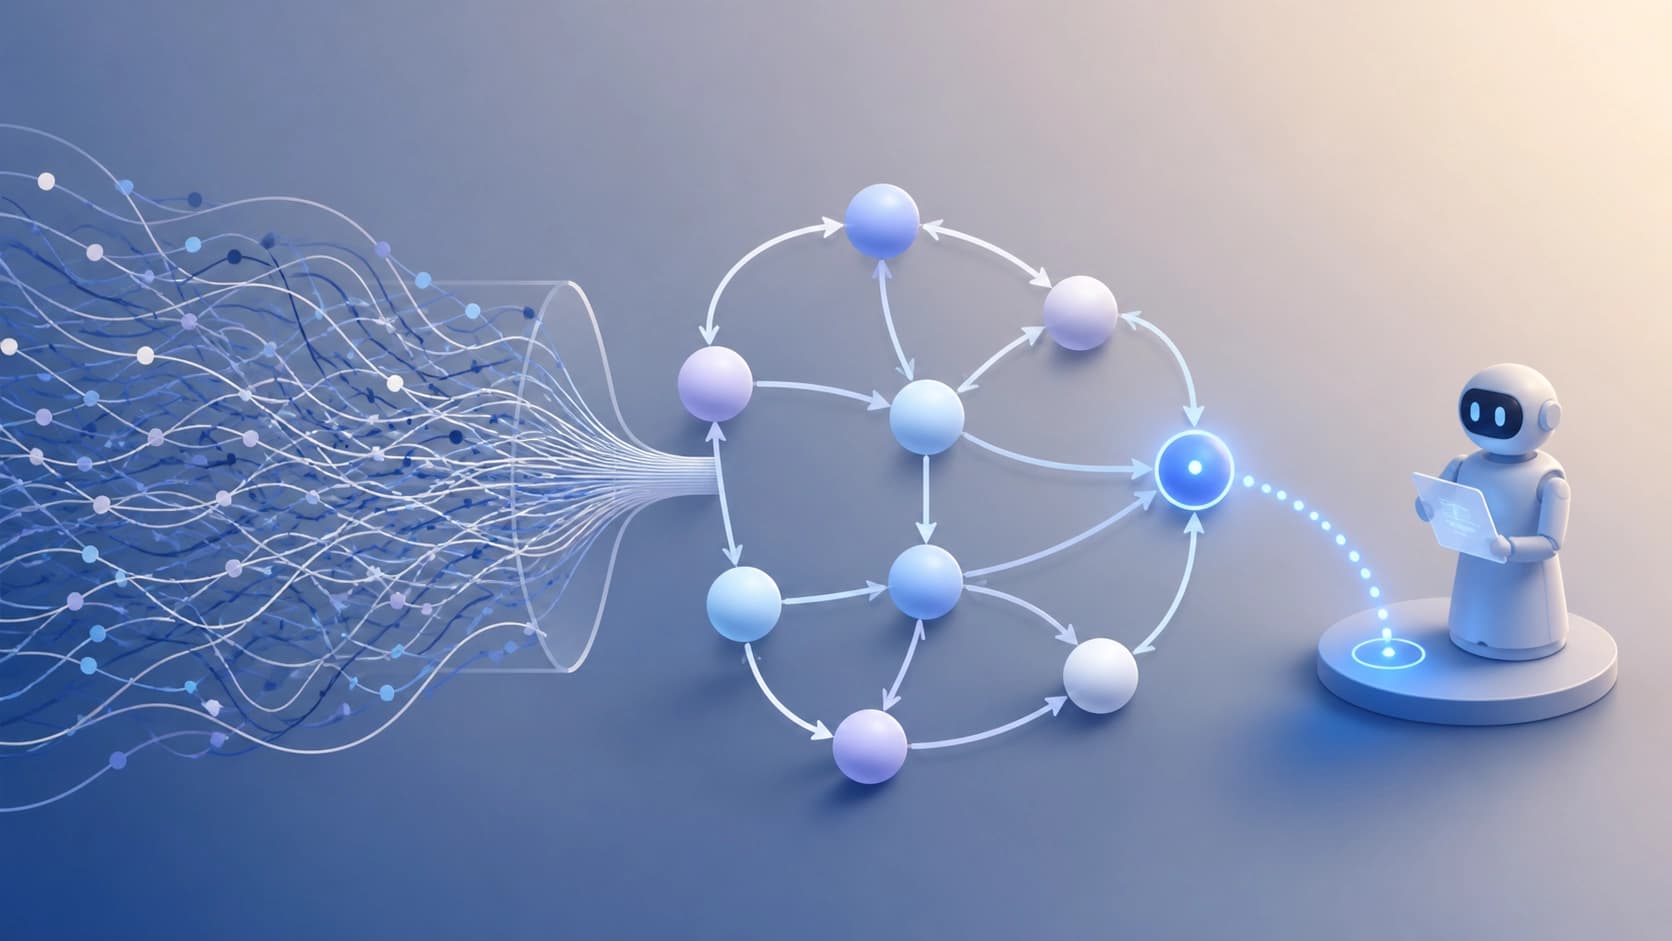
Agen LLM multi-langkah meninggalkan jejak yang panjang: pemanggilan alat, penalaran perantara, koreksi, percobaan ulang. Membacanya dengan mata hampir tidak ada gunanya — ratusan baris teks, di mana sinyal yang berguna tersebar di seluruh volume. Bagi pengembang yang meluncurkan agen ke produksi, log semacam itu berubah menjadi kotak hitam: tidak jelas di mana tepatnya proses berjalan salah, maupun keadaan apa yang umumnya tipikal untuk sistem.
Justru tentang hal inilah karya arXiv:2608.23670 (cs.AI) «Automata from Agent Traces: Failure and Next-Step Prediction» — para penulisnya, Seonglae Cho, Franklin Cardenoso Fernandez, Umar Mohammed, Zekun Wu, Kleyton Da Costa, Ilham Wicaksono, dan Adriano Koshiyama, mengusulkan untuk memandang jejak bukan sebagai teks, melainkan sebagai data tentang transisi antar keadaan. Logikanya sederhana: jika perilaku agen berulang dari satu eksekusi ke eksekusi berikutnya, berarti di balik kekacauan lahiriah terdapat struktur, dan struktur itu dapat direkonstruksi.
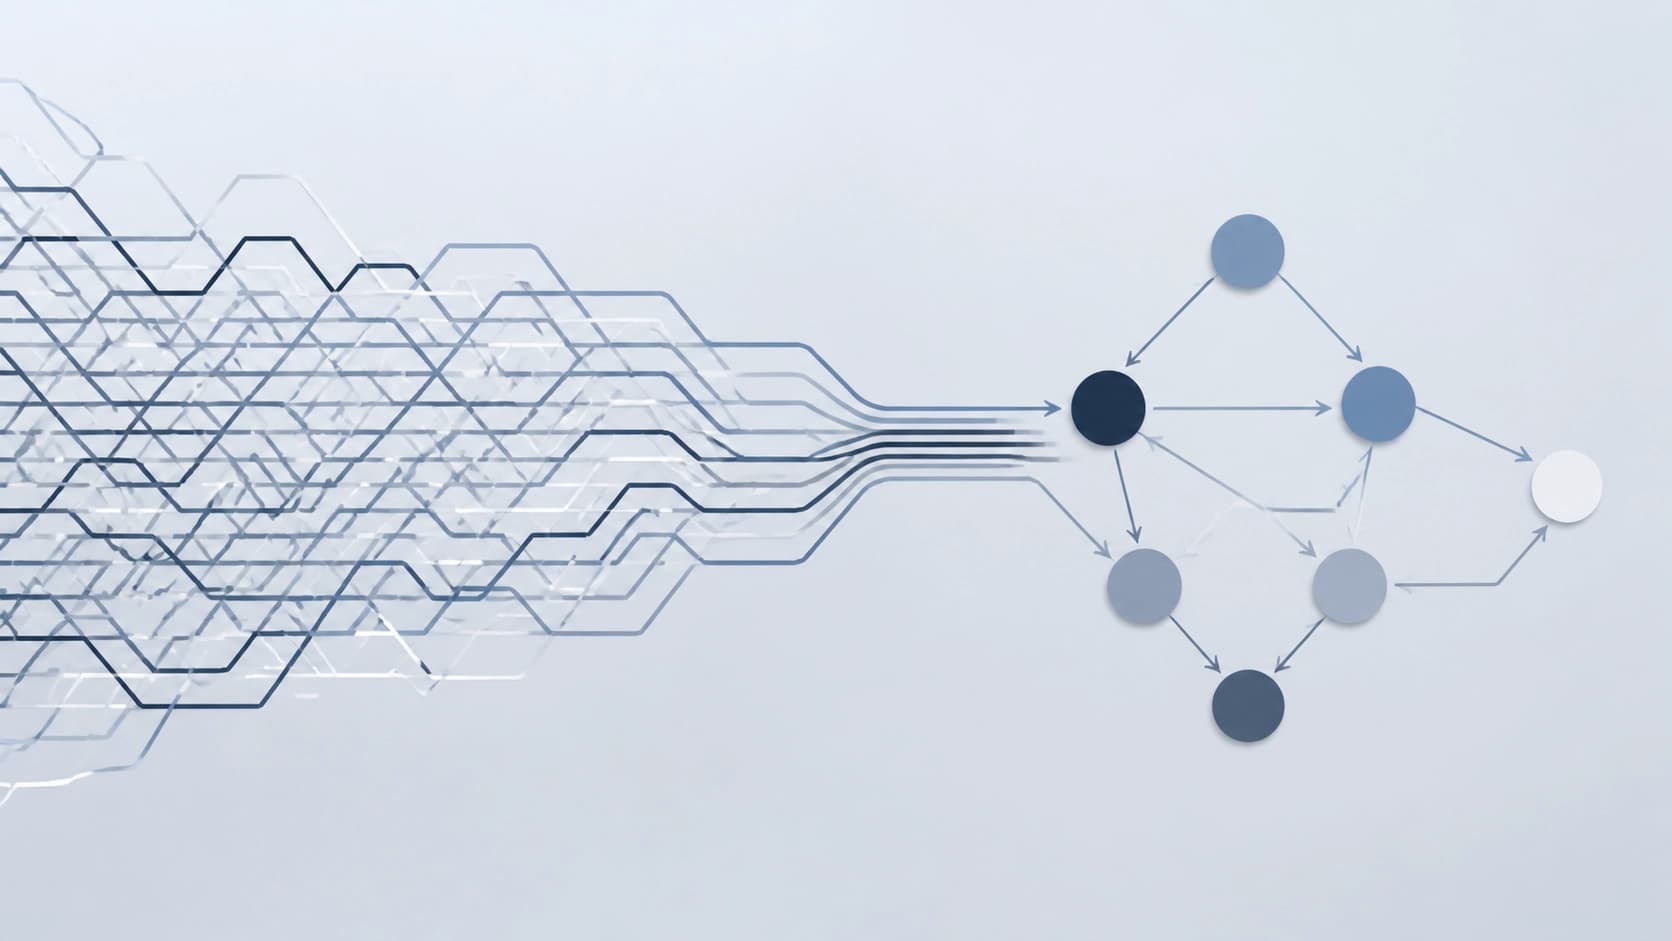
Perlu dicatat secara khusus apa yang kurang dari pendekatan sebelumnya. Analisis biasanya dilakukan pada satu jejak sekaligus atau hanya bersandar pada eksekusi yang berhasil. Dalam kedua kasus tersebut, gambaran keseluruhan hilang — topologi yang menghubungkan antara prediksi tindakan berikutnya dan prediksi kegagalan. Padahal justru itulah yang dibutuhkan, baik untuk audit keamanan maupun untuk pemantauan waktu nyata.
Satu automata untuk seluruh korpus
Ide metodenya: ambil seluruh kumpulan jejak dan ringkas menjadi satu mesin keadaan berhingga (FSM) yang ringkas. Bukan pohon keputusan untuk setiap eksekusi, bukan embedding di suatu tempat dalam ruang vektor, melainkan graf biasa dengan keadaan dan transisi — substrat struktural yang membuat perilaku agen, jika bukan dapat diprediksi, setidaknya dapat dideskripsikan.
Hasil pada dua belas dataset publik tampak menjanjikan:
- automata yang dihasilkan berukuran kecil — dari 7 hingga 43 keadaan, sehingga benar-benar dapat digambar dan dibahas dalam rapat;
- pada data tertahan, automata mereproduksi jejak dengan fitness tidak di bawah 0.997 — kecocokan yang hampir sempurna;
- topologi yang dibangun pada split berbeda dari dataset yang sama ternyata hampir identik;
- proses perakitannya sendiri memakan waktu milidetik, bukan jam pelatihan.
Poin terakhir lebih penting daripada yang terlihat. Metode yang dibangun secara instan dapat dirakit ulang setelah setiap perubahan prompt atau konfigurasi — dan langsung terlihat apakah perilaku sistem berubah.
Mengapa ini bukan sekadar visualisasi yang indah
Keringkasan di sini bukan tujuan akhir. Ketika Anda memiliki 20 keadaan alih-alih ribuan baris teks, muncul kemungkinan untuk bernalar tentang mode kerja agen: ini siklus «mencoba — mendapat galat — mengulang», ini cabang «tugas beralih ke pertanyaan klarifikasi», ini keadaan langka yang hampir tidak memiliki jalan keluar. Selanjutnya, mode-mode ini dapat diolah secara teknis — misalnya, membangun fitur yang dihitung untuk setiap keadaan.
Prediksi langkah berikutnya: keadaan lebih penting daripada memori
Untuk memprediksi tindakan agen berikutnya, para penulis menggunakan konteks keadaan FSM. Dan pendekatan ini mengungguli Agent Workflow Memory pada setiap dataset di mana anotasi konsisten dengan jalannya eksekusi yang sebenarnya. Dengan kata lain, pengetahuan tentang «mode apa yang sedang dijalani agen saat ini» ternyata lebih berguna daripada memori yang terakumulasi tentang episode kerja sebelumnya.
Ada nuansa menarik di sini. Konteks keadaan bukan sekadar nomor simpul, melainkan deskripsi terkompresi tentang apa yang sudah terjadi dan dengan probabilitas berapa akan terjadi selanjutnya. Hasilnya adalah semacam peta kelanjutan yang mungkin, yang dibangun bukan atas semantik teks, melainkan atas statistik transisi. Untuk praktik, ini berarti prediktor langkah berikutnya dapat dilatih lebih murah: ia tidak memerlukan akses ke keadaan tersembunyi model, cukup strukturnya.
Prediksi kegagalan dan pemantauan berdasarkan jejak parsial
Paruh kedua karya ini tentang diagnostik. Fitur yang dihitung berdasarkan keadaan individu automata memberikan AUROC hingga 0.94 pada data tertahan. Artinya, model yang tidak mengetahui apa pun tentang bagian dalam LLM, berdasarkan karakteristik perilaku, membedakan eksekusi yang akan berakhir dengan kegagalan dan yang akan sampai ke akhir.
Yang paling praktis di sini adalah monitor daring. Ia mengamati jejak yang belum lengkap dan memberi peringkat lebih tinggi pada eksekusi yang gagal dibandingkan yang berhasil, tanpa menunggu akhirnya. Ini cukup untuk mengaktifkan penghentian dini jauh sebelum agen benar-benar menyimpang: menghemat token, waktu, dan yang lebih penting, mencegahnya menimbulkan kerugian. Untuk agen yang menulis ke basis data, memanggil API pembayaran, atau mengelola infrastruktur, kemampuan untuk menghentikan eksekusi di tengah seperti ini bukan kemewahan, melainkan keharusan.
Kesimpulan utama: perilaku ditentukan oleh harness, bukan model
Mungkin tesis paling provokatif dari artikel ini berbunyi demikian: topologi perilaku agen sebagian besar ditentukan bukan oleh model bahasa itu sendiri, melainkan oleh deployment harness — kerangka tempat model dijalankan. Templat prompt, kumpulan alat, aturan penanganan galat, batas langkah — inilah yang membentuk graf transisi.
Dari sini muncul beberapa kesimpulan. Pertama, mengganti model dengan yang lain pada harness yang sama mungkin tidak mengubah struktur perilaku secara radikal — yang berarti automata yang dirakit pada satu model pun perlu diuji pada model lain. Kedua, meningkatkan agen sering kali lebih efektif melalui perubahan pada harness, bukan melalui peningkatan bobot. Ketiga, muncul primitif struktural yang model-agnostic: pendekatan yang sama cocok untuk audit keamanan dan untuk pemantauan runtime, terlepas dari API siapa yang Anda panggil.
Hal yang perlu diingat
Pendekatan ini tidak menghapus kehati-hatian. Dua belas dataset masih merupakan sampel yang terbatas, dan fitness 0.997 menunjukkan seberapa baik automata mendeskripsikan jejak yang sudah dikumpulkan, bukan bahwa ia akan memprediksi perilaku sistem di lingkungan yang tidak dikenal. AUROC yang tinggi untuk prediksi kegagalan juga diperoleh pada tugas-tugas tertentu: di domain baru, fitur-fitur harus dihitung ulang.
Namun demikian, arah ini tampak masuk akal. Alih-alih terus-menerus memperbesar jendela konteks dan berharap model «akan mencari tahu sendiri», kita dapat sekali membangun model perilaku harness kita yang ringkas — dan selanjutnya menggunakannya sebagai skema: melihat di mana agen tersangkut, keadaan mana yang mengarah ke kegagalan, dan apa yang akan berubah jika konfigurasi diperbaiki. Automata tidak lebih pintar dari LLM, tetapi ia lebih jujur: ia dapat dimuat seluruhnya di kepala, dan itu sudah setengah dari keberhasilan dalam debugging.


