
Singkatnya: di mana tepatnya masalahnya
Ketika model dengan konteks panjang melayani sebuah permintaan, biaya utamanya bukan pada bobot, melainkan pada KV-cache — kunci dan nilai yang tersimpan untuk semua token yang sudah dibaca. Semakin panjang dokumen atau dialog, semakin banyak tensor yang harus disimpan di memori dan semakin banyak data yang harus dibaca ulang pada setiap langkah generasi. Dari sinilah muncul dilema klasik: entah memotong konteks, atau membayarnya dengan memori dan kecepatan inferensi.
Solusi yang ada biasanya memilih salah satu dari dua ekstrem. Entah memampatkan seluruh state secara keseluruhan, dengan risiko kehilangan informasi terbaru yang justru dibutuhkan untuk jawaban berikutnya, atau mempertahankan semuanya pada presisi asli dan menabrak kapasitas akselerator.
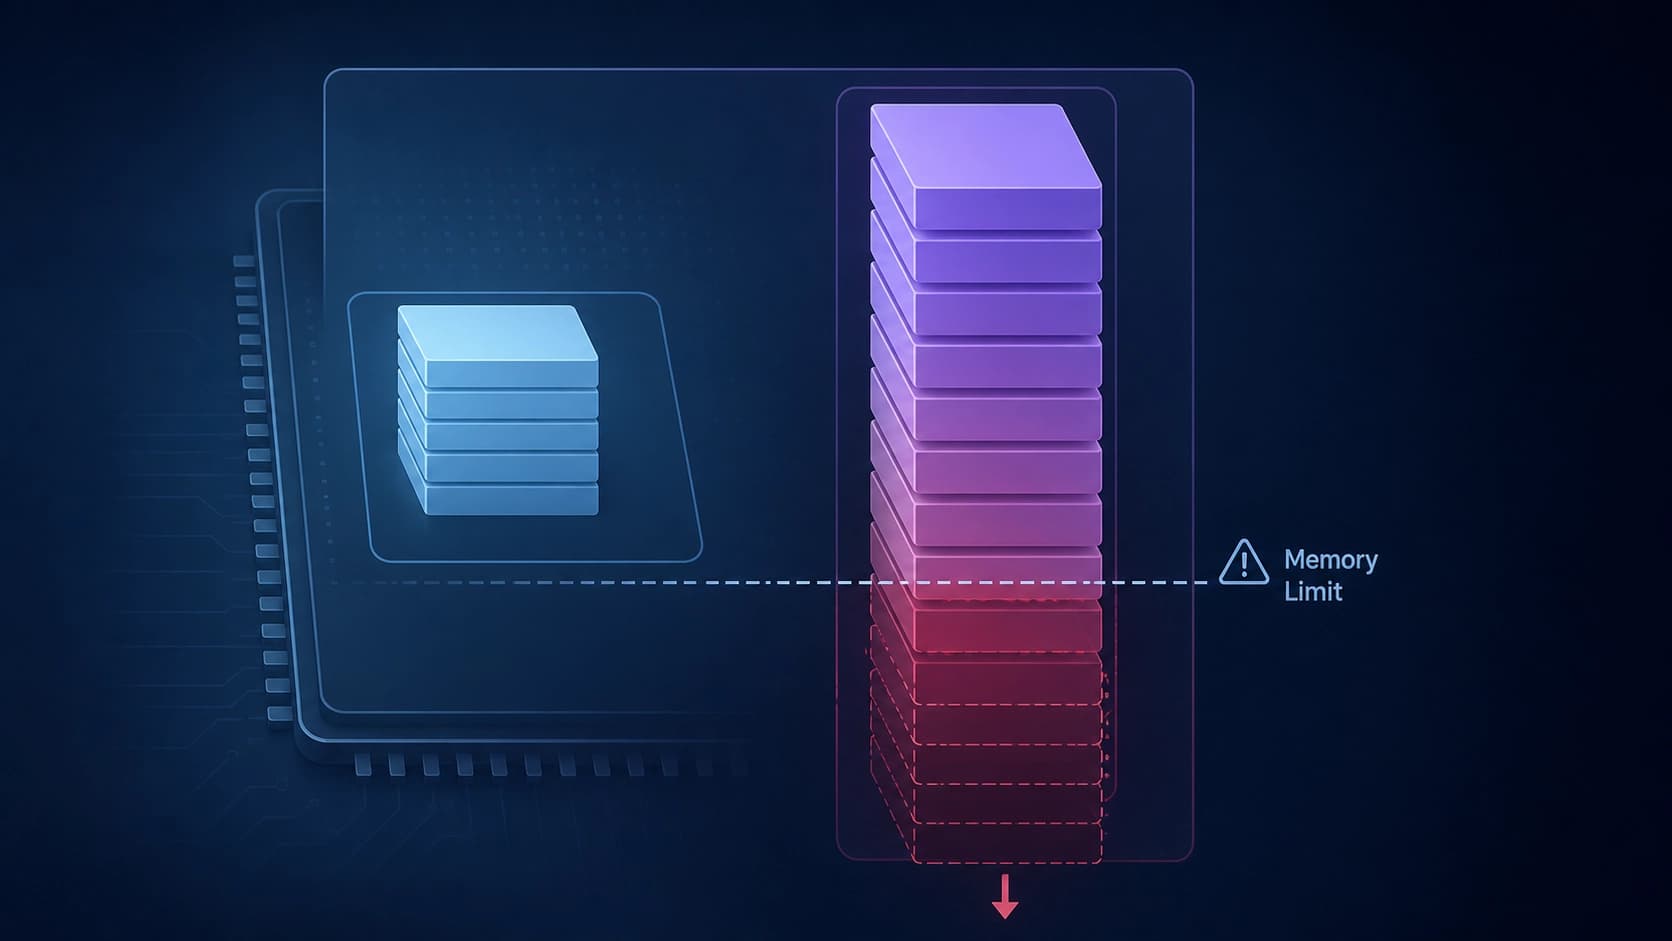
Justru ke dalam persimpangan inilah karya yang dibahas di bawah ini berusaha masuk.
Apa yang ditawarkan para penulis
Artikel «Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention» dikirim ke arXiv pada 24 Agustus 2026 dengan nomor 2608.23834, rubrik cs.AI, 13 halaman dan 3 gambar, DOI 10.48550/arXiv.2608.23834. Penulisnya adalah Sergii Kozyrev dan Davyd Maiboroda dari Minima AI, Inc. Detail yang menarik: pada blok tautan ke PDF di halaman pracetak, keterangannya menunjuk ke penulis pertama «dan dua lainnya», meskipun dalam deskripsi bibliografis hanya tercantum dua orang. Hal kecil, tetapi ini mengingatkan bahwa metadata pracetak sebaiknya diverifikasi.
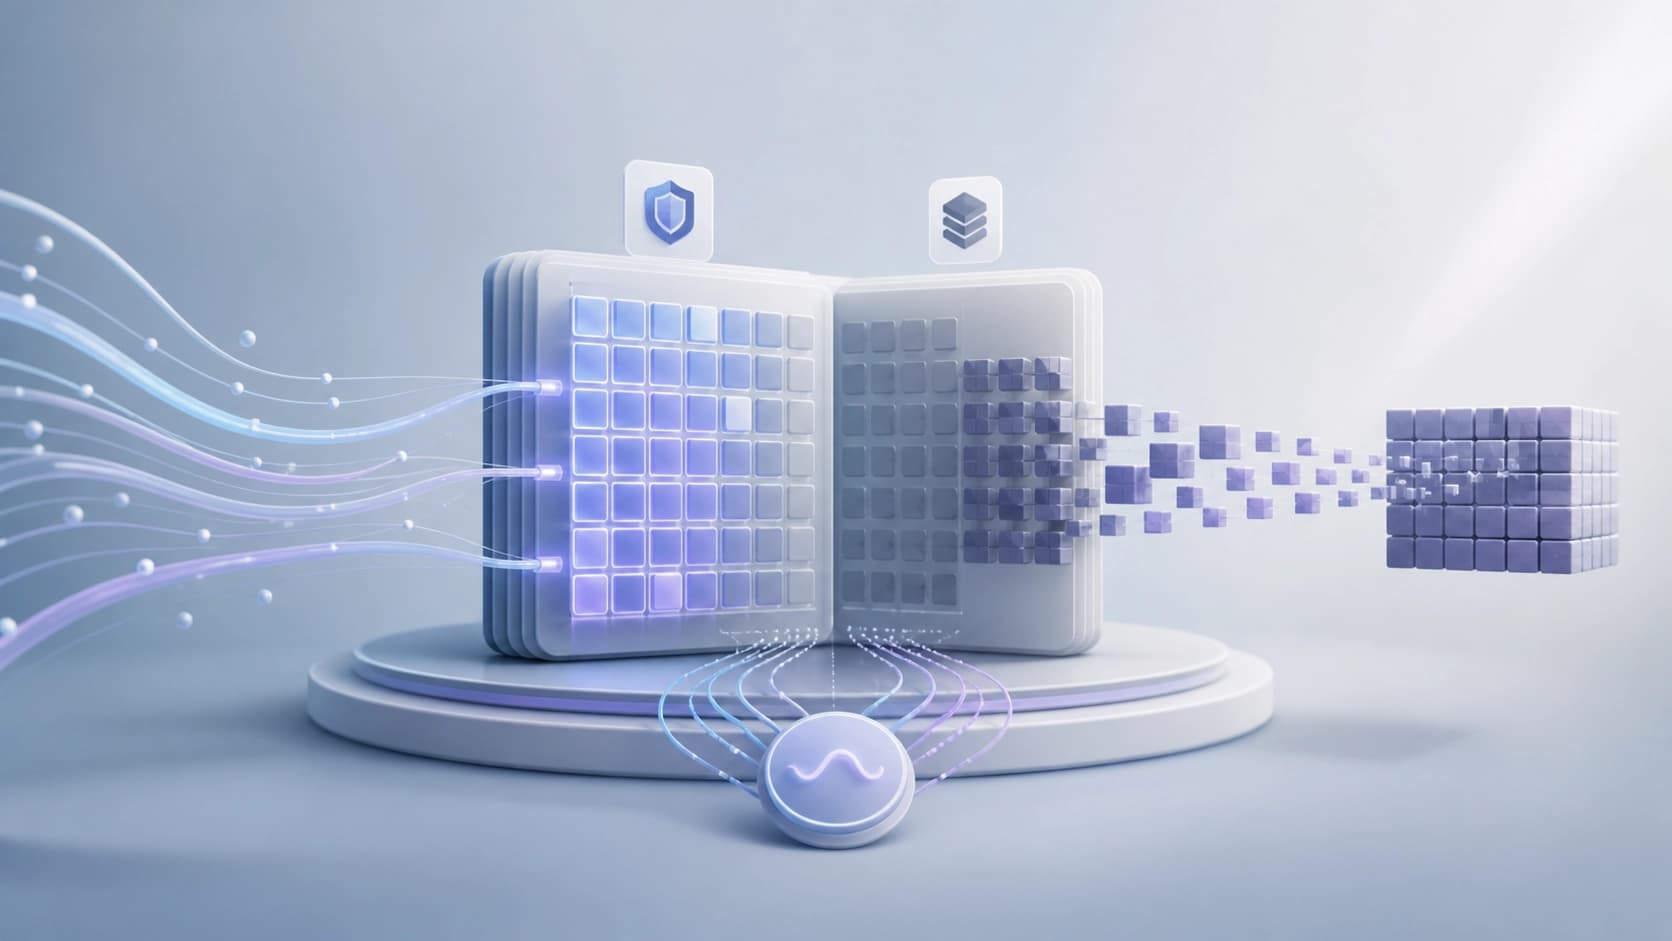
Inti usulan Minima-KV adalah hierarki halaman KV-cache, di mana halaman yang berbeda disimpan dalam format numerik yang berbeda. Kata kunci dalam judulnya — retention-preserving, yakni «mempertahankan retensi»: state dari permintaan terbaru tidak digusur ke mana pun.
Jangkar dalam FP8, arsip dalam TQ3
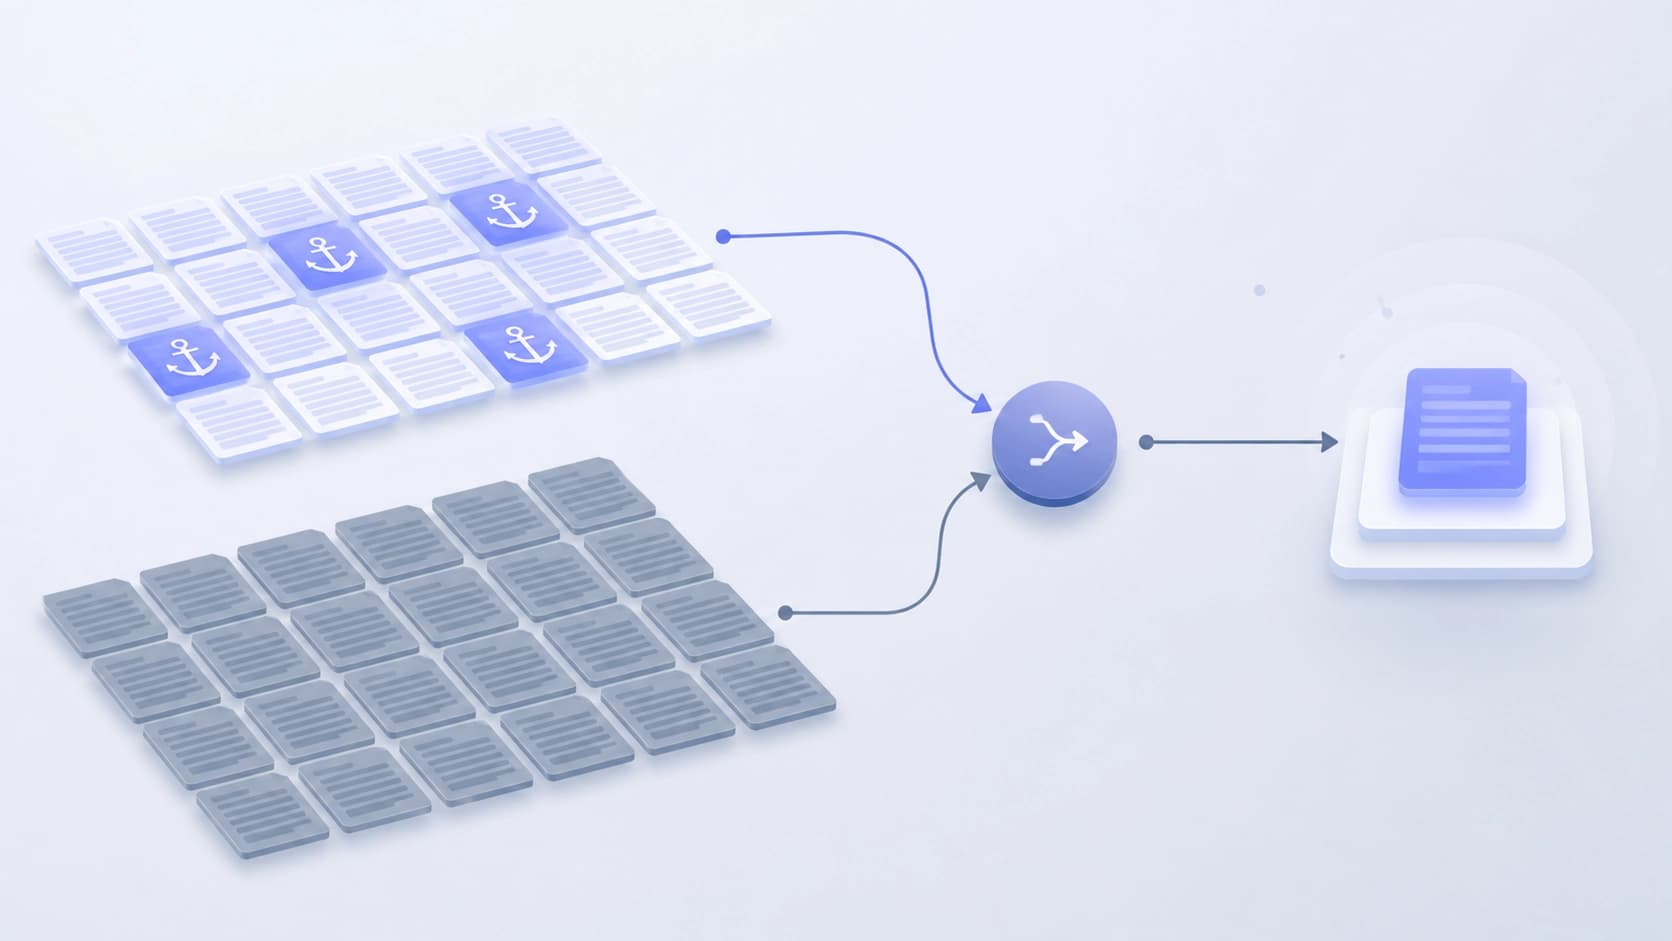
Logika pemisahannya sederhana. Halaman yang baru saja digunakan dan ditandai sebagai terlindungi (anchor) tetap berada dalam FP8. Halaman yang lebih lama, yang tidak masuk ke jangkar, dikonversi ke packed TQ3 — format terpaket yang lebih padat. Selain itu, setiap halaman dari permintaan yang masih hidup tetap dapat dialamatkan secara langsung: tidak ada yang dibuang dari ruang alamat dan tidak ada yang digantikan oleh salinan perkiraan.
Bagaimana hasil parsial disatukan
Yang paling menarik adalah aritmetikanya. Kernel terpisah untuk setiap format menghitung state atensi parsialnya masing-masing, lalu digabungkan melalui online-softmax merge yang dinormalisasi secara global. Sederhananya: alih-alih menyetarakan semua halaman ke satu tipe sebelum komputasi, sistem menghitung kontribusi setiap kelompok dalam formatnya sendiri dan menjumlahkan hasil yang telah dinormalisasi dengan benar.
Berkat ini, dekode berjalan langsung pada cache yang heterogen, tanpa apa yang disebut bayangan padat — salinan lengkap cache dalam satu format tunggal, yang justru akan meniadakan seluruh penghematan memori.
Apa yang ditunjukkan oleh pengukuran
Memori dan pemampatan
Pengukuran dilakukan pada profil yang terikat pada konfigurasi spesifik model Qwen3.6-27B pada satu akselerator NVIDIA RTX PRO 6000 Blackwell dengan memori 96 GB. Hasilnya adalah 18,3 KiB atensi KV per satu token hidup. Ini berarti pemampatan 3,50x dibandingkan BF16 dan 1,75x dibandingkan FP8.
Angka kedua lebih penting daripada yang terlihat pada pandangan pertama. Perbandingan dengan FP8 menunjukkan bahwa keuntungannya dicapai bukan hanya dari peralihan presisi setengah ke format yang lebih hemat, melainkan justru dari skema penyimpanan hibrida.
Kualitas pada konteks panjang
Profil yang mematerialisasi — yang halaman hibridanya benar-benar dibentangkan menjadi tensor — cocok dengan kontrol padatnya pada tugas RULER needle-in-a-haystack pada 16K. Artinya, pada pencarian jarum dalam tumpukan jerami tidak ditemukan perbedaan.
Selanjutnya kompromi mulai muncul. Pada kumpulan LongBench v2 yang terdiri dari 503 pertanyaan, delta-nya ternyata negatif: -0,80 poin persentase pada 16K, -0,60 pada 32K, dan -0,40 pada 64K. Perhatikan bentuk kurvanya — kerugiannya tidak bertambah secara linear seiring panjang konteks, melainkan sedikit berfluktuasi. Para penulis tidak memberikan penjelasan, tetapi fakta ini patut diingat saat menafsirkan: variasi sepersekian persen mudah tertukar dengan derau pengukuran.
Uji kenari
Tes terpisah — single-pair canary, yang membandingkan dua dekode langsung dengan permintaan masing-masing 59.008 token. Hasilnya: KV aktif menyusut 3,625 kali, throughput sebesar 0,9821x dibandingkan kontrol, semua 16 lapisan atensi penuh dirutekan tanpa fallback ke mode padat, dan tidak ada satu pun bayangan padat yang disimpan.
Throughput yang sedikit di bawah satu pada dasarnya adalah pertukaran yang jujur: sekitar dua persen kecepatan untuk pengurangan memori yang berlipat.
Kesimpulan dan catatan
Kesimpulan yang dinyatakan para penulis cukup hati-hati: hasilnya menunjukkan jalur praktis untuk memampatkan state konteks panjang dalam format campuran tanpa menggusur halaman dari permintaan yang masih hidup. Inilah tepatnya yang kurang dari pendekatan sebelumnya — kompresi yang tidak mengorbankan data terbaru demi data lama.
Hal yang perlu dipertimbangkan saat membaca:
- Profil pengujian terikat pada konfigurasi. Ini soal model tertentu dan akselerator tertentu; portabilitas angkanya ke arsitektur lain tidak ditunjukkan.
- Uji kenari terlalu sempit. Satu pasang permintaan, satu skenario dekode langsung — ini ilustrasi kelayakan, bukan statistik beban kerja.
- Penurunan pada LongBench v2 tidak nol. Sepersekian poin persentase memang sedikit, tetapi pada tugas yang setiap satuan akurasinya penting, ini sudah menjadi alasan untuk pengukuran sendiri.
- Tidak ada data latensi dalam kondisi produksi. Throughput pada uji kenari, menurut deskripsinya, seluruhnya melewati 16 lapisan tanpa jalur cadangan — menarik untuk melihat bagaimana perutean berperilaku pada skenario terburuk, ketika halaman jangkar menjadi lebih banyak dari biasanya.
Nilai praktis dari karya ini bukan pada angka pemampatan yang memecahkan rekor, melainkan pada hal lain: karya ini menunjukkan bahwa cache heterogen dapat dilayani secara langsung, tanpa menyusun salinan lengkapnya untuk setiap langkah. Jika pendekatan ini dapat dipindahkan ke model lain, skenario konteks panjang mendapatkan satu lagi tuas di samping penskalaan perangkat keras.


