Perkalian titik sebagai hambatan
Hampir semua arsitektur atensi modern dibangun dengan cara yang sama: kueri dan kunci dicocokkan melalui perkalian titik (atau versi ternormalisasinya), hasilnya diubah menjadi bobot, dan keluaran dirakit sebagai jumlah berbobot dari nilai. Pendekatan ini universal, tetapi ada harganya — geometri ruang fitur dalam skema seperti ini ditentukan secara kaku: kemiripan diukur "secara langsung", tanpa memperhitungkan bahwa arah yang berbeda dalam ruang dapat memiliki kepentingan dan skala yang berbeda.
Justru pada keterbatasan inilah karya arXiv:2608.24462 "Mahalanobis-Based Multi-Head Attention for Complex State Propagation" (penulis — Xiaohe Li; bagian cs.AI) diarahkan. Alih-alih perkalian yang biasa, di dalamnya digunakan kernel RBF yang dibangun di atas jarak Mahalanobis. Sederhananya, kemiripan antar elemen urutan dihitung bukan "secara langsung", melainkan dengan koreksi terhadap struktur kovarians data — seolah-olah ruang tersebut sedikit diregangkan dan diputar sebelum perbandingan agar arah yang berkorelasi tidak dianggap independen.
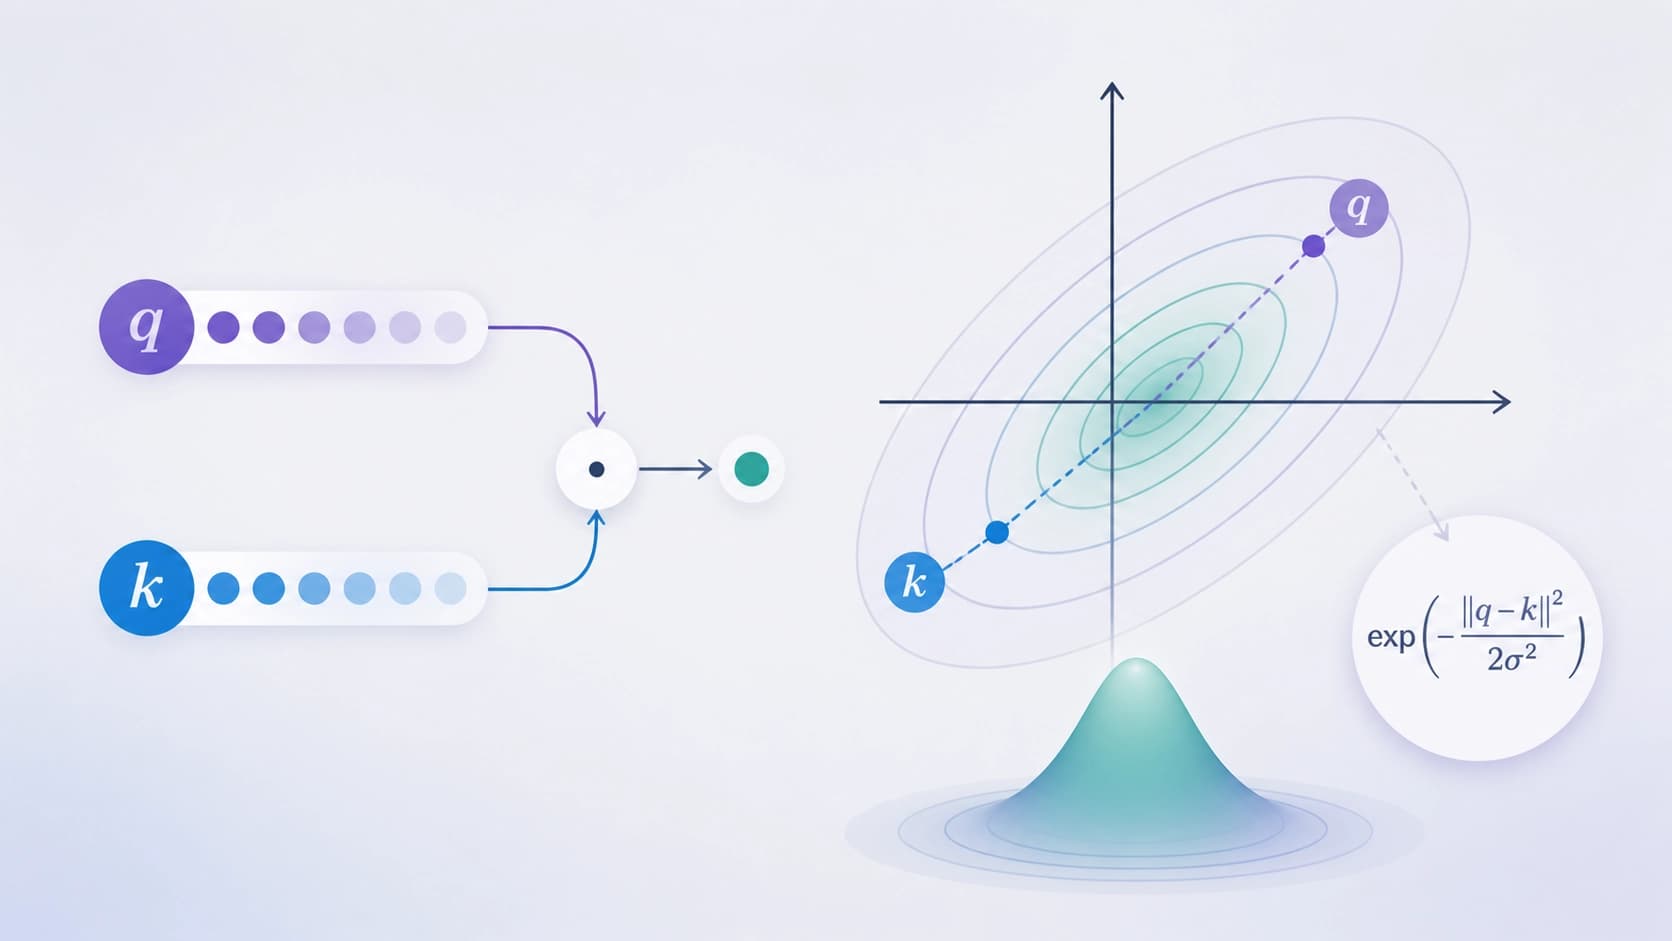
Apa yang diberikan jarak Mahalanobis
Atensi dalam ruang berdimensi tak hingga tanpa pertumbuhan parameter
Klaim utama penulis: kernel RBF di atas jarak Mahalanobis memungkinkan penghitungan atensi seolah-olah ia berada dalam ruang fitur berdimensi tak hingga, namun jumlah parameter yang dapat dilatih tidak bertambah. Ini bukan sihir, melainkan konsekuensi dari fakta bahwa kernel itu sendiri sudah mendefinisikan pemetaan nonlinier — lapisan terpisah untuk mengembangkan fitur tidak diperlukan. Secara praktis, ini berarti tuntutan yang lebih sederhana terhadap memori dan optimisasi, yang di era model raksasa tampak hampir provokatif.
Definit positif dan Tree Attention
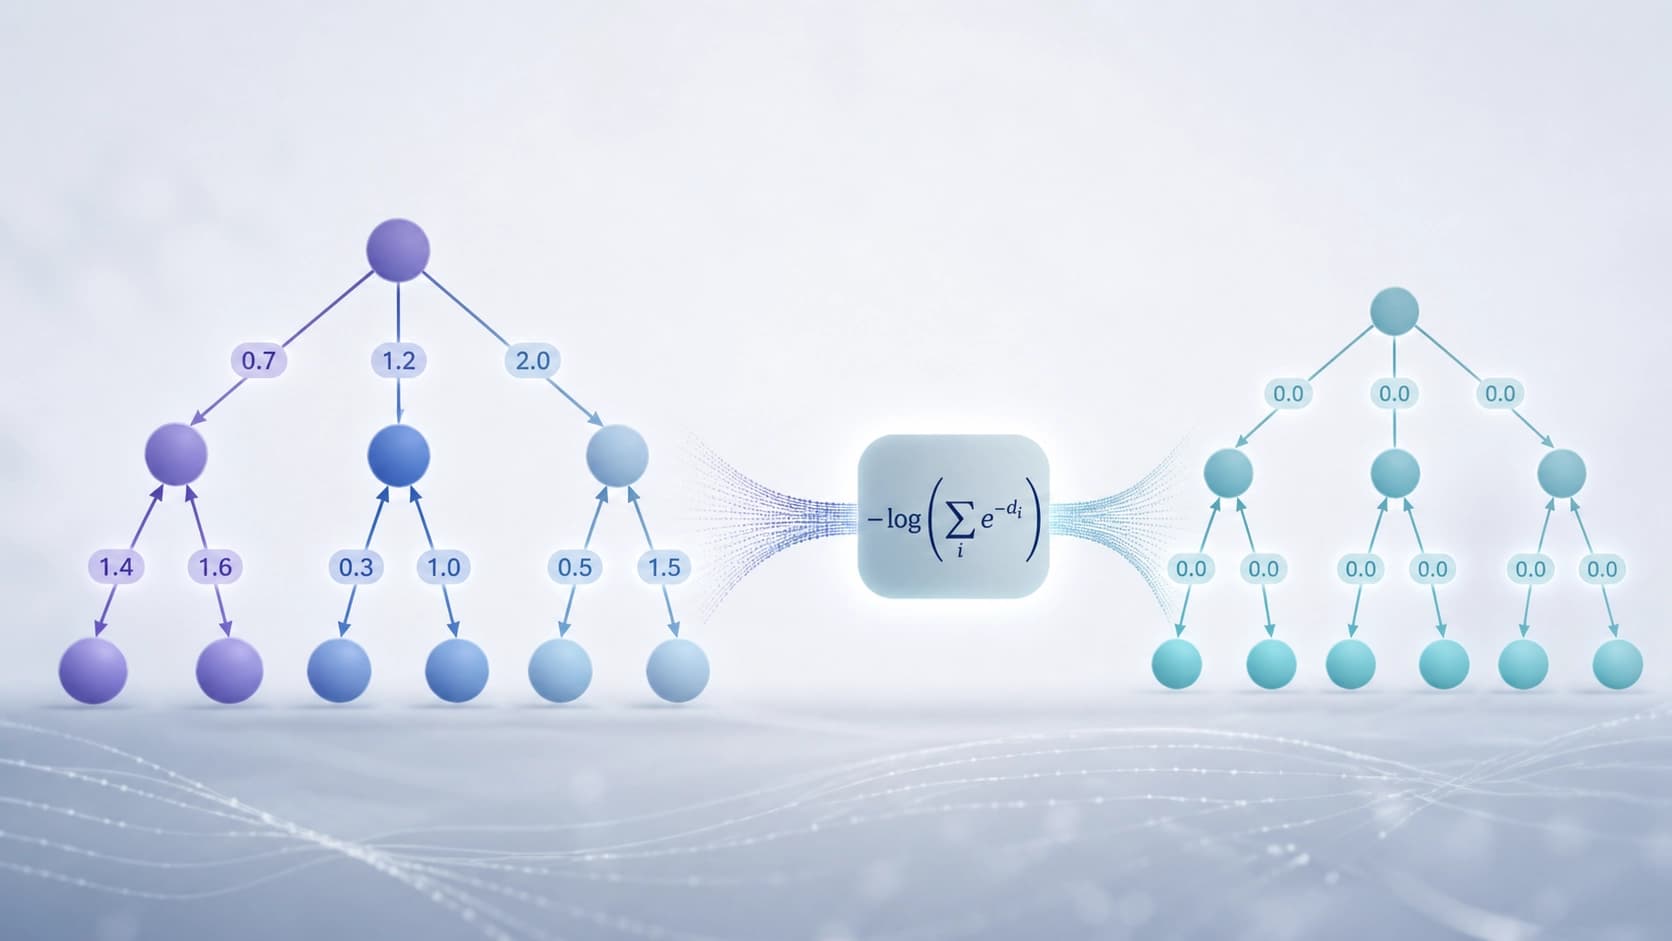
Lapisan kedua dari gagasan ini bersandar pada sifat matematis jarak Mahalanobis: ia definit positif. Dari sini dapat dibangun secara langsung apa yang dalam artikel disebut Tree Attention — skor atensi dikonstruksi bukan dari kemiripan "mentah", melainkan dari jarak yang terakumulasi sepanjang pohon. Agar akumulasi tersebut tidak menyimpang secara numerik, diterapkan koreksi melalui LogSumExp: dari jarak dikurangi logaritma dari jumlah eksponensial sepanjang sisi. Pada dasarnya, ini adalah cara untuk menyelaraskan kontribusi dari berbagai jalur dalam pohon tanpa kehilangan bobot relatifnya.
Bagi pembaca yang tidak akrab dengan detailnya, analogi yang berguna adalah ini: alih-alih menjumlahkan "kemiripan" secara sembarangan, model dengan cermat menormalisasinya seiring pergerakan ke dalam struktur. Ini lebih mirip pembukuan daripada intuisi — tetapi justru ketelitian seperti inilah yang memungkinkan penalaran tetap stabil pada rantai ketergantungan yang panjang.
Attention meshing: kepala mulai berbicara satu sama lain
Biasanya atensi multi-kepala dibangun sebagai kumpulan pakar yang hampir independen: setiap kepala menghitung miliknya sendiri, dan pencampuran hanya terjadi pada keluaran, melalui proyeksi linier. Dalam MHA-CSP, matriks jarak Mahalanobis digunakan kembali — atas dasar itu dibangun mekanisme "attention meshing", yang memaksa kernel dari berbagai kepala berinteraksi secara langsung. Penulis mengklaim manfaat ganda: akurasi lebih tinggi, dan pelatihan berjalan lebih efisien, karena pekerjaan komputasi yang sama tidak diduplikasi.
Eksperimen: 119K parameter melawan model dasar yang besar
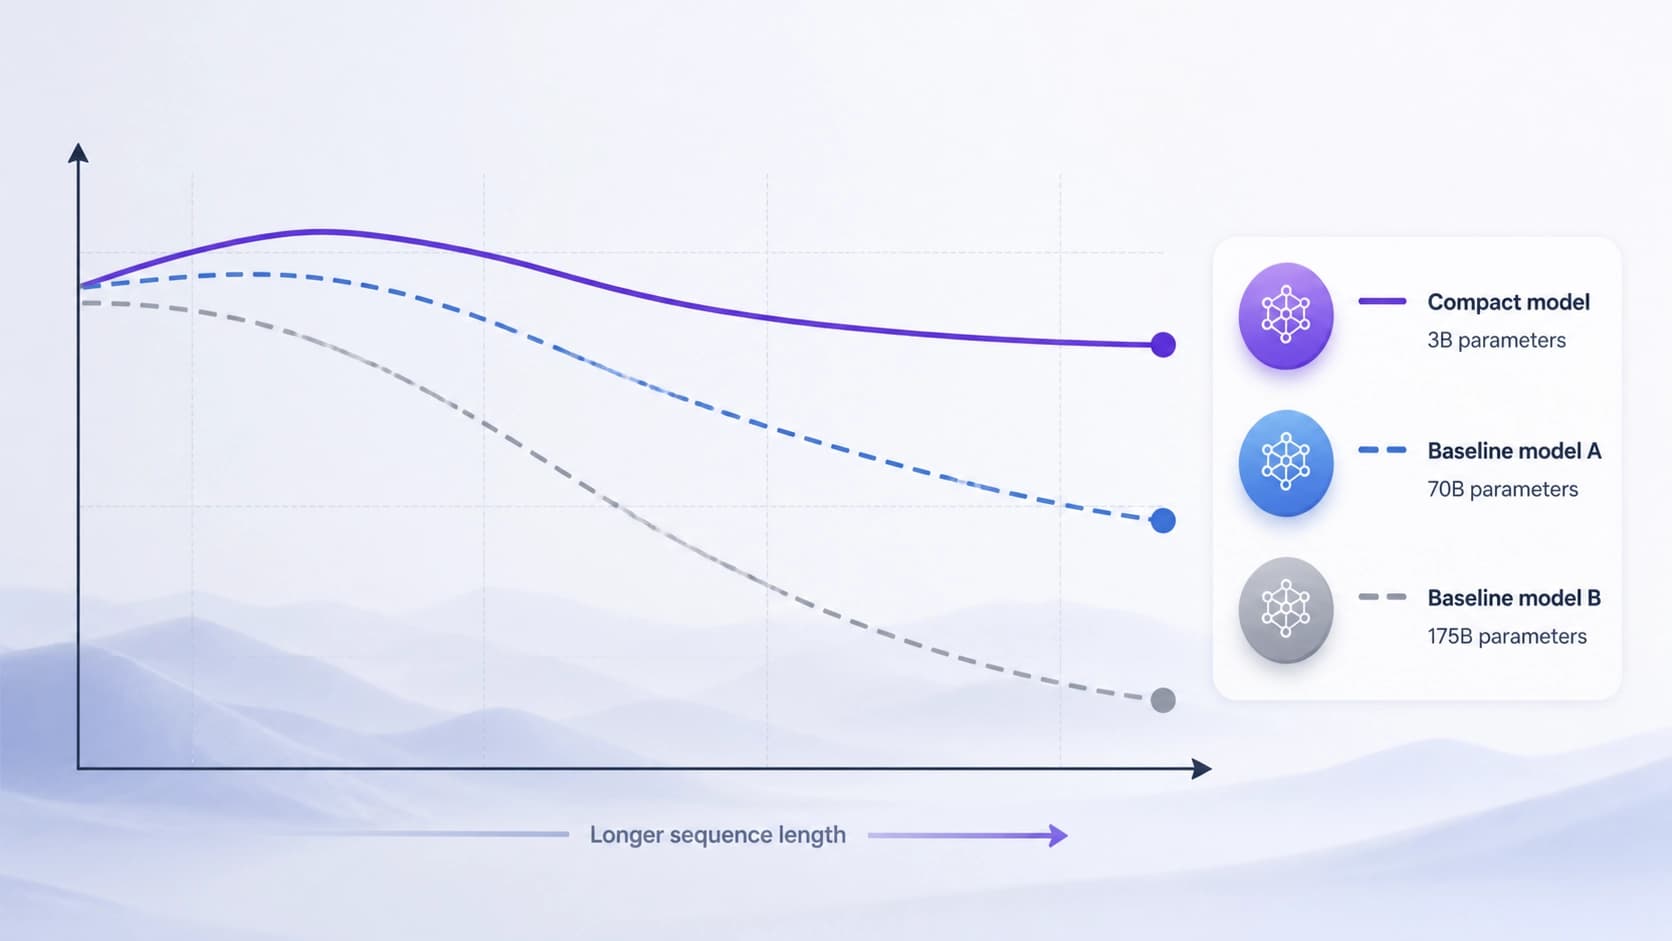
Bagian paling mencolok dari karya ini adalah perbandingannya. MHA-CSP dengan hanya 119 ribu parameter dibandingkan dengan transformer dasar dan jaringan konvolusi graf yang dilatih dari awal dalam kondisi identik. Tugasnya adalah pelacakan keadaan pada urutan panjang. Terlebih lagi, teacher forcing diterapkan secara eksklusif pada keadaan tersembunyi akhir, artinya model tidak menerima petunjuk pada setiap langkah, seperti yang sering dilakukan dalam pelatihan yang lebih mendidik.
Menurut klaim penulis, MHA-CSP secara konsisten mengungguli para pesaingnya. Model dasar sendiri bersandar pada atensi padat (transformer) atau penyebaran informasi melalui graf (GCN), sedangkan MHA-CSP mencapai penalaran terstruktur melalui koreksi jarak sintetis dan penelusuran informasi yang hemat yang diwarisi dari backbone CSP.
Perlu ditekankan: ini bukan soal model kecil "mengejar" model besar dalam segala hal. Ini soal kelas tugas tertentu — urutan panjang dengan struktur simbolik internal, di mana yang penting bukan sekadar mengingat konteks, melainkan mempertahankan keadaannya. Justru di sanalah geometri jarak dan normalisasi berbentuk pohon mulai bekerja.
Apa yang ini ubah dalam praktik
Kesimpulan utama karya ini dirumuskan sebagai berikut: propagasi keadaan bernilai kompleks (complex-valued state propagation) yang dikombinasikan dengan koreksi multi-kepala bersama ternyata menjadi alat yang berfungsi untuk menangkap struktur simbolik. Dan ini menetapkan kompromi baru antara efisiensi dan kualitas untuk tugas penalaran terstruktur.
Jika dilihat lebih luas, di sini terlihat tren beberapa tahun terakhir: alih-alih menambah parameter, para peneliti mencari bias induktif yang lebih tepat — yaitu menanamkan asumsi yang benar tentang sifat data ke dalam arsitektur. Perkalian titik adalah asumsi yang nyaman, tetapi cukup kasar. Menggantinya dengan kernel bermetrik kovarians adalah upaya untuk mengatakan kepada model: "tidak semua arah dalam ruang itu setara, perhitungkan itu sejak awal".
Pandangan hati-hati dari luar
Ada alasan untuk tidak terburu-buru menulis ulang pipeline. Pertama, hasilnya diperoleh pada kumpulan tugas pelacakan keadaan yang spesifik; memindahkannya ke generasi teks, multimodalitas, atau skenario dialog tanpa pengujian terpisah tidaklah bijak — dalam abstraknya eksperimen semacam itu tidak ada. Kedua, penulis tunggal dan versi pertama pracetak (v1, diajukan 25 Agustus 2026) berarti kita belum melihat replikasi independen: berkas berukuran 377 KB tersedia dalam PDF, HTML, dan sumber TeX, tetapi reproduksi adalah cerita tersendiri.
Namun arah ini tampak produktif. Menjauh dari perkalian titik, bekerja langsung dengan geometri jarak, menggunakan kembali komputasi antar kepala — ini justru langkah-langkah yang menurunkan biaya model tanpa mengorbankan ekspresivitas. Jika hasilnya terkonfirmasi pada domain lain, jaringan "kecil tetapi terkonstruksi dengan benar" akan mendapat satu lagi argumen yang kuat.