Pelatihan penuh tidak lagi menjadi opsi yang masuk akal
Model dasar untuk elektroensefalografi dilatih tanpa anotasi — pada tugas kontrastif atau pada rekonstruksi fragmen sinyal yang dimasker. Logikanya begini: model menyerap pola umum ritme, artefak, dan transisi antar keadaan, lalu disesuaikan lebih lanjut untuk tugas spesifik seperti mendeteksi lonjakan epileptik. Secara teori, ini menghasilkan representasi yang dapat ditransfer antar klinik dan perangkat. Dalam praktiknya lebih rumit: arsip rekaman klinis terlalu berbeda satu sama lain, dan kualitas transfernya menurun cukup signifikan.
Masalah kedua adalah ekonomi. Fine-tuning klasik memperbarui semua bobot, yang berarti membutuhkan sumber daya komputasi besar untuk setiap tugas baru. Di departemen tanpa klaster GPU, skenario seperti itu tidak akan berjalan. Dari sinilah muncul pertanyaan yang menjadi dasar penelitian arXiv:2608.24727: dapatkah kita bertahan dengan sebagian kecil parameter tanpa kehilangan kualitas?
Sembilan persen: apa yang sebenarnya disesuaikan
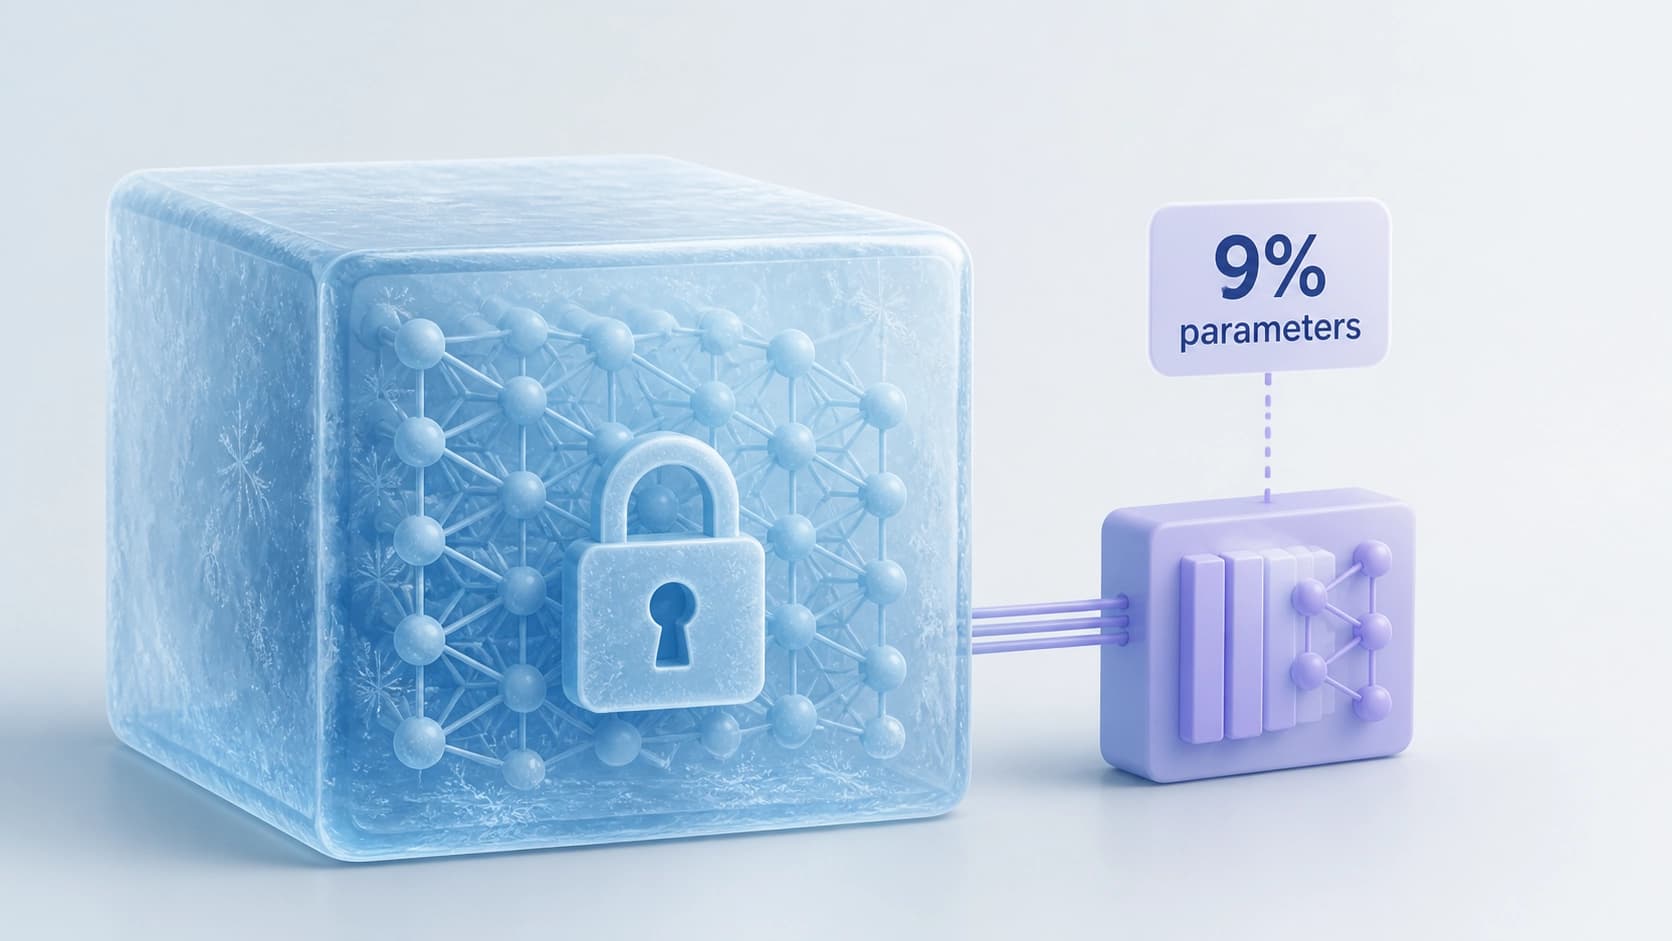
Penulis pracetak ini adalah Meghal Dani dan Stefanie Liebe. Mereka menguji mode di mana sekitar 9% bobot tetap dapat dilatih, sementara bagian model lainnya dibekukan. Adaptasi berlangsung secara swa-supervisi: model tidak sekadar dicocokkan dengan label kelas, tetapi representasi internalnya diselaraskan dengan tugas target. Teks ini dipublikasikan pada 25 Agustus 2026 (versi v1), diklasifikasikan ke bagian cs.LG dan cs.AI, DOI — 10.48550/arXiv.2608.24727. Kodenya terbuka untuk direproduksi.
Intinya bukan bahwa hasilnya adalah model yang "dipangkas". Ini adalah mode operasi yang berbeda: encoder terlatih yang berat tetap tidak berubah, sementara untuk setiap tugas baru disesuaikan lapisan tambahan yang ringkas. Bagi klinik, pemisahan seperti ini sangat mendasar — pra-pelatihan yang mahal dilakukan sekali, adaptasi yang murah diulang sebanyak yang diperlukan.
Dua model dengan tujuan pra-pelatihan yang berbeda
Agar hasilnya tidak bergantung pada satu arsitektur yang kebetulan berhasil, eksperimen ini melibatkan dua model SOTA: BIOT dengan tujuan kontrastif dan CBraMod, yang dilatih untuk merekonstruksi bagian yang dimasker. Jika teknik ini berhasil pada kedua kasus, ini bukan kebetulan, melainkan sifat dari pendekatannya.
Tiga himpunan klinis dan dua mode pengujian
Evaluasi dilakukan pada TUAB (deteksi anomali), TUEV (klasifikasi peristiwa), dan CHB-MIT (deteksi serangan). Pengukuran dilakukan dua kali — in-distribution dan out-of-distribution, yaitu diuji tidak hanya pada data "sendiri", tetapi juga pada distribusi yang bergeser.
Apa yang ditunjukkan hasilnya
- Dibandingkan dengan linear probing, adaptasi swa-supervisi memberikan peningkatan yang konsisten — hingga 20 kali lipat pada AUCPR. Ini bukan "sedikit lebih baik", melainkan perbedaan dalam orde besaran, dan paling terlihat di tempat di mana kelas langka lebih penting daripada accuracy keseluruhan.
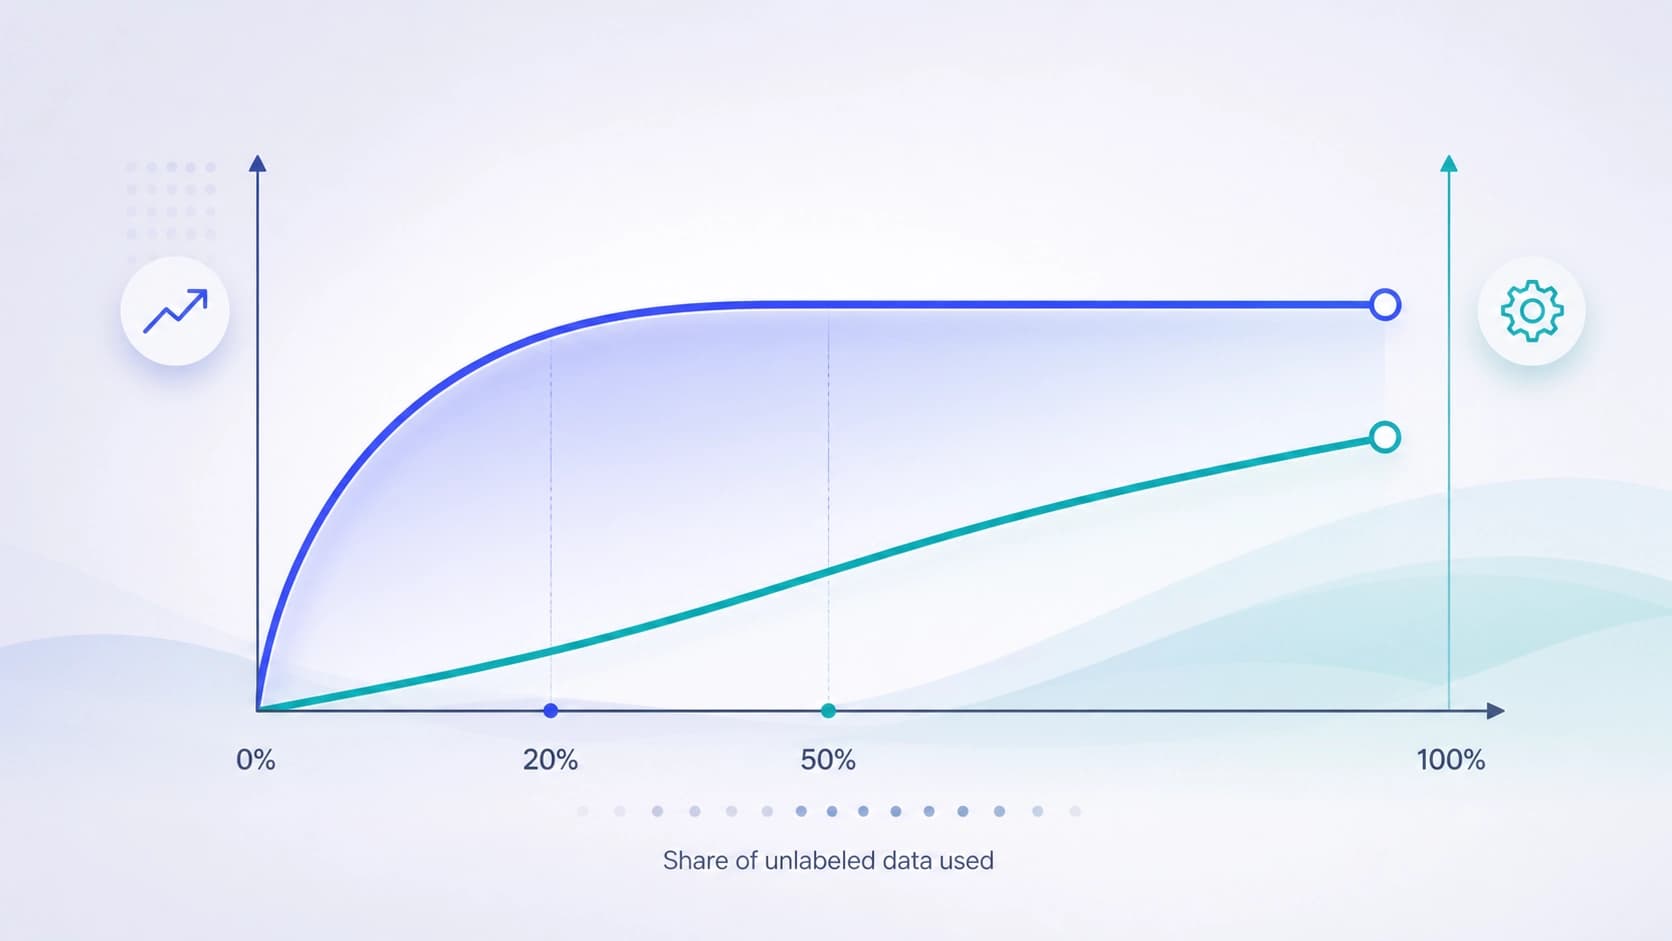
- Dengan anggaran komputasi yang tetap, puncaknya tercapai hanya pada 20–50% rekaman tanpa label yang tersedia. Sisa korpusnya tidak lagi menambah peningkatan.
- Jika jumlah total jendela sinyal ditetapkan, hasilnya tidak bergantung pada berapa banyak pasien yang termasuk di dalamnya. Artinya, yang bekerja bukan "keunikan orang", melainkan keragaman temporal dari fragmen: keadaan, mode, dan artefak yang berbeda di dalam rekaman.
Poin terakhir membalik logika pengumpulan data yang biasa. Secara intuitif, semakin banyak pasien yang berbeda, semakin andal. Di sini ternyata, dengan batas ketat pada jumlah jendela, data dapat dikumpulkan dari lebih sedikit orang — yang penting hanyalah memantau keragaman sinyal mereka sepanjang waktu.
Mengapa ini mengubah situasi bagi klinik
Sampai sekarang, penerapan model dasar EEG terhambat bukan oleh kualitas representasi, melainkan oleh anggaran: untuk mendapatkan manfaat dari model, perlu mampu membiayai pelatihan penuh dan korpus berlabel yang besar. Penelitian ini menunjukkan bahwa hambatan tersebut dapat dikurangi dari dua sisi sekaligus — dari sisi komputasi dan data. Sembilan persen bobot dan setengah arsip tanpa label, bukan seratus persen dan seluruh volume.
Bagi rumah sakit, ini berarti skenario yang lebih realistis: model dilatih secara terpusat, lalu di tempat disesuaikan untuk tugas tertentu pada perangkat yang sederhana. Ketergantungan pada siapa yang mengumpulkan lebih banyak rekaman berkurang, dan biaya penyimpanan serta pemrosesan jam sinyal yang berlebihan juga berkurang.
Yang perlu diingat
Hasil ini tidak boleh dibaca sebagai "sembilan persen selalu cukup". Ini adalah mode spesifik dari eksperimen tertentu, bukan resep universal untuk arsitektur apa pun dan himpunan data apa pun. Para penulis sendiri menegaskan: generalisasi model EEG tetap terbatas, terutama pada korpus klinis yang heterogen. Adaptasi yang hemat parameter tidak menghilangkan masalah transfer — ia hanya menurunkan biaya masuknya.
Kesimpulan praktisnya lebih sederhana dari yang terlihat: pembicaraan bergeser dari "apakah layak berurusan dengan model dasar untuk EEG" menjadi "bagaimana menerapkannya di departemen". Dan itu sudah menjadi pertanyaan rekayasa dan organisasi proses, bukan hanya pembelajaran mesin.