
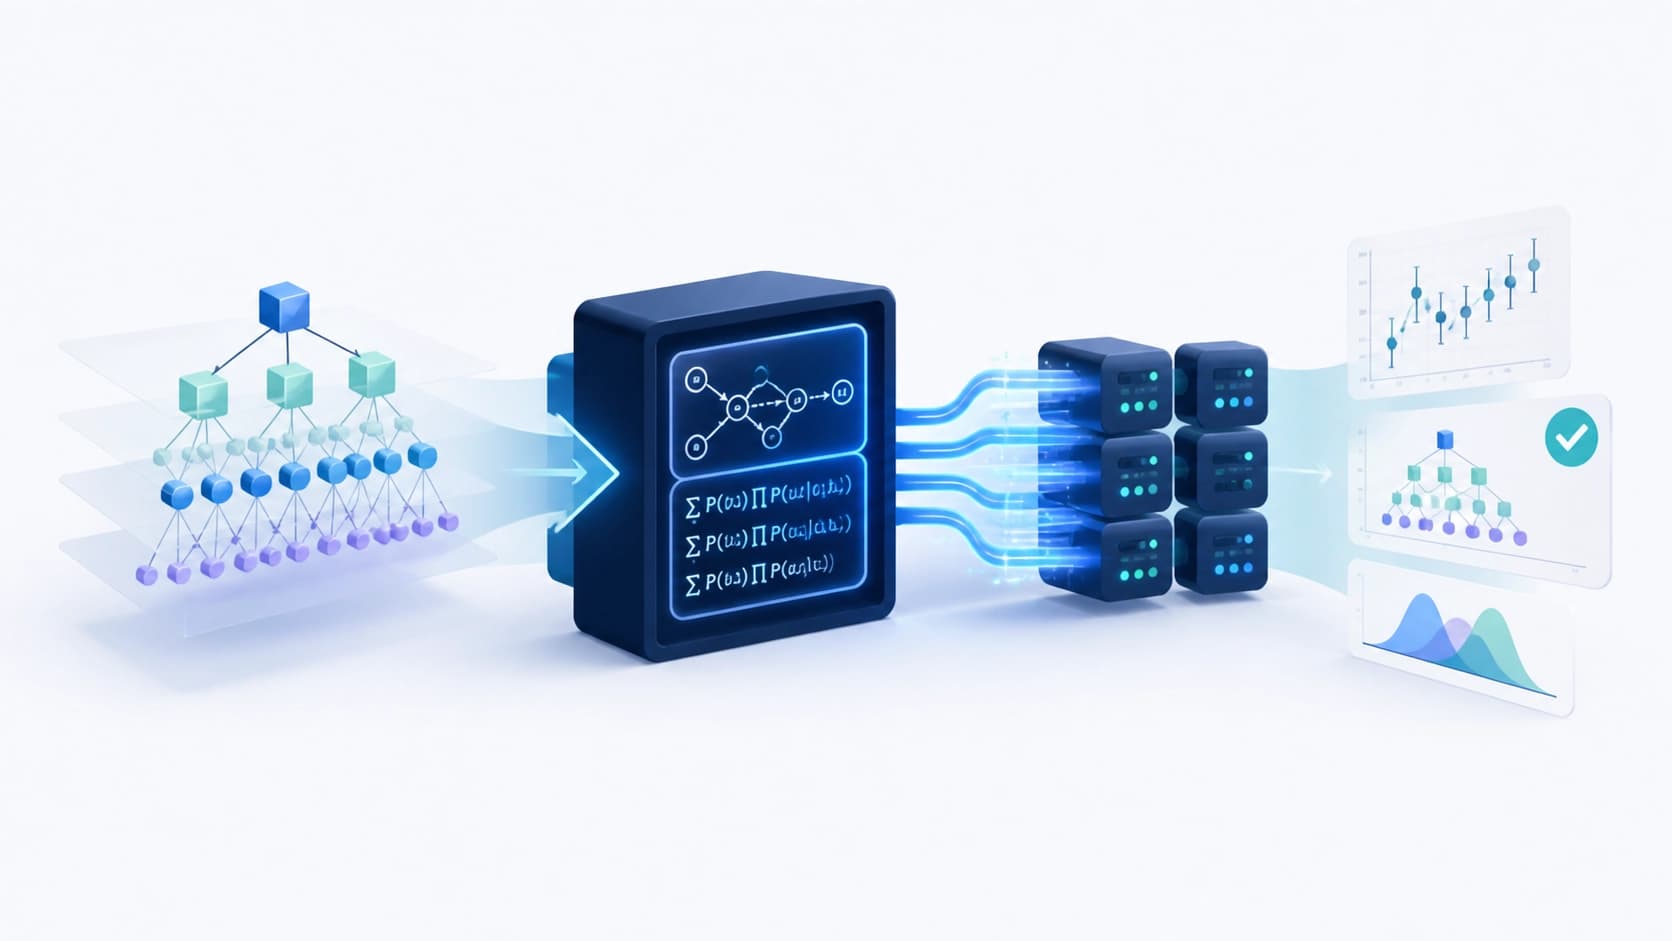
Data bersarang dan masalah lama inferensi kausal
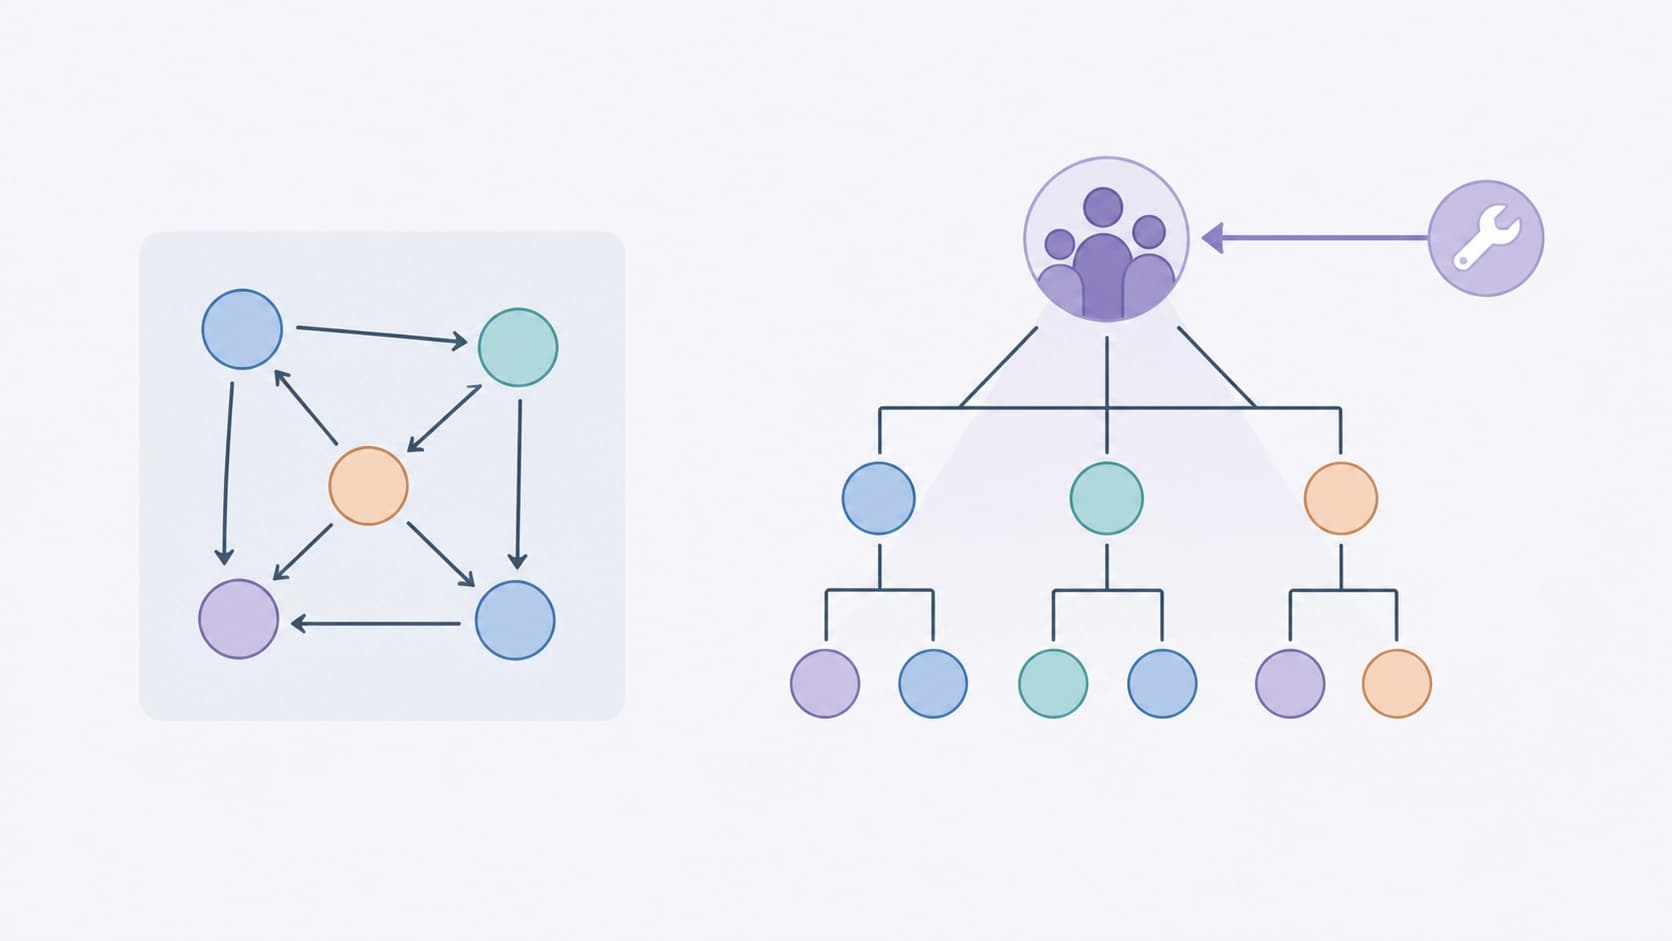
Metode inferensi kausal klasik bekerja cukup baik ketika observasi saling independen. Namun begitu data memiliki hierarki — siswa di dalam kelas, pasien di dalam klinik, karyawan di dalam departemen — skema naif mulai menipu. Kelompok bersama menciptakan korelasi antar objek yang keliru dianggap sinyal oleh model, sementara intervensi yang terjadi di tingkat atas (misalnya, perubahan kondisi pada seluruh kelas) sama sekali tidak punya tempat untuk "disambungkan".
Inilah yang dibahas dalam pracetak baru arXiv:2608.24500 di bagian stat.ML — "Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR". Karya ini terbit pada 25 Agustus 2026, disiapkan oleh kelompok sembilan penulis — Janis Aiad, Aghiles Drali, Aymen El Ouadrhiri, Anass Ettahiri, Yasser Oufqir, Simon Patry, David Cortes, Marianne Clausel, dan Emilie Devijver. Tersedia PDF, versi HTML, dan sumber TeX; temanya adalah pembelajaran mesin dan kecerdasan buatan.
Materi ini menarik bukan karena modelnya yang terbaru, melainkan karena upayanya merakit pipeline lengkap yang dapat direproduksi: dari penulisan formal graf hingga angka konkret yang bisa dipertahankan dalam artikel atau laporan di hadapan klien.
Apa yang ditawarkan penulis
Yang dibahas adalah pipeline untuk hierarchical structural causal models (HSCM). Pipeline ini terbuka dan dirancang agar dapat diskalakan: logika yang sama harus mampu menangani contoh pembelajaran kecil maupun data dengan jumlah kelompok yang besar.
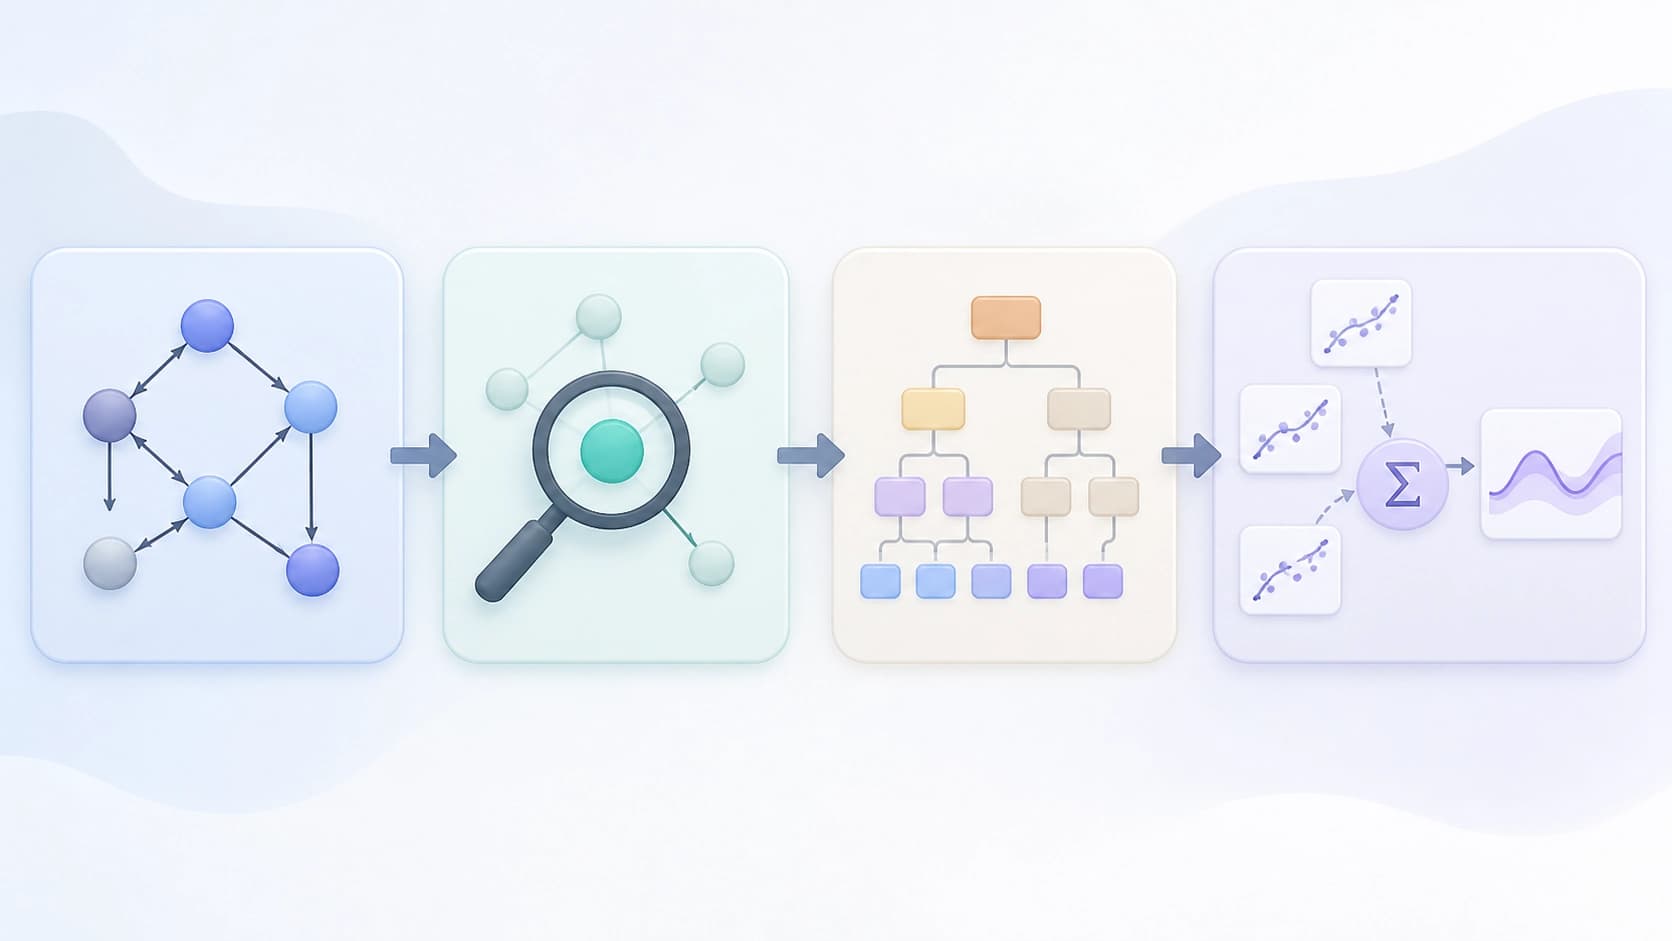
Konstruksinya dirakit dari empat lapisan:
- transformasi graf — penyiapan struktur yang mendeskripsikan dependensi antar tingkat;
- identifikasi simbolik melalui do-calculus di pustaka pyAgrum — mesin secara otomatis menentukan efek mana yang dapat disimpulkan dari data yang tersedia, dan menghasilkan ekspresi yang sesuai;
- penerjemahan ekspresi tersebut ke rumus tertutup HSCM — hasil simbolik diubah menjadi sesuatu yang dapat dihitung dalam kerangka model hierarkis;
- estimasi numerik berdasarkan model probabilistik lokal yang sudah dicocokkan.
Logikanya di sini pada dasarnya dua tahap. Pertama, ditentukan apakah efek tersebut teridentifikasi secara prinsip — ini pertanyaan matematika, bukan data. Baru setelah itu statistik diaktifkan: estimasi, galat, stabilitas.
Abstract syntax tree sebagai kunci skala
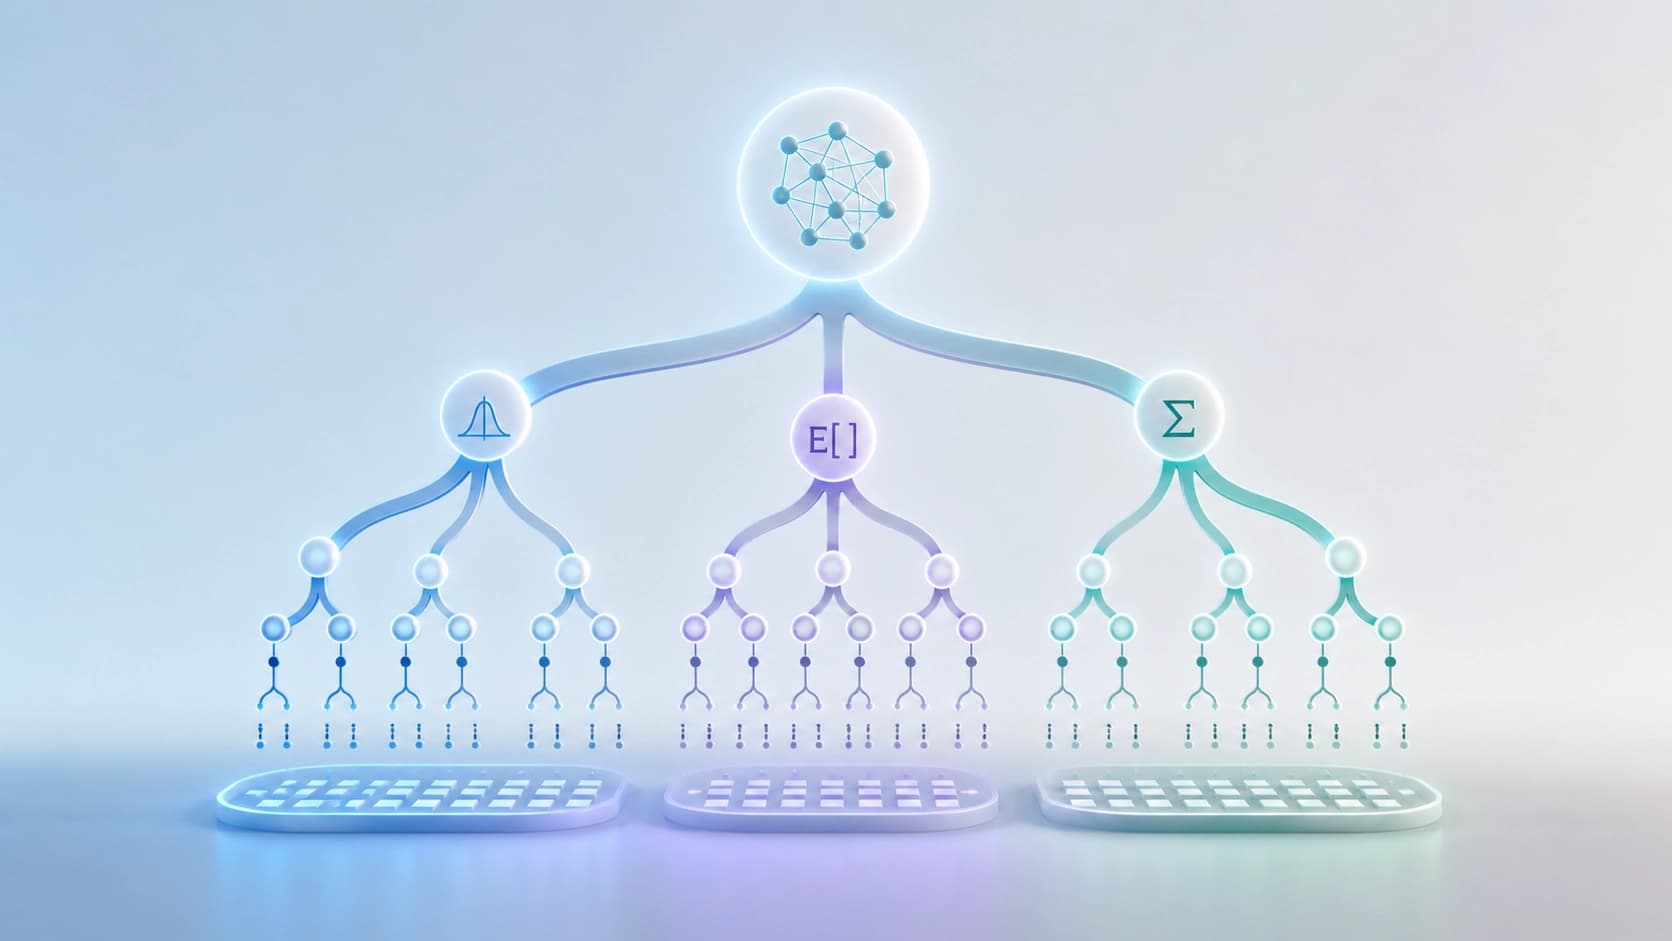
Temuan teknis utama karya ini adalah abstract syntax tree (AST) yang diadaptasi. Rumus teridentifikasi dari pyAgrum tidak dihitung "secara langsung": rumus itu diuraikan menjadi pohon, dan daun-daun pohon tersebut menjadi subtugas independen dari tiga jenis — perhitungan densitas, penghitungan nilai harapan matematis, dan marginalisasi.
Mengapa ini penting? Subtugas yang dihasilkan dapat dihitung secara paralel dan hasil antara dapat di-cache. Alih-alih satu ekspresi besar yang jika terjadi kesalahan pada langkah awal akan merusak semuanya, muncul sekumpulan bagian independen yang masing-masing dapat diverifikasi secara terpisah. Pada intinya, penulis mengubah masalah daya komputasi menjadi masalah organisasi komputasi.
Pengujian pada Project STAR
Sebagai contoh substantif diambil eksperimen STAR (Student-Teacher Achievement Ratio) yang dilakukan pada tahun 1985 di negara bagian Tennessee, Amerika Serikat. Ini adalah kumpulan data hierarkis rujukan: ia dibuat untuk menilai pengaruh ukuran kelas terhadap prestasi belajar, dan observasinya bersarang di dalam kelas. Struktur seperti ini adalah lahan uji ideal untuk HSCM, karena intervensi di sini secara alami terjadi pada tingkat kelas, bukan pada anak secara individual.
Sebelum beralih ke data nyata, penulis menguji pipeline pada motif kanonis HSCM dan skenario benchmark yang jawaban sebenarnya sudah diketahui sebelumnya. Ini urutan yang masuk akal: pertama memastikan metode menemukan jawaban yang benar di tempat yang jawabannya diketahui, baru kemudian menerapkannya pada data yang tidak dapat diverifikasi. Penerapan akhirnya — hasil matematika di taman kanak-kanak dalam kerangka STAR.
Apa yang ditunjukkan hasilnya
Kesimpulannya cukup menyadarkan, dan di situlah nilainya.
Pertama, model dasar datar yang mengabaikan hierarki memang memulihkan asosiasi — tetapi tidak mampu mengodekan intervensi pada tingkat kelas. Korelasi "kelas lebih kecil — nilai lebih tinggi" dan efek kausal dari pengecilan kelas adalah dua hal berbeda, dan yang pertama tidak menggantikan yang kedua.
Kedua, identifikasi simbolik saja tidak cukup. Bahkan jika rumus diturunkan dengan benar, untuk inferensi hierarkis praktis diperlukan lapisan numerik yang berfungsi.
Dari sini muncul tesis ketiga: estimasi yang dapat diskalakan dan pengujian stabilitas numerik bukanlah lampiran pada metode, melainkan bagian intinya. Ekspresi yang indah tetapi tidak dapat dihitung atau runtuh akibat perubahan data sekecil apa pun tidak memiliki nilai ilmiah. Karena itu dalam pipeline ini begitu banyak perhatian diberikan pada dekomposisi komputasi dan kendali stabilitas.
Mengapa ini diperlukan di luar STAR
Data hierarkis jauh lebih umum daripada yang tampak. Pendidikan, kedokteran, uji A/B dengan pengelompokan, survei sosial per wilayah, pengukuran industri per batch — di mana-mana ada sarang, dan di mana-mana ada godaan untuk mengabaikannya demi kesederhanaan.
Nilai karya ini terletak pada tawarannya bukan sekadar trik terpisah, melainkan prosedur yang dapat direproduksi. Kode terbuka, identifikasi otomatis melalui pyAgrum, transisi formal ke rumus yang dapat dihitung, subtugas independen — semua ini bersama-sama menurunkan ambang masuk: peneliti tidak perlu menurunkan sendiri rumus untuk setiap struktur graf baru.
Keterbatasan dan akal sehat
Perlu diingat bahwa ini adalah pracetak, bukan publikasi yang telah melalui tinjauan sejawat: arXiv:2608.24500 dalam versi v1, DOI 10.48550/arXiv.2608.24500. Hasil pada motif kanonis dan satu kumpulan data adalah pengujian yang baik, tetapi bukan bukti universal.
Selain itu, setiap inferensi kausal bersandar pada asumsi tentang struktur graf. Pipeline ini mengotomatiskan komputasi dan membuatnya lebih transparan, tetapi tidak menghapus pertanyaan "apakah kita sudah mendeskripsikan dunia dengan benar". Jika grafnya salah, efek yang dihitung dengan rapi tetap akan menjadi kesesatan yang dihitung dengan rapi.
Karena itulah kesimpulan praktis utama artikel ini terdengar membumi: identifikasi tanpa estimasi tidak berguna, estimasi tanpa stabilitas berisiko, dan data bersarang menuntut tingkat tersendiri dalam model, jika tidak, intervensi pada tingkat kelompok tidak akan punya apa pun untuk dijadikan acuan.


