Simulator tidak mampu mengikuti sistem nyata
Menyebarkan klaster sungguhan untuk melayani model bahasa besar itu mahal, dan sering kali mustahil: tidak ada perangkat keras, tidak ada anggaran, tidak ada waktu untuk menunggu. Karena itu, pemodelan sistem sudah lama menjadi alat kerja bagi para peneliti: hitung dulu di simulator, baru kemudian beralih ke perangkat keras.
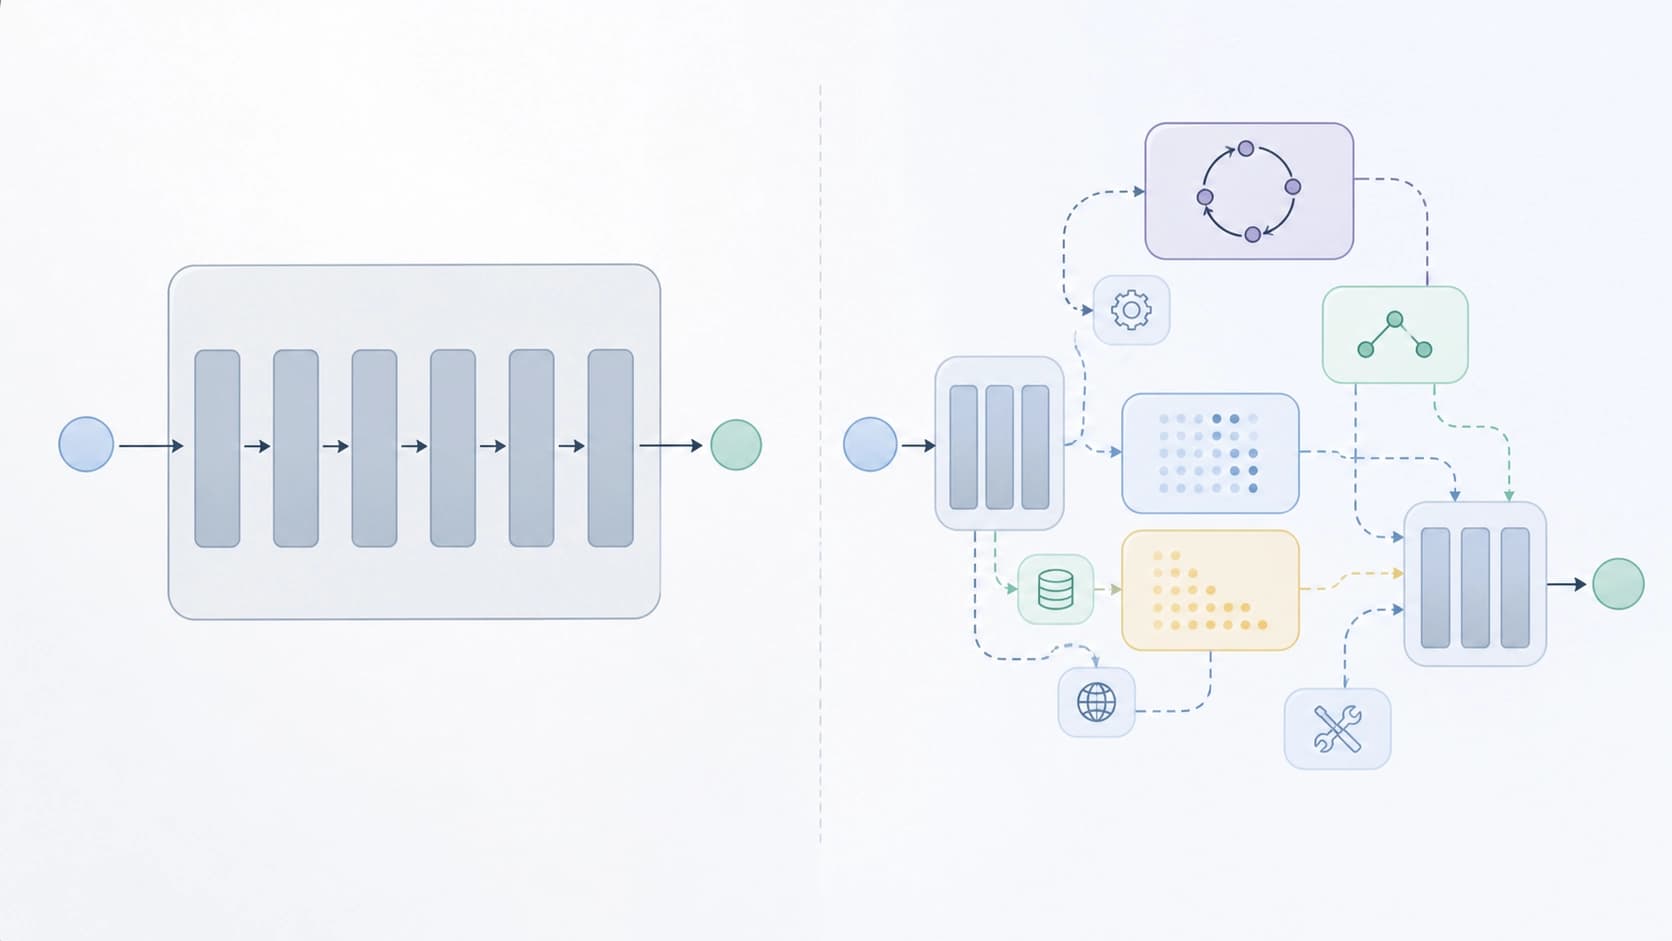
Masalahnya, bidang ini sendiri bergerak lebih cepat daripada laju pengembangan simulator. Beban kerja baru — skenario agen, di mana model memanggil alat dan bekerja dalam siklus, skema dengan fase prefill dan decode yang terpisah — tidak lagi muat dalam pipeline monolitik yang tertanam di simulator yang ada. Setiap mekanisme baru harus dipasang dari samping melalui perombakan inti yang menyakitkan. Akibatnya, jurang antara apa yang benar-benar berjalan di produksi dan apa yang mampu direproduksi simulator semakin melebar.
Ide: simulator yang membangun dirinya sendiri
Masalah ini diambil alih oleh tim peneliti — Wonung Kim, Hyunmin Choi, Minsu Kim, Jaehong Cho, Yeongwook Kim, dan Jongse Park. Preprint mereka arXiv:2608.24650 (cs.AR, cs.AI) berjudul "Simthesizer: An Agent-Driven Simulation Framework for LLM Serving Systems".
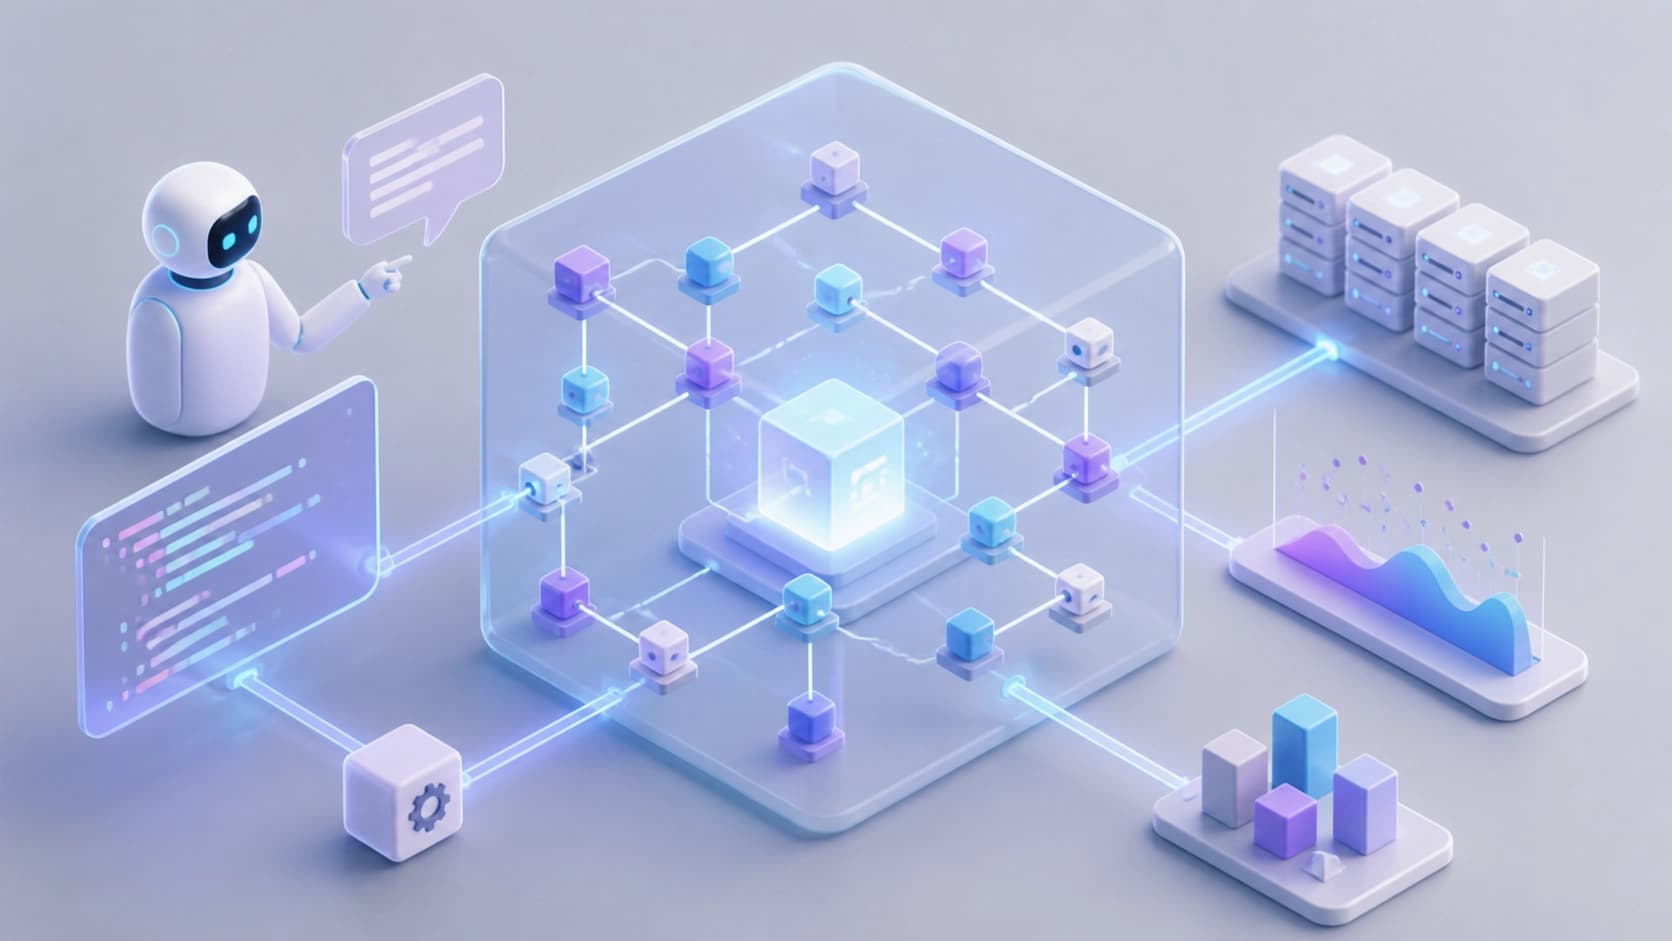
Poin utama dari pemikiran ini adalah: tidak perlu menulis simulator lain untuk sekumpulan mekanisme hari ini — ia akan usang sebelum dirilis. Simthesizer perlu dibangun agar dapat memperluas dirinya sendiri seiring munculnya kebutuhan baru. Dan bukan oleh programmer yang menghabiskan sebulan membaca kode orang lain, melainkan oleh agen yang memahami permasalahan dalam bahasa alami dan mampu mengolahnya di dalam simulator.
Satu graf dinamis alih-alih sekumpulan modul
Dasar teknis dari ide ini adalah infrastruktur yang dapat dikomposisi. Dalam Simthesizer, seluruh alur kerja pelayanan dinyatakan secara seragam: bukan hanya komputasi itu sendiri, tetapi juga keputusan pengendalian yang mengoordinasikan proses tersebut — yakni penjadwal, urutan pemrosesan, alokasi sumber daya. Semua ini dijelaskan sebagai satu graf dinamis yang berubah selama simulasi berlangsung.
Manfaat praktisnya jelas: ketika fungsionalitas baru tidak perlu dipasang ke sambungan yang terpatri kaku antar subsistem, melainkan cukup menambahkan simpul ke gambaran keseluruhan, biaya perluasan turun secara drastis. Di sinilah sebelumnya muncul "perombakan invasif" — seluruh logika tersebar di seluruh kode, dan setiap mekanisme baru menyentuh separuh simulator.
Agen penyintesis: permintaan dengan kata-kata, bukan fork kode
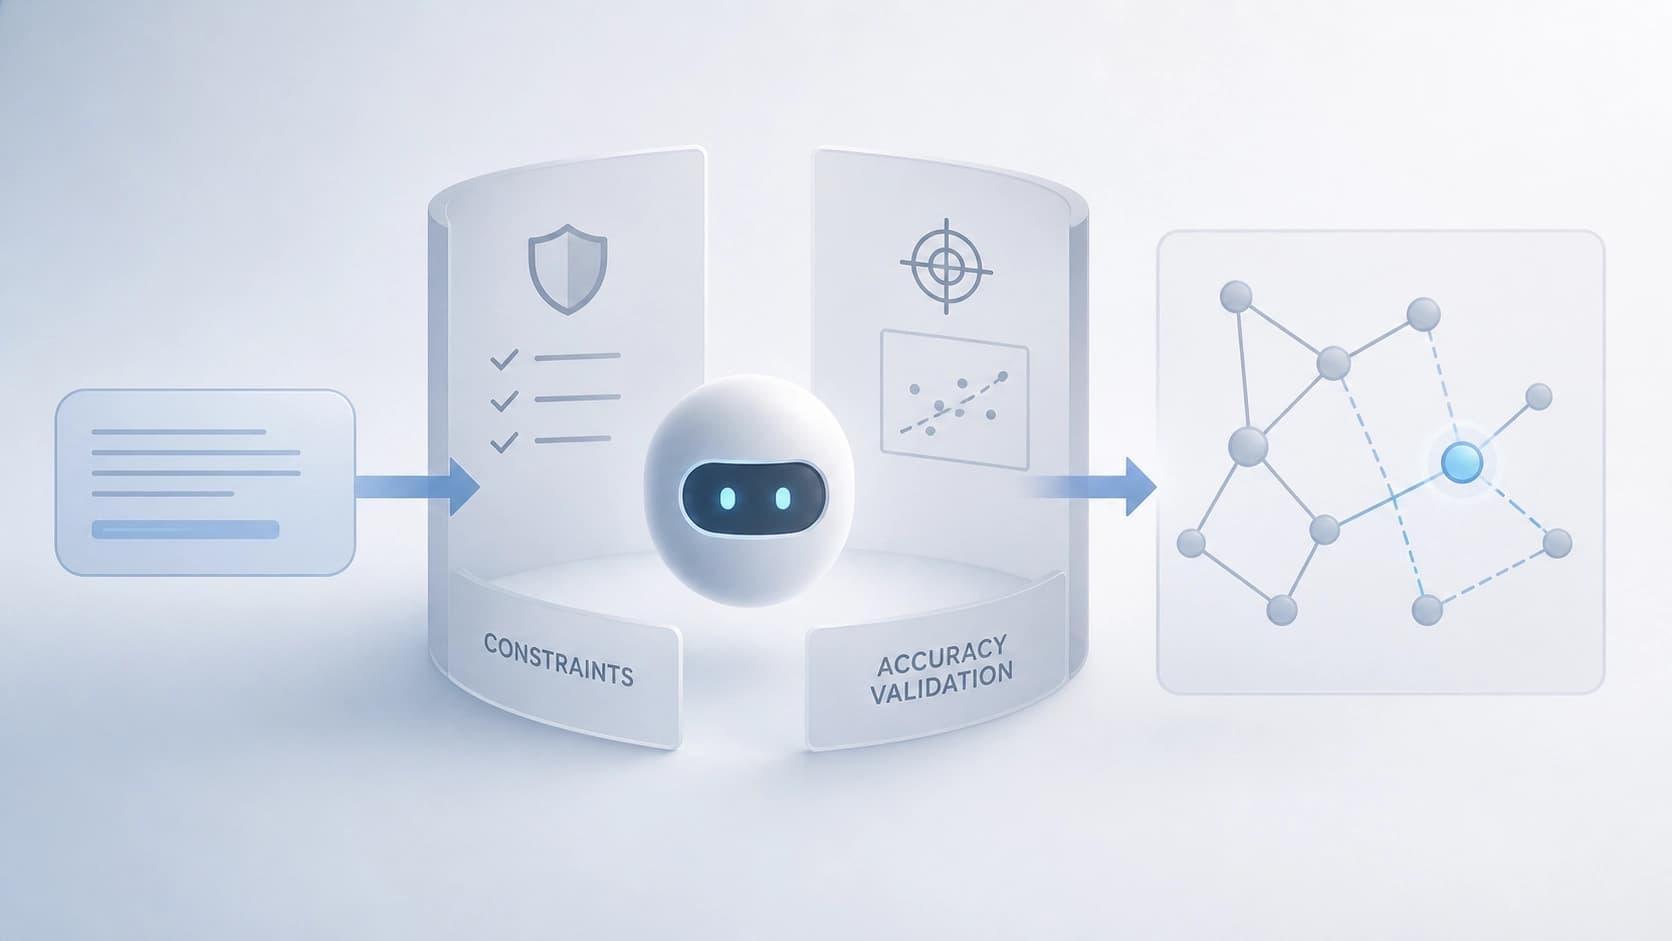
Elemen kedua adalah Synthesizer agent, yang oleh penulis digambarkan sebagai "coding agent di bawah kendali" (harnessed coding agent). Tugasnya adalah menerjemahkan permintaan tentang fungsi yang dibutuhkan, yang dirumuskan dalam bahasa manusia biasa, ke dalam representasi abstrak di dalam simulator.
Kata kuncinya di sini adalah "di bawah kendali". Agen tidak menulis sesuka hati: ia bekerja dalam batasan yang spesifik untuk simulator tertentu, dan hasilnya melewati validasi akurasi pemodelan (fidelity validation). Tanpa langkah ini, gagasan tersebut akan berubah menjadi generator kode yang tampak masuk akal tetapi salah. Satu detail penting lagi: agen mengembangkan satu simulator bersama, bukan memperbanyak simulator baru untuk setiap fitur — jika tidak, kita hanya akan mendapatkan kebun binatang fork yang tidak kompatibel, hanya saja dibuat secara otomatis.
Seberapa baik ini bekerja
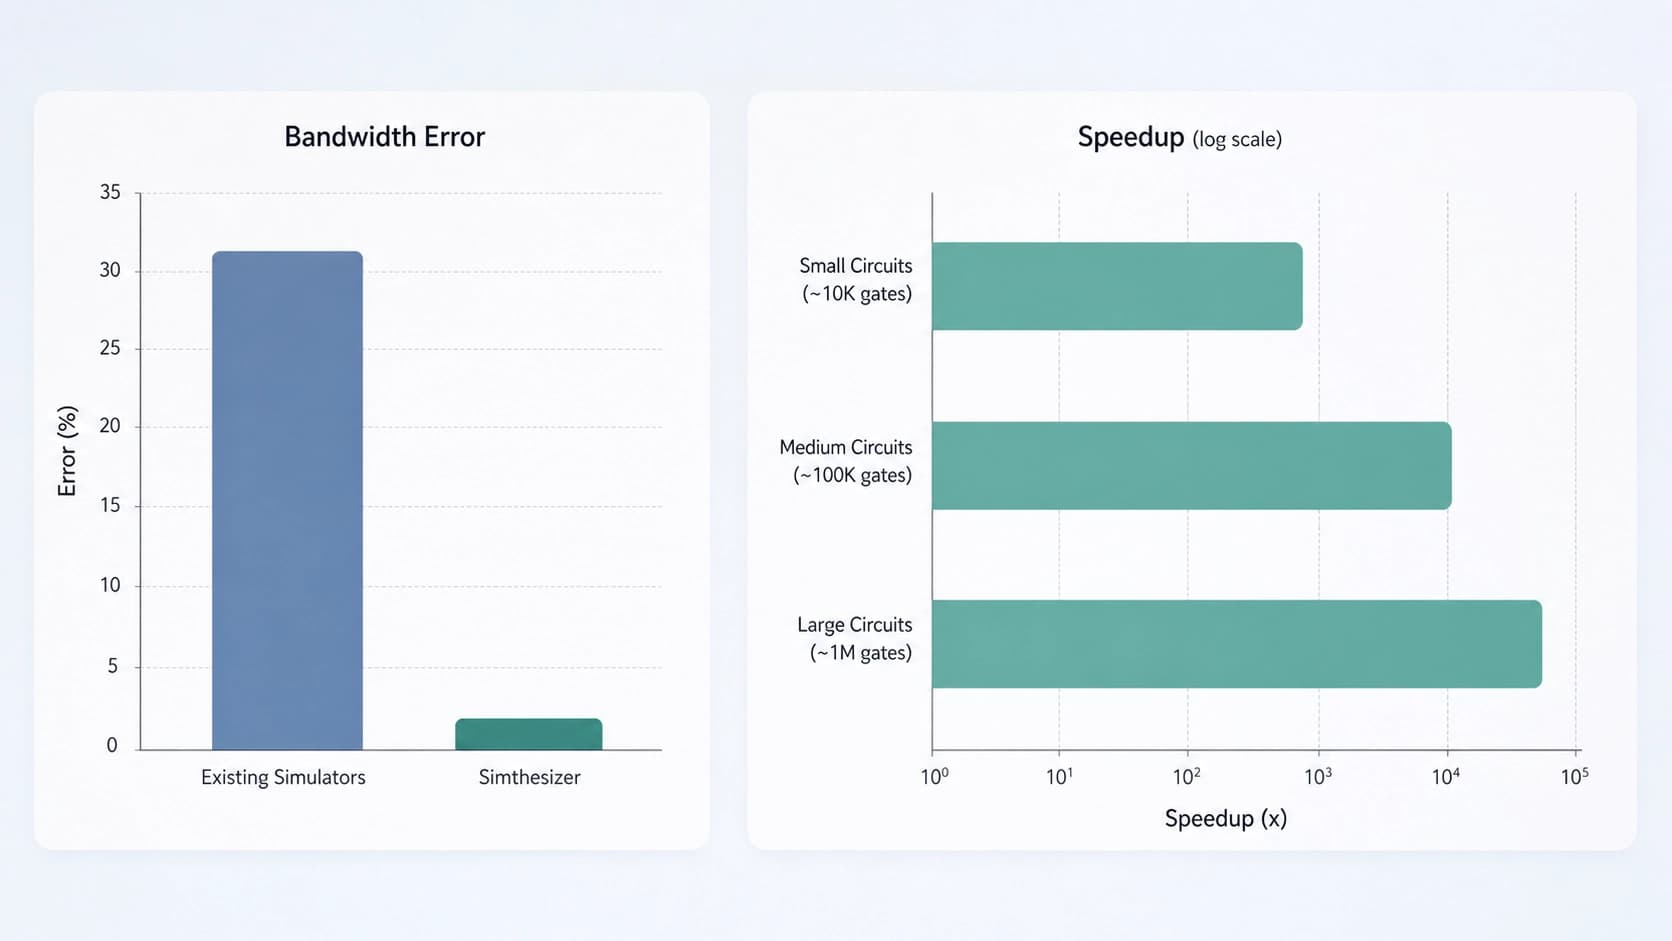
Penulis menguji pendekatan ini bukan pada data sintetis, melainkan dengan membandingkannya dengan kenyataan. Ekstensi yang dibangun di atas Simthesizer mereproduksi sistem berbasis vLLM dengan kesalahan rata-rata throughput sebesar 2,51%. Pada ekstensi di simulator yang ada, metrik yang sama adalah 6,03%. Selisihnya lebih dari dua kali lipat, dan pada saat yang sama digunakan coding agent yang sama dengan rangka yang sama: artinya keunggulan diberikan oleh arsitektur simulator itu sendiri, bukan oleh pemilihan model pelaksana yang beruntung.
Kecepatannya tidak kalah mengesankan. Pada beban kerja yang identik, Simthesizer memodelkan hingga 284,96 kali lebih cepat daripada LLMServingSim2.0, dan hingga 23,19 kali lebih cepat daripada Vidur. Orde seperti ini mengubah sifat penelitian itu sendiri: alih-alih "menjalankan satu kali dan menunggu", muncul kemungkinan untuk menelusuri puluhan konfigurasi dan membandingkan skenario satu sama lain.
Apa yang ini ubah dan apa yang perlu diingat
Jika pendekatan ini diterima, pergeseran akan terjadi bukan hanya pada angka, tetapi juga pada peran alat itu sendiri. Simulator tidak lagi menjadi artefak beku yang mengejar kenyataan dengan keterlambatan satu hingga dua tahun, melainkan menjadi sistem yang dapat disesuaikan dengan tugas baru dalam satu percakapan. Bagi mereka yang merancang infrastruktur inference, ini berarti siklus pengujian hipotesis yang lebih murah: tidak harus membangun rig terlebih dahulu untuk memahami apakah ide tersebut akan menguntungkan.
Namun ada juga pertanyaan yang penulis biarkan di luar cakupan. Seberapa andal validasi akurasi menangkap kesalahan halus agen — misalnya, ketika simpul baru secara formal berfungsi, tetapi tanpa disadari mengubah perilaku pada kombinasi beban dan timing tertentu? Bagaimana pendekatan ini ditransfer ke hal-hal yang spesifik perangkat keras seperti akselerator nonstandar? Dan akhirnya, pertanyaan kepercayaan tetap terbuka: ketika simulator semakin sering menulis dirinya sendiri, seseorang harus mampu membaca apa yang dihasilkan.
Sementara itu, hasilnya sederhana dan jelas: kombinasi "arsitektur yang dapat dikomposisi plus agen yang dibatasi haknya" memberikan pemodelan yang lebih akurat sekaligus jauh lebih cepat daripada simulator generasi sebelumnya yang rapi tetapi kaku. Ini persis kasus di mana yang lebih tepat adalah mengubah bukan modelnya, melainkan rancangan alatnya.