
Kebijaksanaan orang banyak terhenti pada keseragaman
Ketika kita perlu memprediksi sesuatu tentang masa depan — perilaku pasar, hasil suatu peristiwa, nasib sebuah teknologi — muncul pemikiran sederhana: semakin banyak model yang ditanya, semakin andal jawabannya. Logikanya tampak kokoh: sistem yang berbeda membuat kesalahan dengan cara yang berbeda, jadi perata-rataan akan menghaluskan kesalahan acak.
Tetapi skema ini menyimpan jebakan. Jika semua peserta "kerumunan" bernalar dengan cara yang mirip, suara mereka bukanlah kesaksian yang independen, melainkan satu opini yang sama, diperbanyak melalui penyalinan. Sepuluh jawaban yang hampir identik tidak menambah informasi dibandingkan satu jawaban; mereka hanya menciptakan rasa percaya diri dan menambah tagihan inferensi.
Justru di sekitar masalah inilah karya "Diverse by Reasoning: Harnessing the Wisdom of LLM Crowds for Future Prediction" dibangun — disiapkan oleh Niropam Chetlapalli, Yiming Liao, Min-Chun Chen, dan Keke Chen. Preprint arXiv:2608.24001 muncul pada 25 Agustus 2026, sehari kemudian versi revisinya terbit, dan artikel itu sendiri diajukan ke IEEE BigData 2026.
Sekadar "lebih banyak model" tidak menyelesaikan masalah
Pengamatan kunci para penulis: berbagai model bahasa besar dapat berperilaku sangat mirip secara berlebihan. Mereka dilatih pada data yang sebanding, cenderung pada rumusan yang serupa dan langkah penalaran yang tipikal. Akibatnya, perluasan daftar peserta secara mekanis tidak menghasilkan keragaman yang menjadi tujuan awalnya.
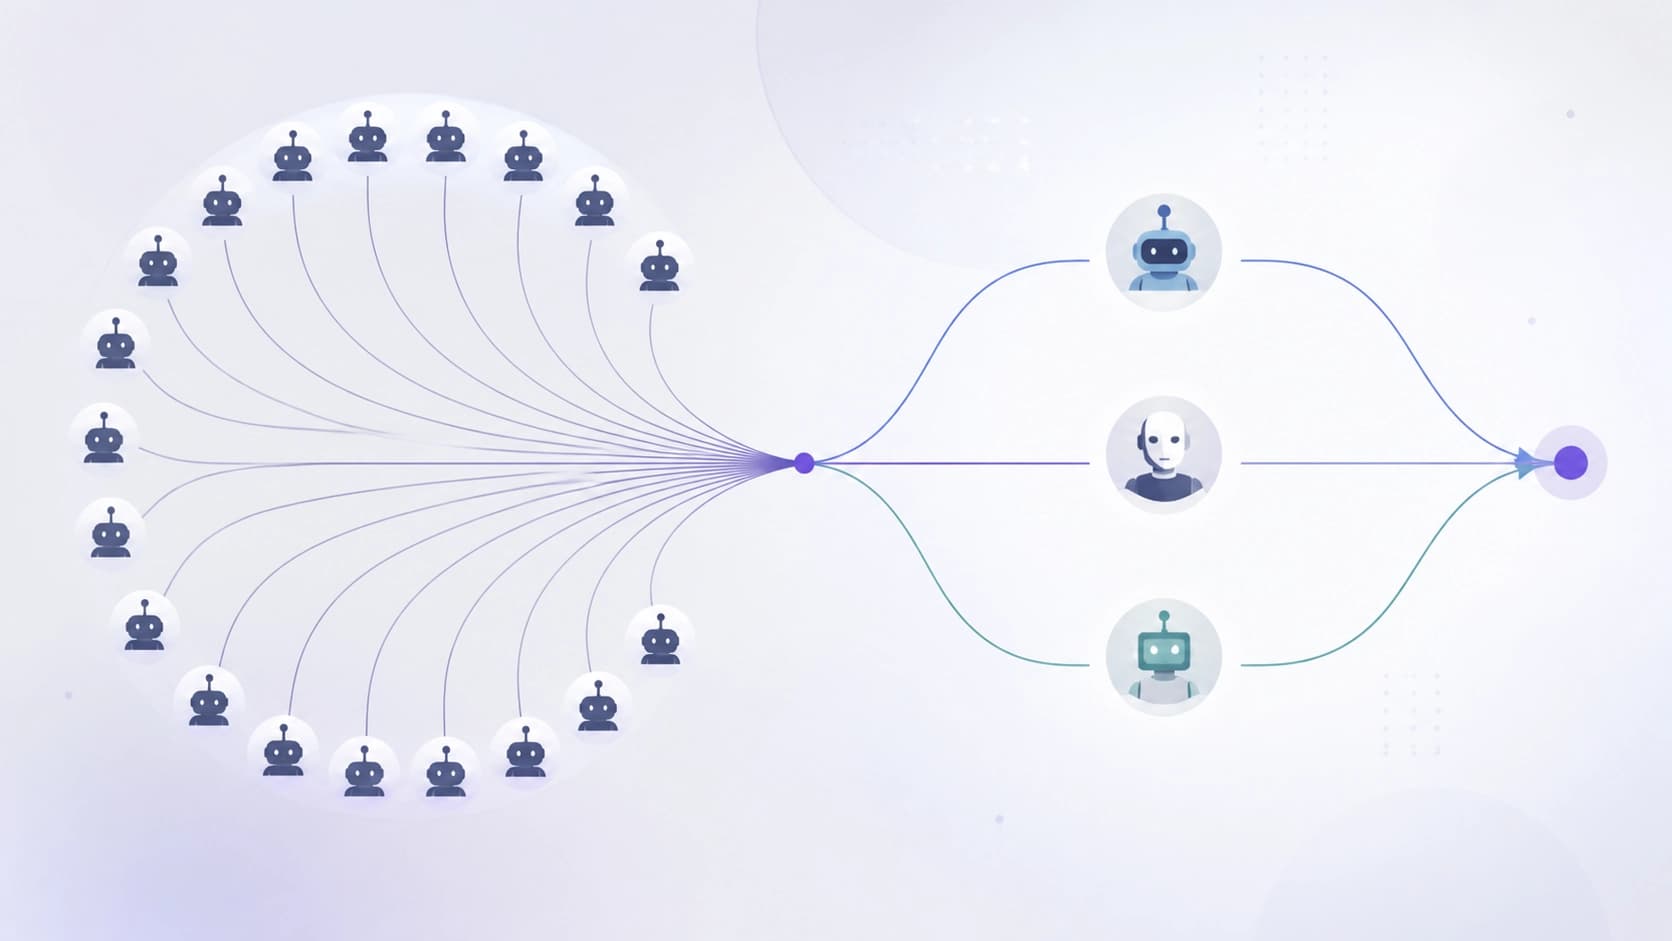
Di sini penting untuk membedakan dua konsep. Kuantitas adalah berapa banyak model yang kita tanyai. Keragaman adalah seberapa berbeda cara mereka sampai pada kesimpulan. Yang kedua tidak otomatis mengikuti yang pertama: bisa saja kita mengumpulkan dua puluh peserta dan mendapatkan dua puluh variasi dari satu pemikiran yang sama.
Metode: model dipilih berdasarkan gaya penalaran, bukan berdasarkan jawaban
Bagaimana seleksi perilaku terlihat
Para penulis mengusulkan kerangka kerja yang mereka sebut berorientasi perilaku. Intinya bukan membandingkan model berdasarkan kebenaran jawaban akhir, melainkan memahami bagaimana mereka berpikir.
Skemanya seperti ini:
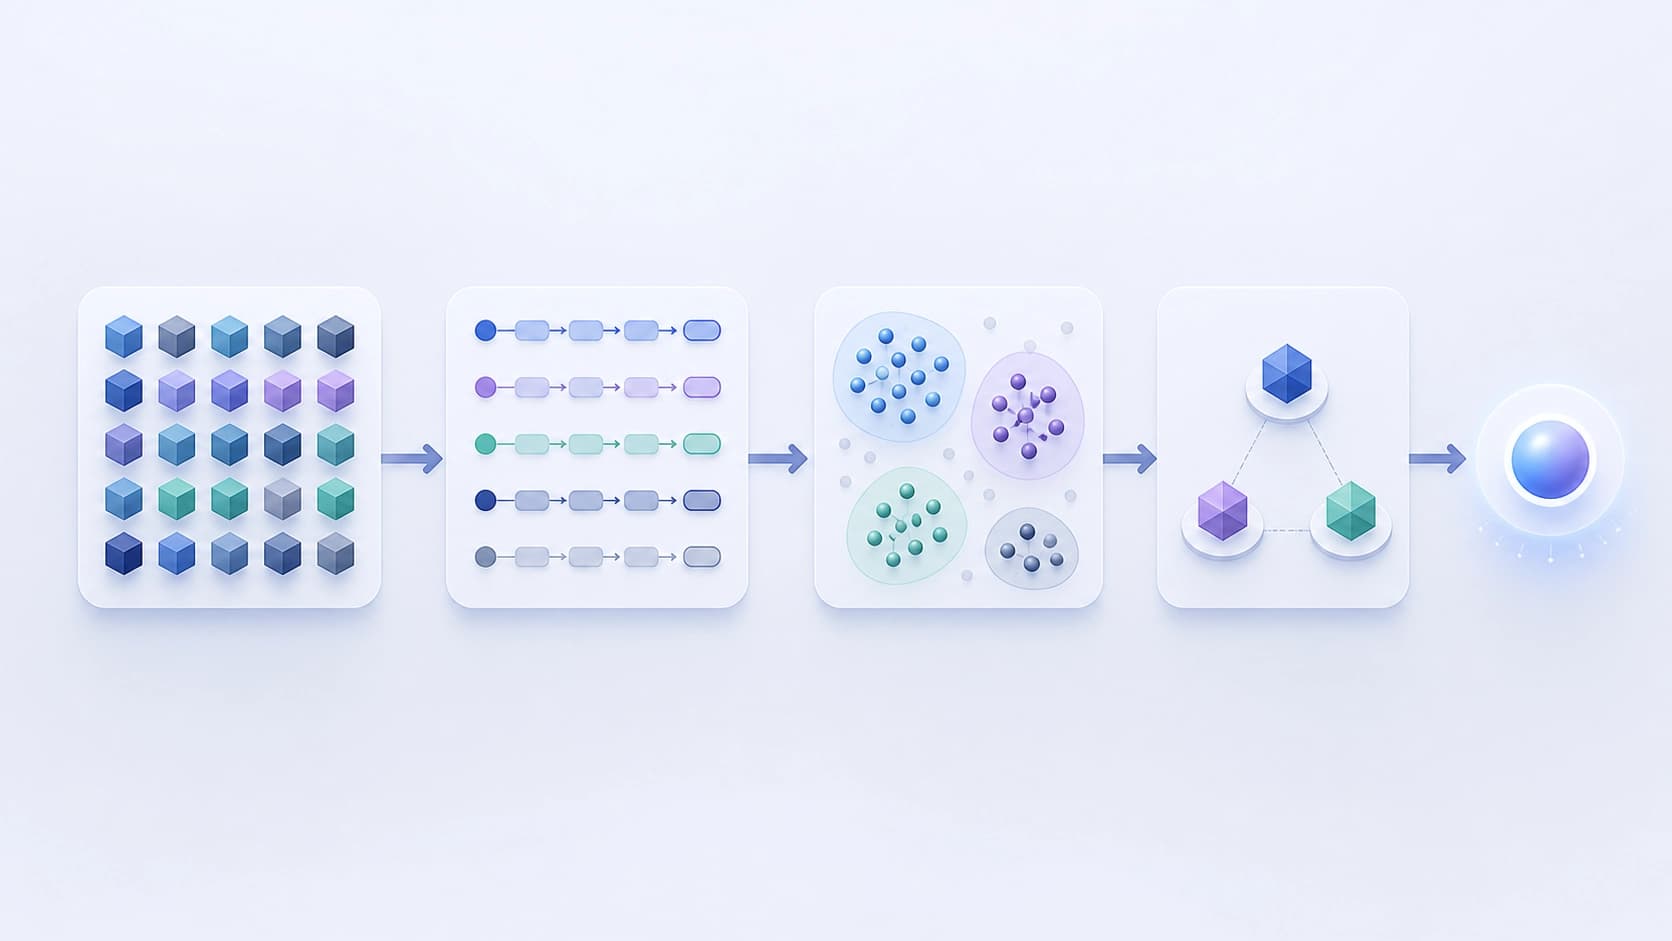
- Setiap model dijalankan pada serangkaian tugas independen yang tidak terkait dengan prediksi masa depan. Yang dikumpulkan bukan sekadar jawaban, melainkan rantai penalaran — reasoning traces itu tadi.
- Berdasarkan jejak tersebut, dibangun profil perilaku: langkah apa yang diambil model, bagaimana ia memecah tugas, di mana ia membuat kesalahan, argumen apa yang digunakannya.
- Model dikelompokkan ke dalam klaster berdasarkan kemiripan perilaku. Untuk ini digunakan algoritma K-means++.
- Dari setiap klaster diambil satu perwakilan — medoid, yaitu model yang paling tipikal untuk kelompoknya.
- "Kerumunan" medoid yang ringkas inilah yang menghasilkan prediksi kolektif.
Idenya, jika dipikirkan, bukanlah hal baru — begitulah cara kerja dalam statistika, ketika dari fitur-fitur yang berkorelasi disisakan satu perwakilan agar tidak menduplikasi informasi yang sama. Kebaruan di sini terletak pada kenyataan bahwa "fitur" menjadi gaya penalaran model bahasa, bukan karakteristik numerik.
Apa yang diuji
Eksperimen dibangun di atas 25 model. Tujuh benchmark pengembangan digunakan untuk mendeskripsikan dan memisahkan model berdasarkan perilaku, sedangkan dua benchmark terpisah — khusus untuk prediksi masa depan — digunakan untuk menilai kualitas "kerumunan" yang dihasilkan. Pemisahan ini bersifat mendasar: tugas yang menjadi dasar pembentukan profil tidak sama dengan tugas yang menjadi dasar penghitungan hasil. Jika tidak, yang terjadi adalah pelatihan dengan mengintip, dan angkanya hampir tidak berarti apa-apa.
Hasil: tiga model mengalahkan dua puluh lima
Yang paling mencolok dalam karya ini adalah hasil perbandingannya. "Kerumunan" yang hanya terdiri dari tiga model medoid, yang disusun melalui pengelompokan perilaku, tampil lebih baik daripada pemungutan suara biasa atas seluruh 25 model sekaligus. Dan ini berlaku untuk kedua benchmark prediksi.
Pada saat yang sama, penghematannya cukup besar: jumlah panggilan ke model berkurang 88%, dan biaya inferensi — sekitar 80%. Untuk praktik, ini hampir lebih penting daripada peningkatan akurasi itu sendiri. Sistem prediksi sering terhenti bukan pada kualitas jawaban, melainkan pada harganya: jika untuk setiap pertanyaan perlu menanyai dua lusin model, solusinya menjadi tidak menguntungkan jauh sebelum menjadi tidak akurat.
Dari sini muncul kesimpulan yang tidak terduga: komposisi "kerumunan" lebih berbobot daripada ukurannya. Dua puluh lima model bukanlah keunggulan otomatis dibandingkan tiga, jika kedua puluh lima itu pada dasarnya mengulangi satu sama lain.
Tidak semua keragaman sama-sama bermanfaat
Para penulis menarik satu lagi kesimpulan cermat yang mudah terlewat. Ternyata, yang penting bukanlah memaksimalkan keragaman sebagai demikian, melainkan representativitas — sejauh mana peserta yang dipilih mencerminkan kutub-kutub perilaku berbeda yang ada di antara model.
Perbedaannya bersifat mendasar. Kita bisa mengumpulkan tiga model yang berbeda satu sama lain secara acak dan sepele — dan mendapatkan derau alih-alih sinyal. Atau kita bisa memilih satu dari setiap kelompok perilaku yang benar-benar berbeda — dan mendapatkan himpunan ringkas yang mencakup ruang solusi. Yang pertama adalah keberagaman yang serampangan, yang kedua adalah keberagaman yang terstruktur. Yang berhasil adalah yang kedua.
Di sini muncul paralel dengan keahlian biasa. Komisi yang baik bukanlah yang beranggotakan lebih banyak orang, melainkan yang di dalamnya terwakili pendekatan dan sudut pandang yang berbeda. Lima spesialis dari bidang berbeda biasanya lebih berguna daripada lima belas lulusan dari satu jurusan yang sama.
Apa artinya ini dalam praktik
Bagi mereka yang membangun layanan prediksi di atas model bahasa, kesimpulan artikel ini memberikan resep yang cukup konkret:
- Jangan mengejar panjangnya daftar model. Memperluas kumpulan tanpa analisis perilaku berarti membayar untuk jawaban yang terduplikasi.
- Ukur perilaku dulu, baru pilih komposisi. Menjalankan model pada tugas-tugas lain dan melakukan pengelompokan memberikan gambaran jelas tentang siapa dalam kumpulan itu yang benar-benar berbeda.
- Hemat secara sadar. Pengurangan jumlah panggilan hingga satu orde besarnya sambil mempertahankan atau meningkatkan akurasi mengubah ekonomi produk, bukan hanya karakteristik teknisnya.
- Ingat batasannya. Semua ini diuji pada kumpulan spesifik 25 model dan dua benchmark prediksi; memindahkan angka-angka itu secara langsung ke domain lain dan model lain tidaklah bijak.
Gagasan utama karya ini terdengar hampir manusiawi: nilai pendapat kolektif tidak bertumpu pada jumlah suara, melainkan pada kenyataan bahwa suara-suara itu benar-benar berbeda. Diterapkan pada model bahasa, ini berarti yang perlu diukur bukanlah daftar nama, melainkan gaya berpikir — dan berdasarkan itulah tim disusun.


