Mengapa menilai agen suara begitu sulit diotomatiskan
Agen suara percakapan bukanlah satu model, melainkan sebuah pipeline: pengenalan ucapan, penalaran, pemanggilan alat, pembuatan respons, sintesis, dan streaming audio. Kegagalan di tahap mana pun tidak bersifat lokal — ia menjalar ke tahap berikutnya dalam rantai dan muncul di dalam dialog itu sendiri. Itulah sebabnya menilai kualitas interaksi hanya masuk akal secara menyeluruh, end-to-end, bukan per komponen.
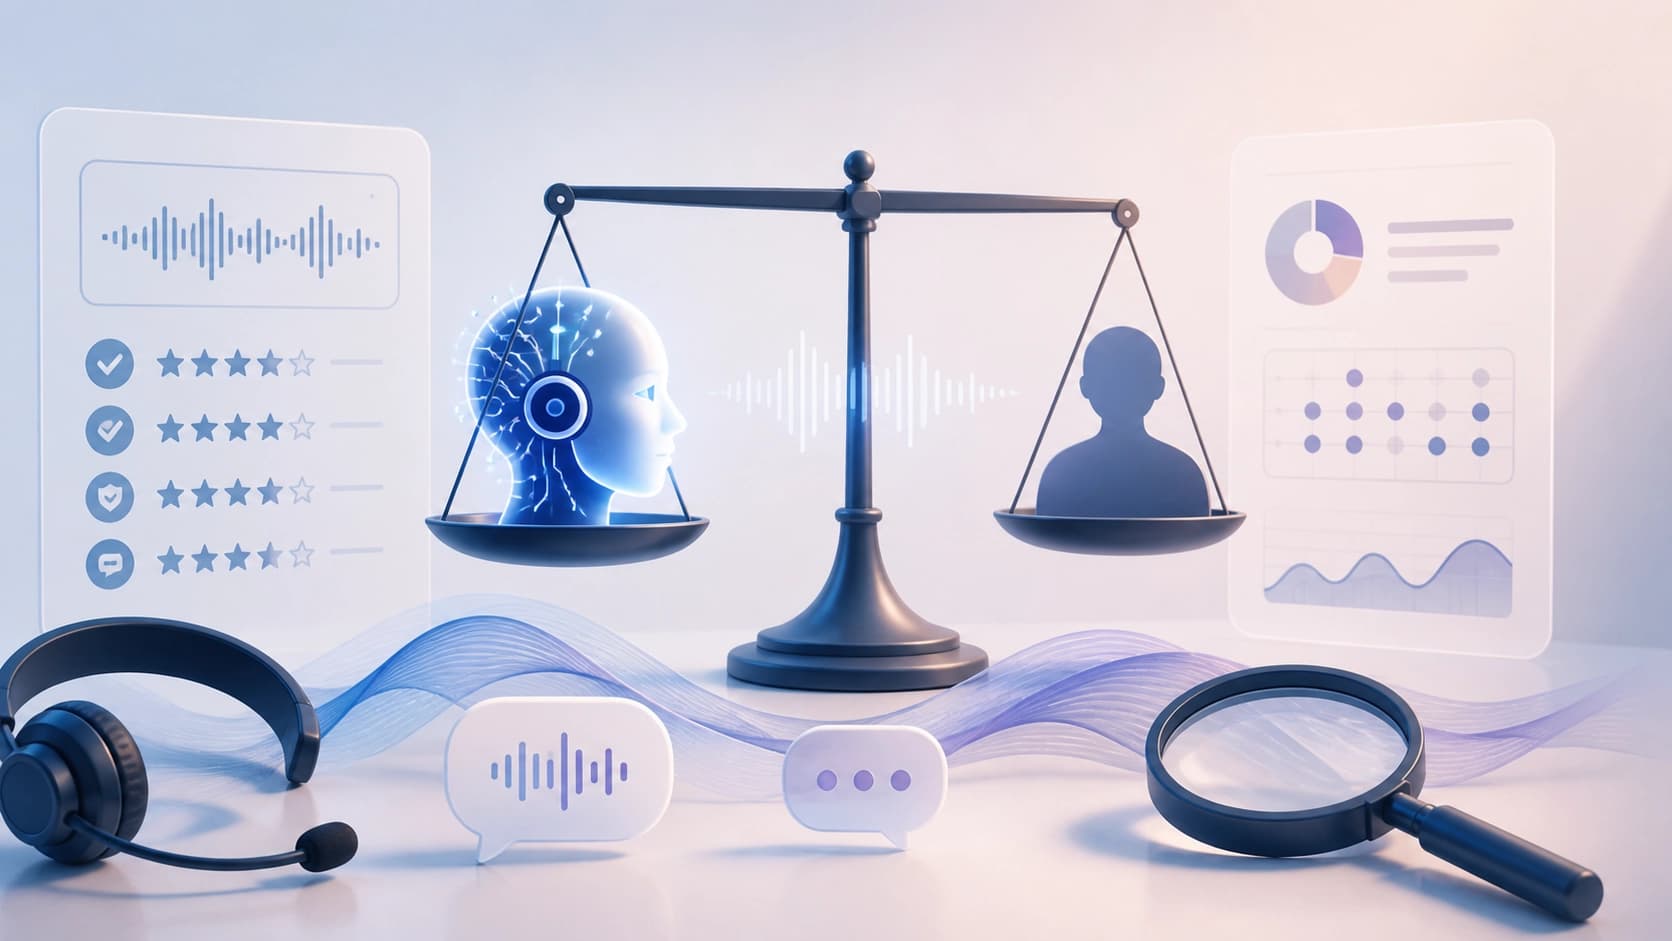
Mempekerjakan penilai manusia itu mahal dan merepotkan: mereka tidak bisa diskalakan ke ratusan ribu percakapan, dan perhatian mereka menurun menjelang akhir shift. Jalan keluar yang wajar adalah menyerahkan penilaian kepada model bahasa. Preprint arXiv terbaru:2608.24314 (Anupam Purwar, Shashank Singh, Kritika Srivastava) justru menguji seberapa masuk akal jalan keluar itu dan di mana ia gagal.
Bagaimana penulis menguji hakim LLM
Eksperimen dibangun di atas percakapan nyata agen suara dari dua industri — telekomunikasi dan ritel. Penilaian manusia dibandingkan dengan putusan GPT-4.1 dan GPT-5, dan bukan berdasarkan satu skala umum, melainkan sepuluh metrik: sebagian menggambarkan kualitas percakapan itu sendiri, sebagian lagi keamanan.
Tiga konfigurasi, bukan satu
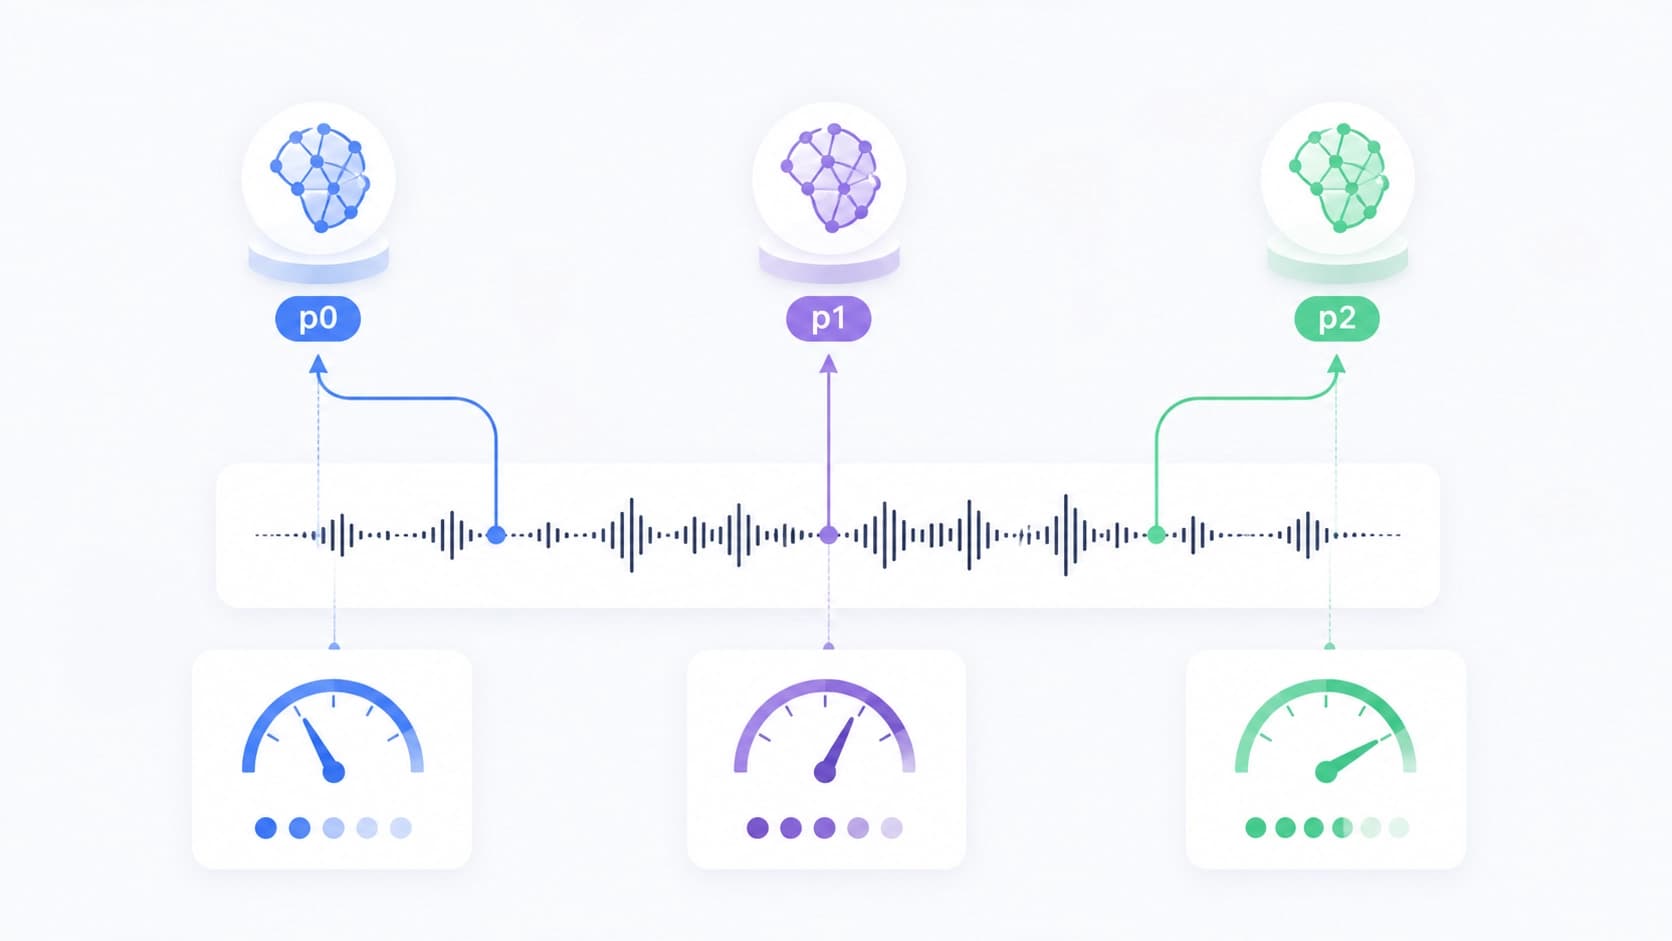
Dialog yang sama dijalankan melalui tiga skema penilaian — p0, p1, dan p2. Maksud latihan ini sederhana: jika putusan berubah tergantung bagaimana rubrik disusun, berarti hakim mengukur bentuk instruksi, bukan kualitas percakapan. Metrik apa pun yang "bergerak" di antara konfigurasi tidak layak untuk otomatisasi — setidaknya tanpa catatan.
Apa yang sebenarnya dibandingkan
Kesepakatan agregat — persentase kecocokan antara manusia dan model — hanyalah lapisan teratas. Penulis menggali lebih dalam: mereka melihat korelasi per metrik secara terpisah, memeriksa seberapa stabil penilaian di dalam kelompok manusia, dan mengurai perbedaan sistematis antara manusia dan LLM. Analisis semacam ini memungkinkan kita memahami atribut percakapan mana yang dapat dinilai secara otomatis, dan mana yang berbenturan dengan konteks dan interpretasi.
Di mana hakim LLM keliru
Kesimpulan utamanya terdengar lebih seperti peringatan daripada promosi metode: keandalan penilaian otomatis tidak seragam — ia bergantung pada metrik tertentu dan pada konfigurasi. Model hakim yang sama memberikan hasil yang kuat pada sebagian skala dan menurun cukup jelas pada skala lainnya.
Recovery Turn Count
Metrik ini menghitung berapa banyak giliran yang dibutuhkan agen untuk menarik percakapan keluar dari kegagalan. Penilaian otomatis di sini tidak andal: hakim tidak selalu membedakan pemulihan yang bermakna dan formulasi yang kebetulan berhasil. Dialog yang oleh manusia disebut terselamatkan, mudah dicatat model sebagai kegagalan — dan sebaliknya.
Metrik keamanan berdasarkan recall
Safety-recall adalah area bermasalah kedua. Logika kesalahannya dapat diprediksi: hakim melihat dialog di mana agen tidak mengatakan hal berbahaya apa pun, lalu memberi skor tinggi, tanpa mempertanyakan apakah peluang untuk melanggar kebijakan itu ada. Pelanggaran yang terlewat adalah jenis kesalahan paling mahal, dan di situlah otomatisasi paling lemah.
Domain mengubah kalibrasi
Keandalan hakim berbeda antara telekomunikasi dan ritel. Kesimpulan praktisnya: ambang batas dan rubrik tidak bisa dipindahkan secara mekanis dari satu industri ke industri lain — apa yang dikalibrasi pada satu domain akan bergeser pada domain lain.
Kalibrasi lebih penting daripada persentase kecocokan
Satu angka kesepakatan meninabobokan kewaspadaan. Model bisa saja cocok dengan manusia secara rata-rata pada angka besar, tetapi secara sistematis lebih lunak pada kasus-kasus batas — dan bias ini tidak terlihat di balik persentase keseluruhan. Karena itu, analisis korelasi kalibrasi dan penguraian perbedaan pada setiap kelas kasus lebih berguna daripada satu metrik ringkasan: ia menunjukkan bukan "seberapa dekat kita", melainkan "ke arah mana dan pada hal apa kita keliru".
Cara memasukkan ini ke dalam pipeline nyata
Penulis tidak menyarankan untuk meninggalkan otomatisasi — mereka menyarankan skema hibrida. Hakim LLM mengambil alih penilaian massal, manusia tetap berada di tempat yang membutuhkan konteks dan keyakinan tinggi terhadap putusan. Aturan praktisnya sebagai berikut:
- jalankan rubrik setidaknya dalam dua-tiga konfigurasi dan bandingkan hasilnya, bukan hanya skor akhirnya;
- hitung kesepakatan per metrik secara terpisah, bukan satu angka untuk seluruh dataset;
- pertahankan manusia pada safety-recall dan pada metrik pemulihan setelah kegagalan;
- periksa kalibrasi pada domain Anda sendiri sebelum menetapkan ambang batas otomatis;
- simpan kasus-kasus perbedaan manusia/model — ini adalah bahan siap pakai untuk melatih ulang rubrik.
Intinya
Hakim LLM adalah alat yang berfungsi untuk penilaian agen suara berskala besar, tetapi bukan pengganti penilai manusia. Keandalannya terdistribusi secara tidak merata: sebagian metrik bisa dengan aman diserahkan ke otomatisasi, sebagian lagi memerlukan pandangan manusia. Kegunaan penelitian ini terletak pada fakta bahwa ia memberikan kerangka empiris untuk pembagian kerja semacam itu — dan mengingatkan bahwa pertanyaan "apakah model layak dipercaya untuk menilai" tidak tepat selama belum diperjelas metrik mana dan domain mana yang dimaksud.