
Backdoor datang dari pipeline, bukan dari pengguna
Model multimodal semakin erat terintegrasi ke dalam skenario aplikasi: mereka membaca tangkapan layar, menganalisis foto produk, menjawab pertanyaan berdasarkan pindaian dokumen. Bersamaan dengan kemudahan itu, kerentanan pihak lain pun ikut berpindah ke dalam produk. Model dirakit dari komponen siap pakai — encoder visual, proyeksi, bagian bahasa — dan pada setiap langkah perakitan, pemicu tersembunyi bisa masuk ke dalamnya. Kadang ia tersembunyi di dalam gambar, kadang di dalam teks, dan kadang memerlukan kombinasi kedua sinyal tersebut.
Setelah itu mulailah masalah yang tidak menyenangkan. Alat-alat yang cukup baik dalam menangani klasifikasi yang "diracuni" menjadi jauh menurun performanya pada model multimodal: terlalu banyak lapisan, modalitas yang terlalu berbeda, geometri representasi internal yang terlalu rumit. Sedangkan solusi yang dirancang khusus untuk MLLM umumnya bekerja di sisi input — menyaring permintaan yang mencurigakan sebelum mencapai jaringan. Filter dapat menghentikan serangan tertentu, tetapi infeksinya sendiri tetap berada di dalam bobot. Mengelabui filter hanyalah soal kreativitas penyerang.
Ketidakkonsistenan antar-lapisan sebagai jejak serangan
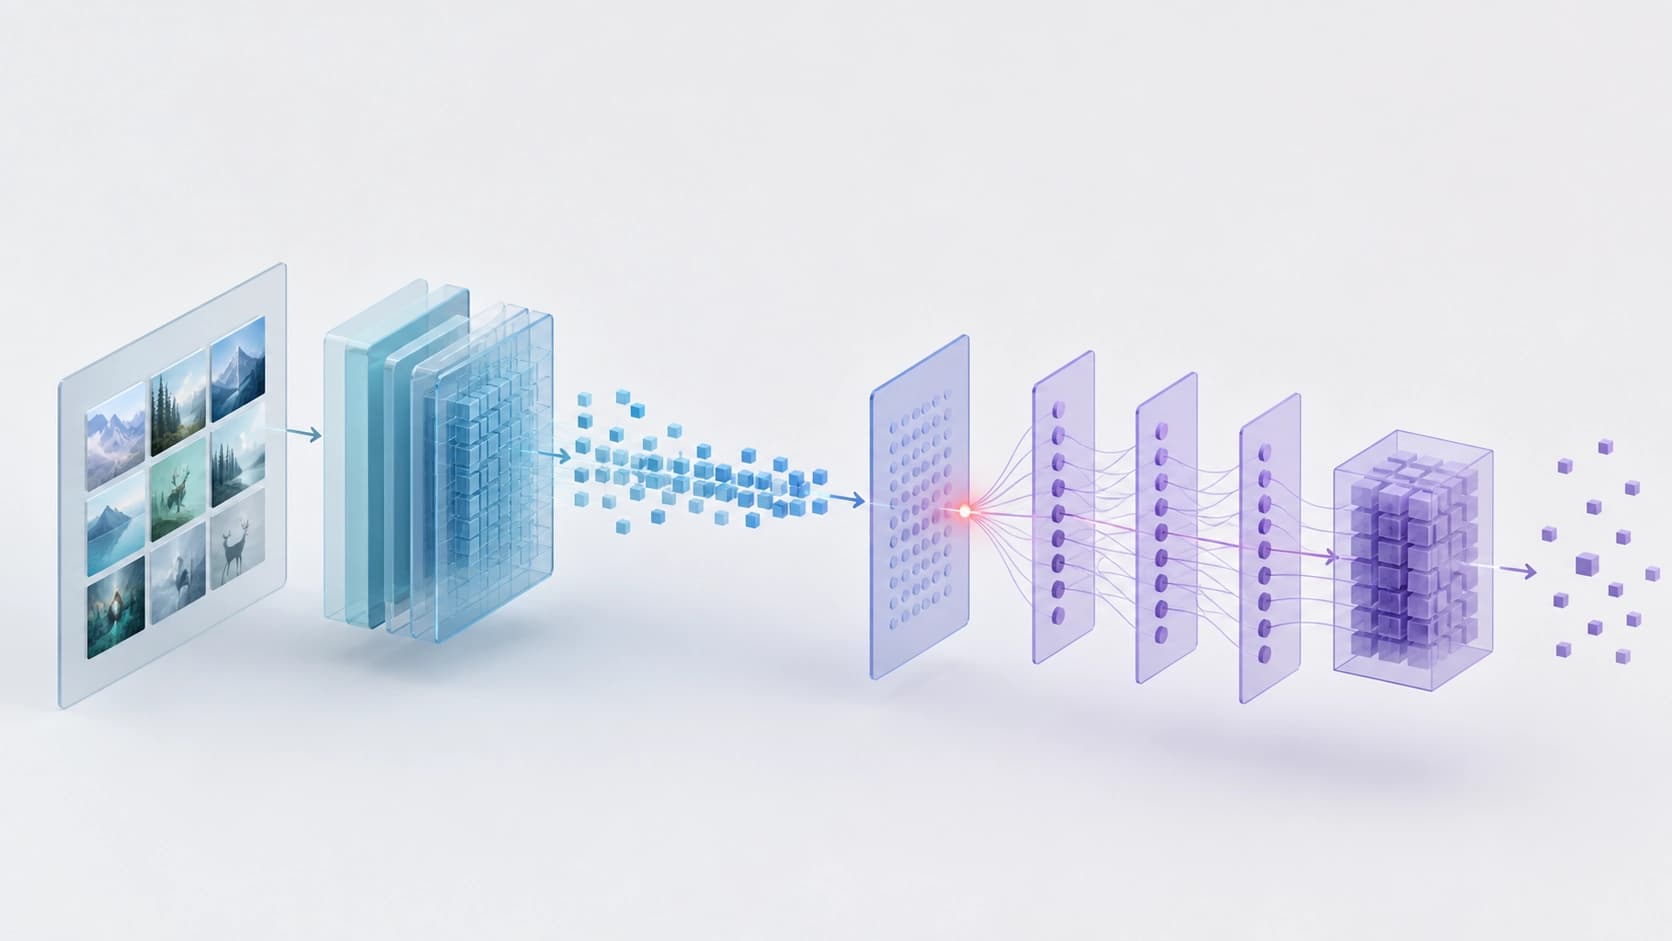
Penulis karya arXiv:2608.24354 (Jiali Wei dan delapan penulis lainnya; kategori cs.CR, cs.AI, cs.CL, diajukan Agustus 2026) memperhatikan hal yang mudah terlewat jika hanya melihat input dan output. Backdoor meninggalkan jejak bukan di satu lapisan, melainkan pada lintasannya: representasi saat melewati lapisan demi lapisan berubah secara tidak wajar. Ini disebut anomali ketidakkonsistenan antar-lapisan.
Detail kuncinya — anomali ini tidak tersebar merata di seluruh jaringan. Ia terikat pada modalitas dan, yang lebih penting, terlokalisasi di area token tempat fitur pemicu berada. Dengan kata lain, model "bersandar" pada area representasi yang sempit, dan di situlah muncul pergeseran yang tidak pernah terjadi pada data bersih.
Dari sini muncul kesimpulan praktis: jika ketidakkonsistenan dirata-ratakan di seluruh representasi, sinyalnya akan kabur oleh derau dari fitur-fitur yang berguna. Kita perlu terlebih dahulu memisahkan apa yang sudah dicampur oleh model.
Bagaimana RACER dirancang
Pemisahan berdasarkan modalitas
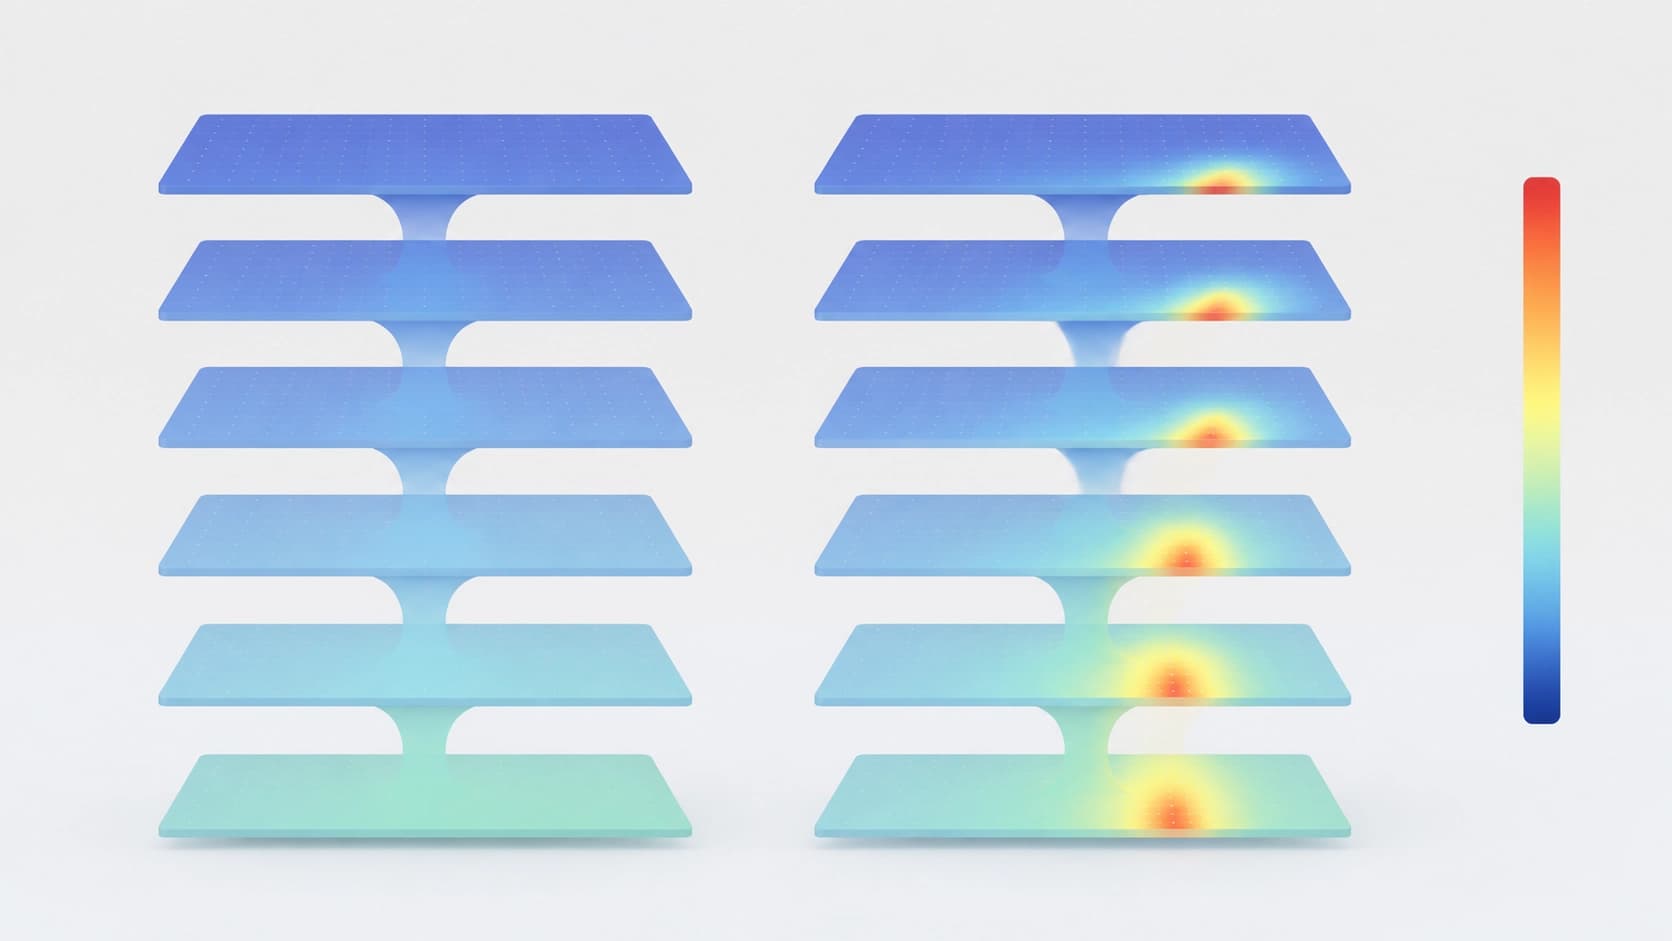
Kerangka kerja pemulihan pada tingkat model — bukan lapisan tambahan di atas inferensi — diberi nama RACER (Region-Aware Consistency Repair). Logikanya begini: representasi yang telah digabungkan diuraikan kembali menjadi area token visual dan tekstual, ketidakkonsistenan antar-lapisan dihitung untuk masing-masing secara terpisah, lalu digabungkan kembali, tetapi dengan bobot yang memperhitungkan modalitas. Pekerjaan berlangsung di jendela lapisan dalam — tempat pergeseran yang stabil dan terarah terbentuk.
Hasilnya adalah fungsi tujuan yang sadar wilayah. Ia lebih sensitif terhadap anomali lokal dibandingkan metrik umum di seluruh vektor, dan tidak membiarkan fitur-fitur berguna menenggelamkan sinyal backdoor.
Min-max alih-alih fine-tuning sederhana
Selanjutnya skema adversarial diaktifkan. Melalui optimasi min-max, kerangka kerja ini pertama-tama mencari perturbasi terburuk — yang paling memperkuat ketidakkonsistenan yang terdeteksi — lalu melakukan fine-tuning pada model agar perturbasi tersebut tidak merusaknya. Sederhananya: mereka menyerang diri sendiri untuk memperkuat arah representasi tempat perilaku berbahaya bersandar.
Sisi praktisnya sama pentingnya dengan sisi teknisnya. Metode ini hanya membutuhkan 100 contoh bersih. Ia tidak perlu mengetahui pemicunya sendiri, label target serangan, bahkan apakah model yang diberikan terinfeksi atau tidak. Ini fundamental: pertahanan tidak berubah menjadi tugas "tebak serangannya".
Apa yang ditunjukkan oleh pengukuran
Penulis menguji metode ini pada tiga model multimodal terbuka dalam 36 konfigurasi backdoor — dengan pemicu di gambar, di teks, dan di kedua kanal sekaligus. ASR rata-rata (proporsi kasus ketika serangan tetap berhasil) berhasil ditekan hingga 1,1%, dan pada 32 dari 36 konfigurasi, angkanya turun hingga nol.
Hasil kedua tidak kalah penting, meskipun lebih jarang dibicarakan: kegunaan pada tugas bersih tetap terjaga. Baik pada model yang terinfeksi maupun yang sejak awal bersih — artinya pemulihan tidak mengubah model yang berfungsi menjadi hati-hati tetapi tidak berguna. Ini adalah harga yang biasa dibayar untuk metode pembersihan yang agresif, dan di sini, berdasarkan pengukuran, harga itu berhasil dihindari.
Apa yang berubah dalam praktik
Perbedaan antara penyaringan input dan pemulihan bobot bukanlah hal akademis. Filter hidup di infrastruktur di sekitar model: ia harus dipelihara, diperbarui untuk jenis serangan baru, dan tetap bisa dikelabui melalui kanal lain. Perbaikan pada tingkat bobot menghilangkan penyebabnya, bukan gejalanya, dan tidak menambah latensi pada inferensi.
Ada juga cerita yang lebih luas. Kita terbiasa menilai keamanan model berdasarkan jawabannya pada pengujian, tetapi RACER menunjukkan bahwa sinyal informatif tersembunyi di dalam representasi perantara — dalam cara jaringan berpikir, bukan dalam apa yang dikatakannya. Jika pendekatan ini dapat diskalakan di luar tiga arsitektur yang diuji, penyedia MLLM memiliki langkah higiene yang relatif murah: seratus contoh bersih dan sedikit komputasi sebelum menerbitkan bobot. Keterbatasannya juga jelas — karya ini meneliti kelas serangan tertentu dan memerlukan akses ke bagian dalam model, sehingga untuk model API tertutup, skema ini tidak dapat diterapkan secara langsung.


