
Mengapa "non-verbal" menjadi masalah tersendiri bagi sintesis ucapan
Teks yang disuarakan belum sama dengan ucapan yang hidup. Orang menghela napas saat lelah, tertawa kecil di momen yang canggung, berdehem untuk mengisi jeda, dan tanpa sisipan-sisipan ini bahkan diksi yang sempurna terdengar seperti mesin penjawab. Karena itulah generasi vokalisasi non-verbal — NV, non-verbal vocalizations — sejak lama dianggap sebagai salah satu penanda sintesis ucapan yang "ekspresif": ia memisahkan robot yang membaca dari kertas dari suara yang ingin dipercaya.
Kesulitannya adalah menyisipkan tawa secara teknis tidak sulit, tetapi menyisipkannya pada tempatnya — itu persoalan yang berbeda tingkatannya. Ketepatan leksikal bisa dihitung per karakter dan kata, sedangkan kelayakan helaan napas atau senyum sinis dalam frasa tertentu adalah kategori yang kabur, sulit diformalkan, dan hampir tidak bisa diperiksa secara otomatis. Metrik klasik tidak berguna di sini: mereka akan menghukum model karena suara "berlebih", padahal justru suara itulah yang membuat tuturan terasa manusiawi.
Apa yang ditawarkan para penulis: preferensi alih-alih instruksi
Karya berjudul Preference Optimization for Non-Verbal Vocalization Synthesis (arXiv:2608.24163, koleksi eess.AS, diajukan 25 Agustus 2026) mendekati persoalan ini dari sisi pembelajaran berbasis preferensi. Tim penulisnya adalah Haoyang Li, Chenglin Xu, Junchuan Zhao, Yuang Cao, Liumeng Xue, Yiwen Guo, dan Eng Siong Chng.
Gagasan utamanya sederhana: alih-alih menuliskan aturan secara manual "tawa cocok di sini, tidak cocok di sana", kita bisa menunjukkan kepada model pasangan varian penyuaraan dan memberinya sinyal mana yang lebih baik. Namun, seperti dicatat para peneliti, penerapan pendekatan ini khusus untuk vokalisasi non-verbal masih jarang diteliti — belum jelas sinyal preferensi apa yang harus dikumpulkan, bagaimana membentuk pasangan, dan tujuan optimisasi apa yang harus ditetapkan.
Para penulis melakukan penelitian sistematis pada tiga sumbu sekaligus: sumber sinyal preferensi, cara membentuk pasangan, dan tujuan optimisasi berbasis DPO (Direct Preference Optimization). Pada dasarnya, ini bukan penemuan algoritma baru, melainkan peta wilayah — upaya memahami keputusan mana dalam pipeline yang benar-benar mengubah hasil, dan mana yang hampir tidak memberi dampak.
NV-CER: metrik yang menghitung kata sekaligus tawa
Temuan tersendiri dari karya ini adalah metrik NV-aware character error rate, atau NV-CER. Idenya adalah berhenti memperlakukan sisipan non-verbal sebagai derau dan memperlakukannya setara dengan kata biasa: tag NV menjadi simbol keluaran yang setara, dan CER berbobot berbasis pinyin dihitung dari konten gabungan — baik verbal maupun non-verbal.
Makna praktis metrik semacam ini terletak pada pengendaliannya. Karena bagian non-verbal kini terukur secara terpisah, ia bisa digerakkan secara terarah ke arah yang diinginkan tanpa menulis ulang algoritma optimisasinya. Ini poin penting: tim ini sengaja tidak menciptakan arsitektur baru, melainkan menunjukkan cara memeras lebih banyak dari alat yang sudah ada melalui perumusan tugas yang tepat.
Bagaimana ini diuji
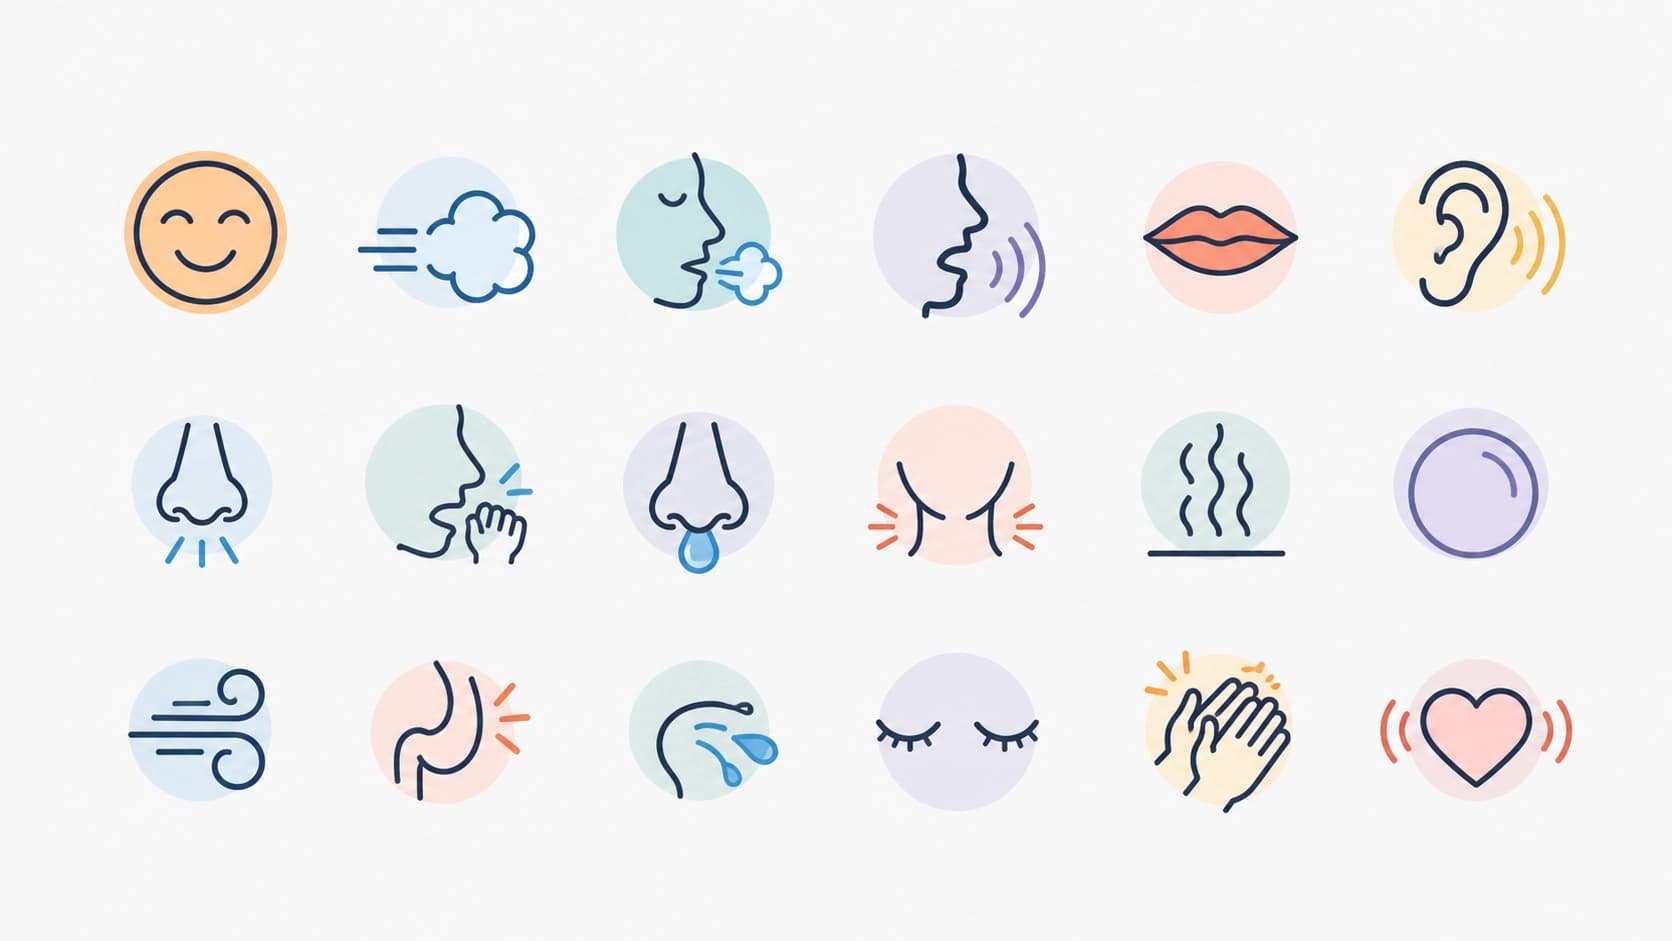
Eksperimen dilakukan pada dataset Emilia-NV, serta pada versi diperluas NV-Bench — kumpulan yang mencakup 18 jenis vokalisasi non-verbal yang berbeda. Keragaman ini penting: tawa, batuk, dan helaan napas bukanlah fenomena yang sama, dan metode yang berhasil untuk satu jenis bisa saja runtuh pada jenis lain.
Evaluasi dilakukan melalui tiga jalur sekaligus: metrik objektif, penilaian dengan model bahasa besar, dan penilaian manusia. Kesepakatan ketiga jalur bukti ini adalah argumen yang kuat, karena justru ketidaksesuaian antara metrik otomatis dan persepsi manusia yang biasanya meruntuhkan penelitian semacam ini.
Apa yang ditunjukkan hasilnya
Kesimpulan utamanya: konfigurasi itu penting, tetapi tidak sembarang konfigurasi. Berbagai varian desain memengaruhi dua hal sekaligus secara berbeda — seberapa sering dan seberapa alami model mewujudkan vokalisasi, dan seberapa akurat model mempertahankan konten leksikalnya. Ini kompromi klasik: penyetelan yang terlalu agresif ke arah ekspresivitas mulai merusak kejelasan.
Meski demikian, para peneliti berhasil menemukan konfigurasi yang efektif berbasis DPO standar — tanpa tambahan eksotis. Terdengar seperti hasil yang sederhana, tetapi dalam praktiknya lebih berharga daripada hasil yang memukau: artinya, metode ini dapat direproduksi dan tidak memerlukan sumber daya langka.
Implikasinya bagi praktik
Karya ini dirumuskan sebagai seperangkat rekomendasi praktis untuk pasca-pelatihan yang sadar-NV bagi sintesis yang ekspresif. Beberapa kesimpulan yang secara logis mengikutinya:
- Metrik menentukan perilaku. Selama sisipan non-verbal belum dipisahkan menjadi entitas terukur tersendiri, tidak ada cara sistematis bagi model untuk diperbaiki ke arah ini.
- Sinyal lebih penting daripada algoritma. Variabilitas utamanya terletak pada dari mana preferensi berasal dan bagaimana pasangan dibentuk, bukan pada pilihan optimizer.
- Jenis NV yang berbeda adalah tugas yang berbeda. Tawa dan helaan napas mengikuti aturan yang tidak serupa, dan penilaian berdasarkan angka rata-rata kemungkinan besar menyembunyikan sesuatu.
- Pemeriksaan tiga lapis itu wajib. Kesepakatan penilaian objektif, LLM, dan manusia adalah syarat minimum kepercayaan pada hasil.
Jika dilihat lebih luas, kisah ini adalah tentang pergeseran cara pandang dalam sintesis ucapan. Dulu kualitas berarti "kata-kata yang diucapkan dengan benar". Kini semakin sering yang dibicarakan adalah apakah sistem mampu berperilaku seperti manusia: diam pada momen yang tepat, tersenyum sinis di tempat di mana lawan bicara akan melakukannya. Dan untuk perilaku semacam itu, seperti ditunjukkan penelitian ini, yang jauh lebih berguna bukanlah algoritma baru, melainkan metrik yang jujur dan sinyal preferensi yang dikumpulkan dengan benar.


