
Mengapa "tunjukkan di mana itu" adalah pertanyaan yang salah
Tes klasik untuk orientasi visual terlihat hampir seperti soal sekolah: diberikan sebuah gambar dan frasa seperti "folder biru di rak paling bawah", dan model harus menunjukkan di mana objek yang dimaksud berada. Satu permintaan, satu jawaban, metriknya — tepat atau tidak.
Skema ini praktis, tetapi yang digambarkannya bukanlah percakapan, melainkan perintah. Dalam komunikasi nyata, seseorang jarang memberikan deskripsi yang lengkap pada percobaan pertama. Ia berkata "nah, benda itu yang di dekat jendela" dan berharap lawan bicaranya entah menebak, entah bertanya lagi. Saling pengertian dibangun sepanjang dialog — kadang dalam dua giliran, kadang dalam lima.
Penulis makalah arXiv:2608.23978 (Zhengxiang Wang dan Owen Rambow, artikel diterima di EMNLP 2026) mengusulkan agar justru tahap yang terlewat inilah yang dijadikan objek pengukuran. Pertanyaan mereka berbunyi demikian: apakah model mampu tidak hanya melihat, tetapi juga bertanya, ketika gambar dan kata-kata tidak cukup untuk menghasilkan kesimpulan yang tidak ambigu.
Bagaimana eksperimennya dirancang
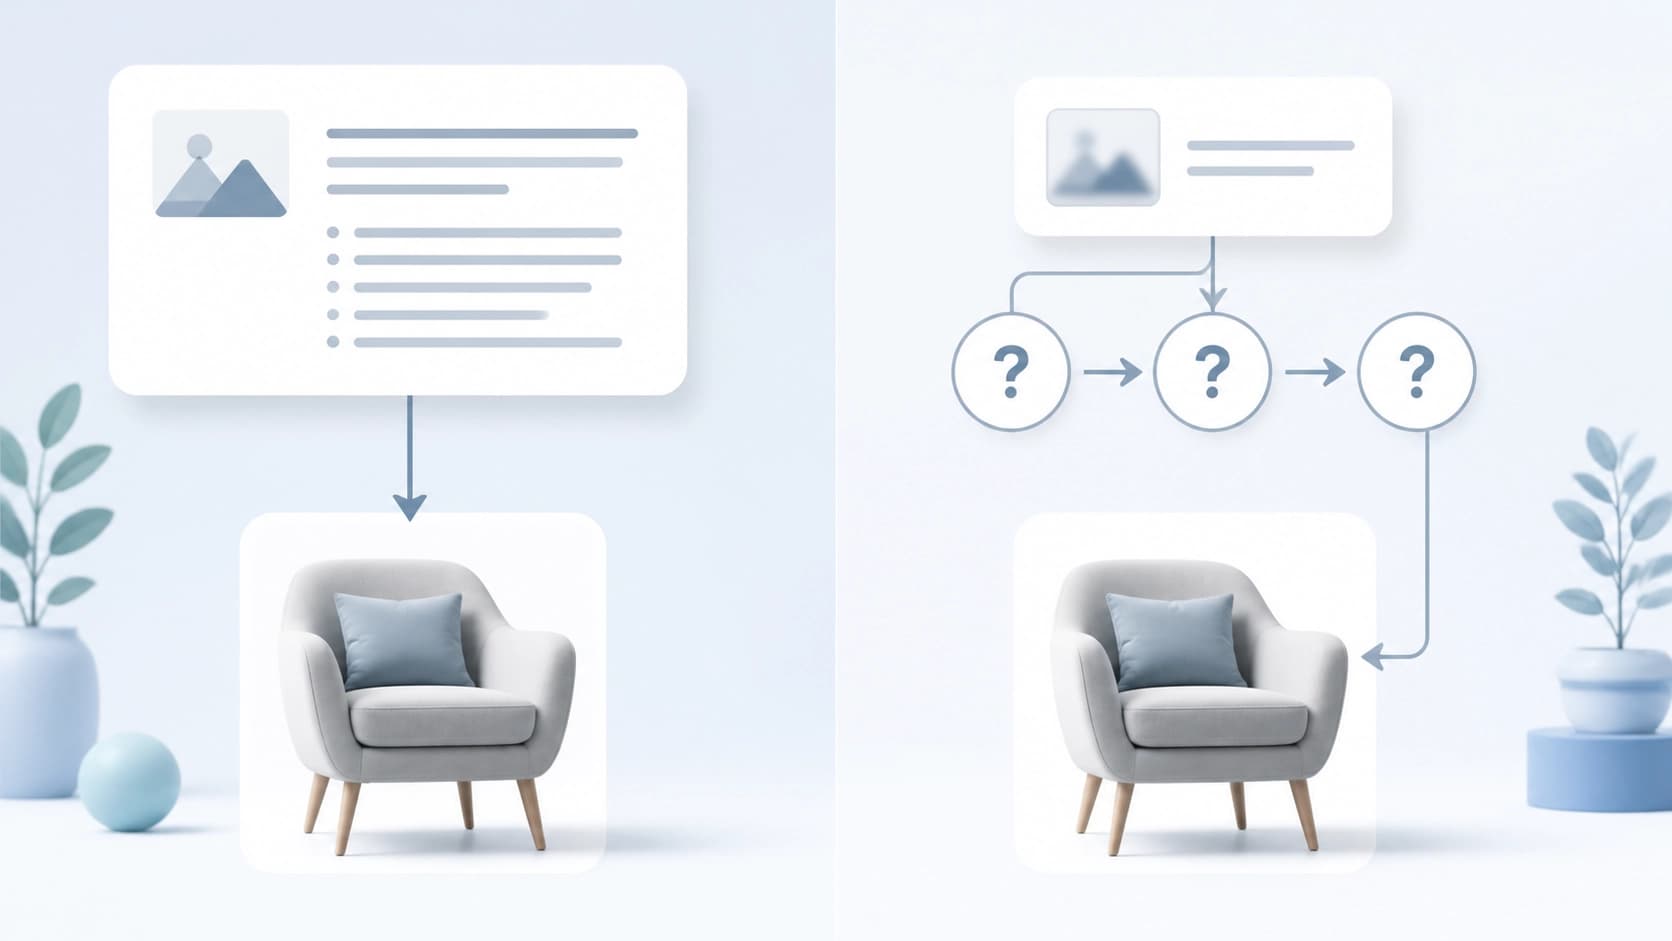
Defisit informasi yang terkendali
Ide utamanya — bukan mengukur akurasi "secara rata-rata", melainkan mengatur secara bertahap berapa banyak informasi tentang target yang diberikan di awal, dan berapa banyak yang harus diperoleh model sendiri. Di salah satu ujung skala, tugasnya hampir tidak berbeda dari tes satu langkah biasa: deskripsinya terperinci, targetnya jelas. Di ujung lain, rumusan awalnya tidak ada sama sekali, dan segala yang diketahui model tentang objek yang dicari harus ia tarik dari pertanyaan-pertanyaan penjelasnya sendiri.
Konstruksi semacam ini memungkinkan pemisahan keterampilan mengenali dari keterampilan menjalankan dialog. Model yang dengan sempurna menemukan objek berdasarkan petunjuk yang tepat bisa gagal total ketika petunjuk itu harus dirakit dari potongan-potongan kecil.
Empat konteks dan empat protokol
Lingkungan eksperimen bertumpu pada empat konteks visual yang mendekati skenario manusia, dan empat protokol interaksi yang berbeda. Ini penting: hasilnya tidak dapat direduksi menjadi satu konfigurasi yang berhasil atau gagal. Sekaligus diuji pula siapa yang merumuskan deskripsi — manusia atau model lain, serta bagaimana pengaruh volume penalaran, percobaan ulang, dan pergantian penyedia deskripsi. Pola-pola yang dibahas di bawah ini tereproduksi pada semua varian tersebut.
Di mana tepatnya terjadi kerusakan
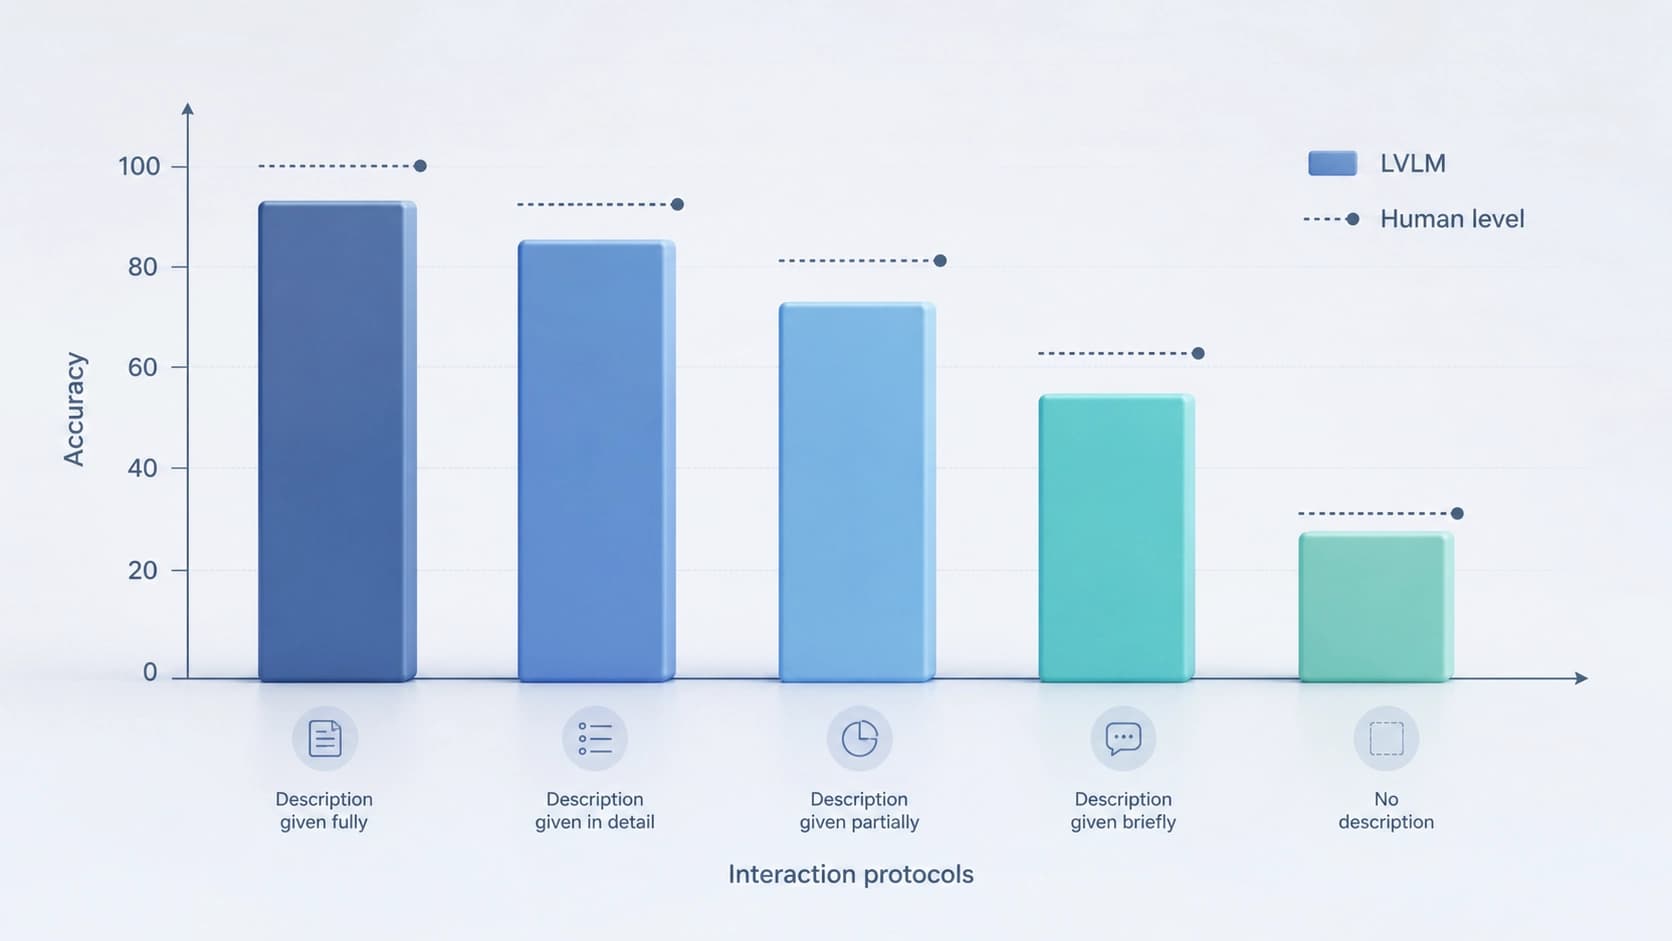
Kesenjangan dengan manusia bertahan di semua protokol
Kesimpulan utamanya tidak menggembirakan: pada tidak satu pun mode, model bahasa-visual besar saat ini mendekati tolok ukur manusia. Kesenjangan itu tetap ada baik ketika tugasnya tampak hampir sepele, maupun ketika tugasnya menuntut dialog yang sesungguhnya. Yang dimaksud bukan beberapa poin persentase, melainkan perbedaan kualitatif dalam keandalan.
Paling buruk — ketika deskripsinya tidak ada sama sekali
Hasil terendah tercatat pada skenario di mana rumusan awal target tidak ada. Model harus menyusun sendiri hipotesis tentang apa yang dicari, mengajukan pertanyaan, dan berdasarkan jawabannya mempersempit wilayah pencarian. Ini bukan lagi soal pengenalan, melainkan perilaku proaktif: harus memutuskan sendiri bahwa informasinya kurang, dan merumuskan permintaan yang akan menutup kekurangan itu.
Di sinilah tampak kegagalan yang diangkat ke judul makalah: model bisa melihat, tetapi tidak bisa bertanya. Ia entah bertaruh pada tebakan, entah mengajukan pertanyaan yang tidak menjelaskan apa pun.
Klarifikasi berhasil, tetapi tidak selalu
Interaksi itu tidak sia-sia. Ketika pertanyaan penjelas mengoreksi atau melengkapi deskripsi awal, akurasinya naik cukup nyata. Artinya, mekanisme dialog pada model itu ada dan membawa manfaat — tetapi hanya dalam peran penyunting rumusan orang lain. Begitu rumusan itu harus dibuat dari nol, keunggulannya hilang.
Keyakinan mendahului akurasi
Lini analisis tersendiri adalah kalibrasi. Model secara sistematis menyatakan keyakinan yang lebih tinggi daripada yang dibuktikan oleh akurasi faktualnya. Secara praktis ini berarti bahwa dari jawaban model tidak dapat dinilai apakah ia layak dipercaya: pilihan yang benar maupun yang salah sama-sama disertai nada yang sama-sama bersemangat.
Bagi aplikasi, ini lebih berbahaya daripada sekadar kesalahan. Jika sistem melakukan kesalahan tetapi dengan jujur memberi sinyal tentang ketidakpastiannya, ia bisa ditanya ulang atau dipanggilkan manusia. Jika ia melakukan kesalahan dengan tampang yakin — pengaman semacam itu tidak bisa dipasang.
Mengapa tugasnya lebih sulit daripada yang tampak
Orientasi visual interaktif menuntut kerja simultan dari tiga mekanisme:
- pencocokan visual — menghubungkan kata dengan objek pada gambar, termasuk hubungan spasial dan sifat-sifatnya;
- pencarian informasi — memahami informasi apa yang kurang, dan memperolehnya melalui pertanyaan, bukan melalui penelusuran menyeluruh;
- sintesis — merakit jawaban-jawaban yang terpisah menjadi satu hipotesis tunggal dan tidak kehilangannya di tengah jalan.
Setiap keterampilan secara terpisah, pada model-model modern, sampai batas tertentu sudah ada. Yang rusak adalah sambungan di antara ketiganya: yang terlihat tidak berubah menjadi pertanyaan, dan jawaban atas pertanyaan tidak menyusun ulang gambaran dunia.
Apa artinya ini dalam praktik
Jika Anda membangun produk di atas model multimodal — misalnya, GPT-4o atau API lain dengan dukungan gambar — kesimpulan makalah ini mudah diterjemahkan menjadi solusi rekayasa:
- Jangan mengandalkan deskripsi pertama. Jika pengguna merumuskan permintaan secara kabur, rancanglah siklus klarifikasi, bukan satu permintaan-jawaban tunggal.
- Jangan memercayai keyakinan yang dinyatakan. Kalibrasi sebaiknya dibangun di atas anotasi Anda sendiri untuk tugas spesifik, bukan atas penilaian diri model.
- Rancanglah pertanyaan untuk model. Jika sistem tidak mampu memahami sendiri apa yang kurang darinya, peran penanya harus diambil alih oleh lapisan logika eksternal.
- Ujilah pada defisit informasi Anda sendiri. Berguna untuk memeriksa bagaimana pipeline berperilaku tepat pada mode-mode di mana, menurut data para penulis, akurasinya jebol.
Kesimpulan
Makalah ini mencatat bukan ketiadaan kemampuan, melainkan ketidaksesuaian keterampilan. Model melihat cukup untuk menjawab pertanyaan yang diajukan dengan baik, tetapi tidak cukup memahami situasinya untuk mengajukannya sendiri. Selama kesenjangan ini belum tertutup, orientasi visual interaktif akan tetap menjadi tugas di mana manusia terus menjadi mata rantai dialog yang paling andal.


