
Granite.Trust: seperangkat alat yang mengubah persyaratan keamanan GenAI menjadi kebijakan yang berfungsi
Tim peneliti dari IBM memperkenalkan alat Granite.Trust: skema YAML untuk mendeskripsikan konten yang diizinkan dan dilarang dalam respons model generatif, generator data pelatihan yang konsisten, dan toolkit pendamping. Pendekatan ini memungkinkan penetapan aturan satu kali dan penerapannya di seluruh siklus hidup aplikasi — dari penyelarasan model hingga kontrol pada tahap operasional.
Mengapa kebijakan yang sama tidak bisa berlaku untuk semua
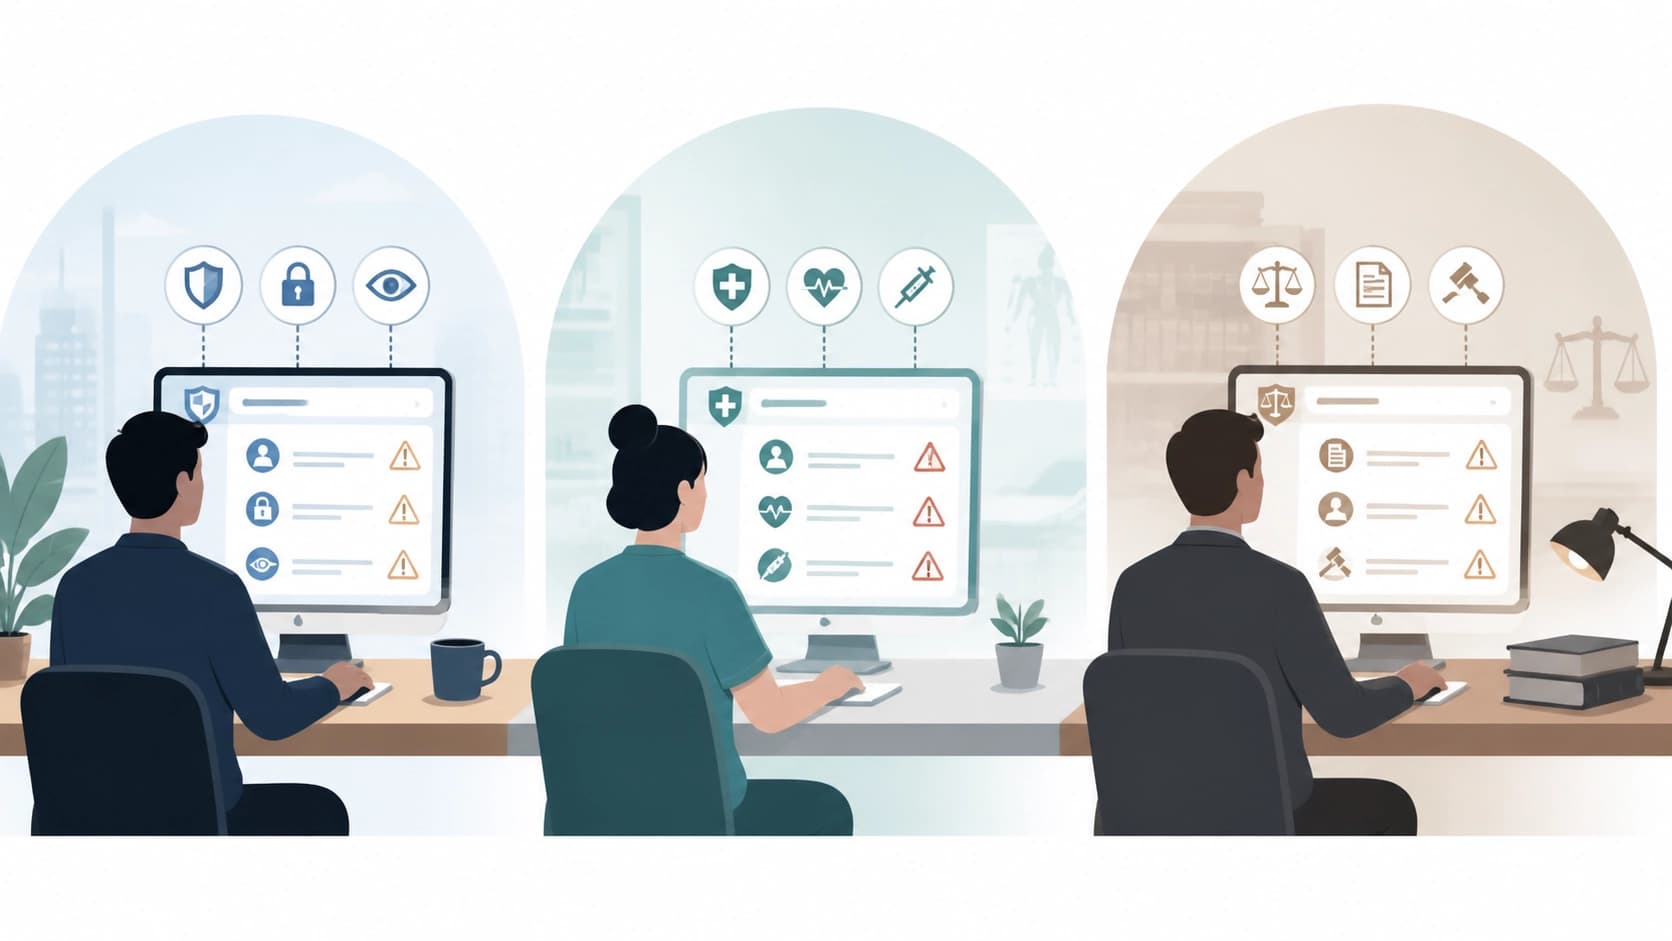
AI generatif masuk ke organisasi yang sangat beragam, dan risikonya berbeda-beda di setiap tempat. Bank khawatir tentang kebocoran data nasabah dan nasihat keuangan yang keliru, klinik khawatir tentang rekomendasi medis yang tidak akurat, sekolah khawatir tentang konten yang tidak pantas dalam dialog dengan remaja. Tambahkan pula persyaratan regulasi industri, nilai-nilai internal perusahaan, dan siapa sebenarnya yang berada di sisi lain obrolan: karyawan biasa, kontraktor, atau pengguna eksternal.
Dari sini muncul kesimpulan yang tidak nyaman: templat keamanan tunggal untuk GenAI tidak berfungsi. Pengaturannya harus disesuaikan dengan skenario tertentu, bukan disalin dari buku panduan.
Masalah kedua bersifat instrumental. Mekanisme spesifikasi kebijakan yang biasa tumbuh di sekitar manajemen akses: mereka menjawab pertanyaan "siapa yang memiliki akses ke sumber daya mana". Namun dalam aplikasi dengan model generatif, pertanyaan yang jauh lebih penting adalah apa yang sebenarnya bisa muncul dalam respons. Batasan yang terkait dengan konten sulit dijelaskan dalam istilah peran dan hak, dan pada persimpangan inilah biasanya dimulai pekerjaan manual yang tidak dapat diskalakan.
Apa yang ditawarkan Granite.Trust
Kumpulan alat ini dijelaskan dalam pracetak arXiv:2608.23870 di bagian cs.AI. Materi diajukan pada 24 Agustus 2026, di antara penulisnya adalah Nathalie Baracaldo, Nicolas Mello, Kush R. Varshney, Heiko Ludwig, Kate Soule, dan David Cox, totalnya enam orang. Ukuran sumbernya sekitar 2,7 MB, yang untuk artikel dengan perangkat menunjukkan basis kode yang cukup nyata, bukan sekadar konsep.
Penulis mengklaim dua hal utama.
Actionable Policy: kebijakan sebagai dokumen yang dapat diedit
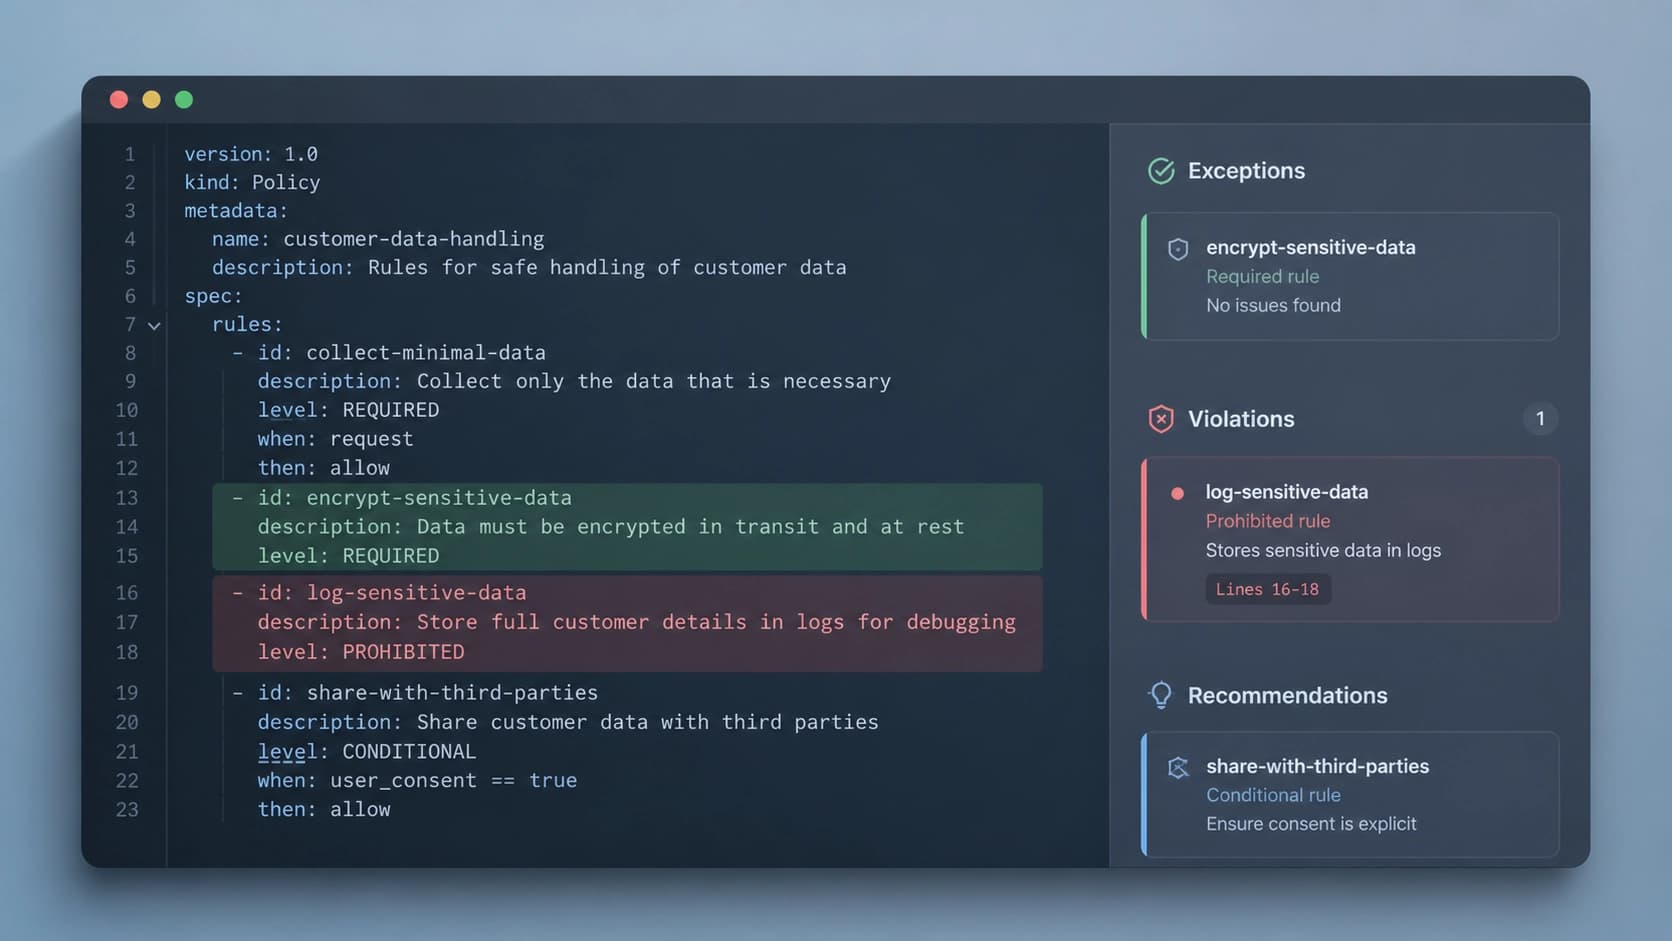
Yang pertama adalah skema Actionable Policy, format berbasis YAML. Ini bukan "panduan keamanan" abstrak, melainkan deskripsi yang dapat dibaca mesin tentang respons model mana yang diperbolehkan dan mana yang tidak. Detail kuncinya adalah manajemen berbasis pengecualian: aturan memiliki pengecualian eksplisit, dan justru inilah yang memungkinkan pelacakan kasus pelanggaran kebijakan. Sederhananya, tim tidak hanya mendapatkan daftar larangan, tetapi juga mekanisme untuk memahami di mana tepatnya model melampaui batas dan mengapa.
Data sintetis untuk pengujian kebijakan
Yang kedua adalah pipeline pembuatan data sintetis. Ini menciptakan contoh pelatihan yang selaras dengan kebijakan yang telah dijelaskan, dan diperlukan untuk dua tujuan: penyelarasan model dan pengujiannya. Selain itu ada seperangkat utilitas yang membantu merancang skema itu sendiri dan kemudian memantau kepatuhan terhadap aturan.
Logikanya masuk akal: jika kebijakan ada secara terpisah dari data yang digunakan untuk melatih model, ia tetap menjadi deklarasi. Namun ketika dari kebijakan secara otomatis tumbuh contoh "ini boleh" dan "ini tidak boleh", persyaratan berubah menjadi sesuatu yang dapat diverifikasi.
Sekali ditetapkan — diterapkan di seluruh siklus
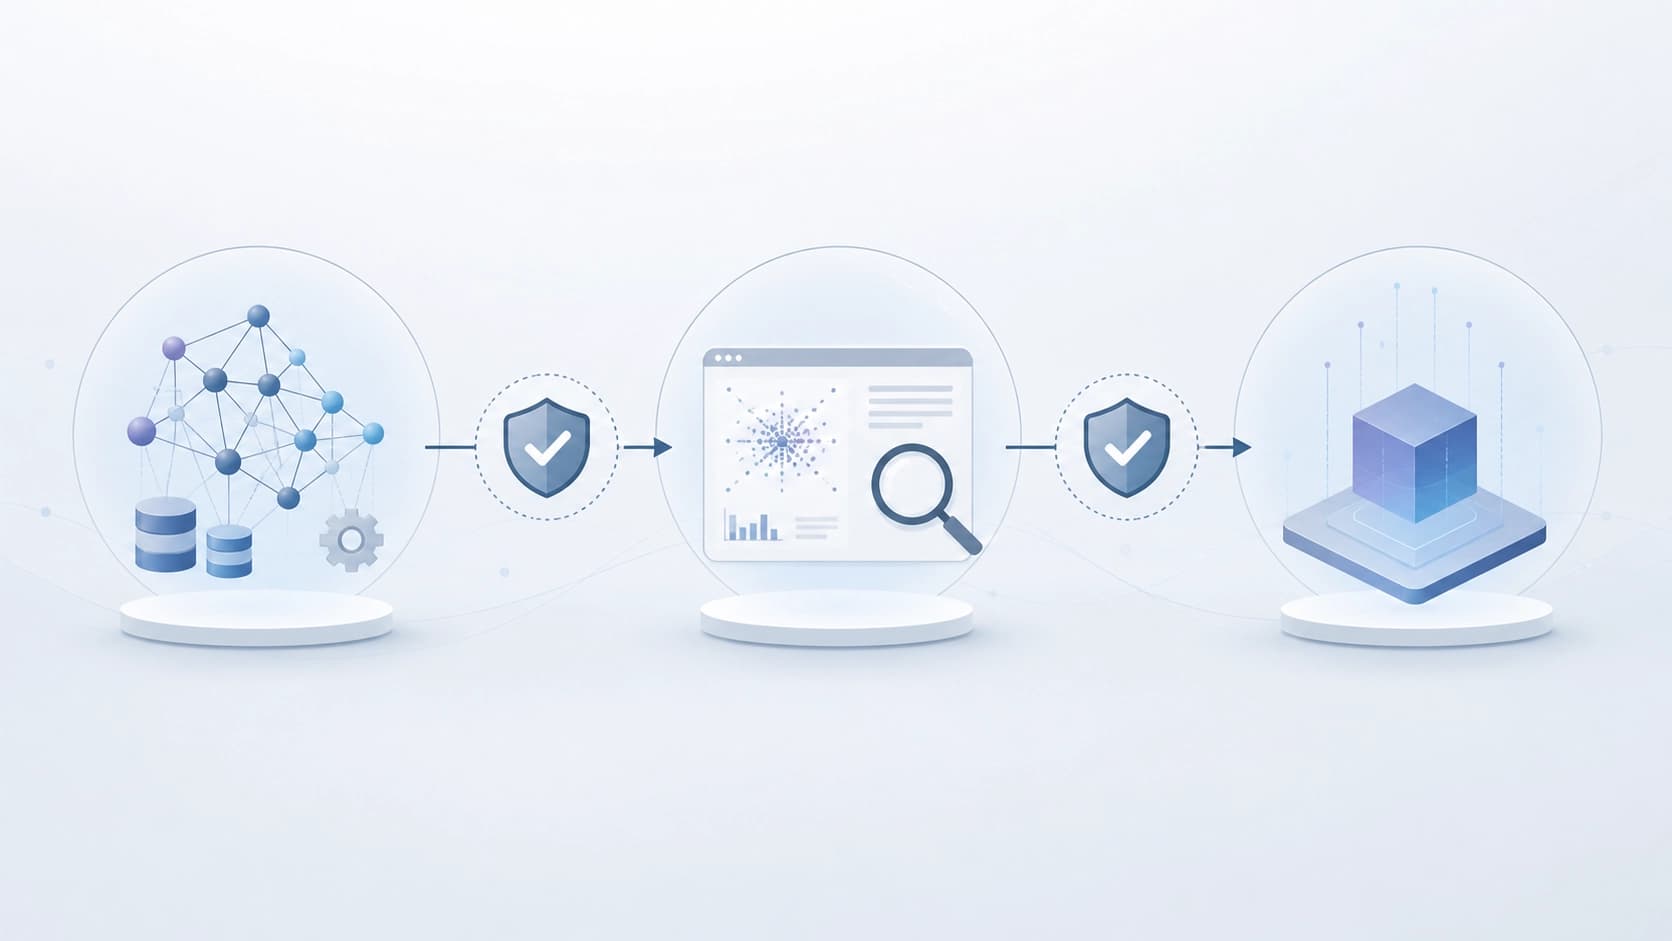
Nilai praktis utama dari keterkaitan ini adalah kebijakan tidak lagi menjadi dokumen sekali pakai. Organisasi merumuskannya sekali dan kemudian membawanya melalui seluruh siklus hidup aplikasi: dari tahap penyelarasan model hingga pemantauan produk yang sudah berjalan.
Ini secara signifikan mengubah rutinitas harian tim. Biasanya persyaratan keamanan berada di satu tempat, pengujian di tempat kedua, dan log produksi di tempat ketiga, dan semuanya harus disinkronkan secara manual. Di sini diasumsikan ada satu sumber aturan, yang menjadi dasar bagi pelatihan, pemeriksaan sebelum rilis, dan pemantauan lalu lintas langsung.
Perlu dicatat: kumpulan alat ini tidak memutuskan untuk organisasi risiko mana yang kritis bagi mereka. Ia menyediakan bahasa untuk mendeskripsikan kebijakan dan infrastruktur untuk menjalankannya — tetapi isi aturannya sendiri tetap menjadi tugas orang-orang yang memahami produk, industri, dan audiens mereka.
Sumber terbuka dan ke mana harus melihat selanjutnya
Skema, contoh kebijakan, dan alatnya sendiri tersedia secara terbuka. Penulis secara langsung mengundang untuk mengirimkan ide, perbaikan, dan umpan balik — taruhan yang khas untuk proyek semacam ini, bahwa komunitas akan lebih cepat menemukan skenario yang belum dijangkau oleh kelompok peneliti.
Teks lengkapnya tersedia dalam beberapa format: PDF, versi HTML eksperimental, dan sumber dalam TeX. Artikel ini memiliki DOI — 10.48550/arXiv.2608.23870, sehingga dapat dirujuk dalam dokumen perusahaan tanpa perlu disertai catatan tentang pracetak tanpa pengenal.
Jika Anda sedang mencoba mengubah persyaratan internal untuk GenAI dari format "presentasi untuk dewan direksi" menjadi format yang benar-benar melakukan sesuatu di pipeline, — ini justru kelas solusi yang layak dilihat secara langsung. Mulailah dari contoh kebijakan: contoh-contoh itu cukup baik menunjukkan seberapa rinci penulis membayangkan batasan nyata, bukan hanya rumusan masalah akademis.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
OpenCollab: koordinasi agen yang dapat diprogram, lingkungan eksekusi terkontrol, dan metrik kepatuhan terhadap kebijakan
Framework ini menyatukan penetapan struktur interaksi agen, lingkungan eksperimen bersama, dan pelacakan peristiwa yang terperinci, sementara metrik Adherence yang diperkenalkan menunjukkan sejauh mana pelaksanaan aktual sesuai dengan skema yang dinyatakan. Dalam benchmark, konfigurasi Duo mencapai tingkat SOTA baru, sedangkan varian agen tunggal memiliki konsumsi token terendah.
11 November 2026
Toollery: memilih alat untuk agen LLM dari puluhan ribu opsi tanpa fine-tuning
Toollery membangun indeks pencarian berdasarkan deskripsi keterampilan dan alat, lalu saat ada permintaan hanya meneruskan sekumpulan kandidat terbatas ke model. Dalam eksperimen pada pustaka berskala hingga puluhan ribu fungsi, pendekatan ini mampu mempertahankan kualitas pemilihan dengan top-K tetap, meskipun dampak akhirnya bergantung pada profil beban dan caching di penyedia.
11 November 2026
Diagnostik bertahap agen GUI dalam analisis dasbor: benchmark DashAct
DashAct diperkenalkan sebagai tolok ukur yang terdiri atas 348 trajektori yang diverifikasi manusia, yang menguraikan kerja agen GUI dengan panel interaktif menjadi tiga tahap dan empat kondisi visual. Hasilnya menunjukkan masalah yang terus berulang dalam memprediksi tindakan dan mengaitkannya dengan target visual, serta ketergantungan respons agen pada dukungan kontekstual dan spasial.
11 November 2026