
Sistem AI multiagen komposit dengan siklus evidensi untuk perencanaan proton pada tumor kepala dan leher
Karya ini menguraikan integrasi kebijakan PPO terlatih yang menghasilkan beberapa opsi rencana dengan agen LLM yang melakukan klarifikasi melalui dialog, disertai pemeriksaan metrik klinis dan batasan; berdasarkan data dari 21 pasien, Qwen3-14B yang telah disesuaikan lebih baik dalam mengikuti instruksi dan membantu menggeser kompromi agar lebih mengutamakan tujuan prioritas. Kesimpulan praktisnya: perencanaan DRL otomatis dapat dilengkapi dengan dialog terarah, sambil tetap mempertahankan kendali atas batasan-batasan yang saling bersaing.
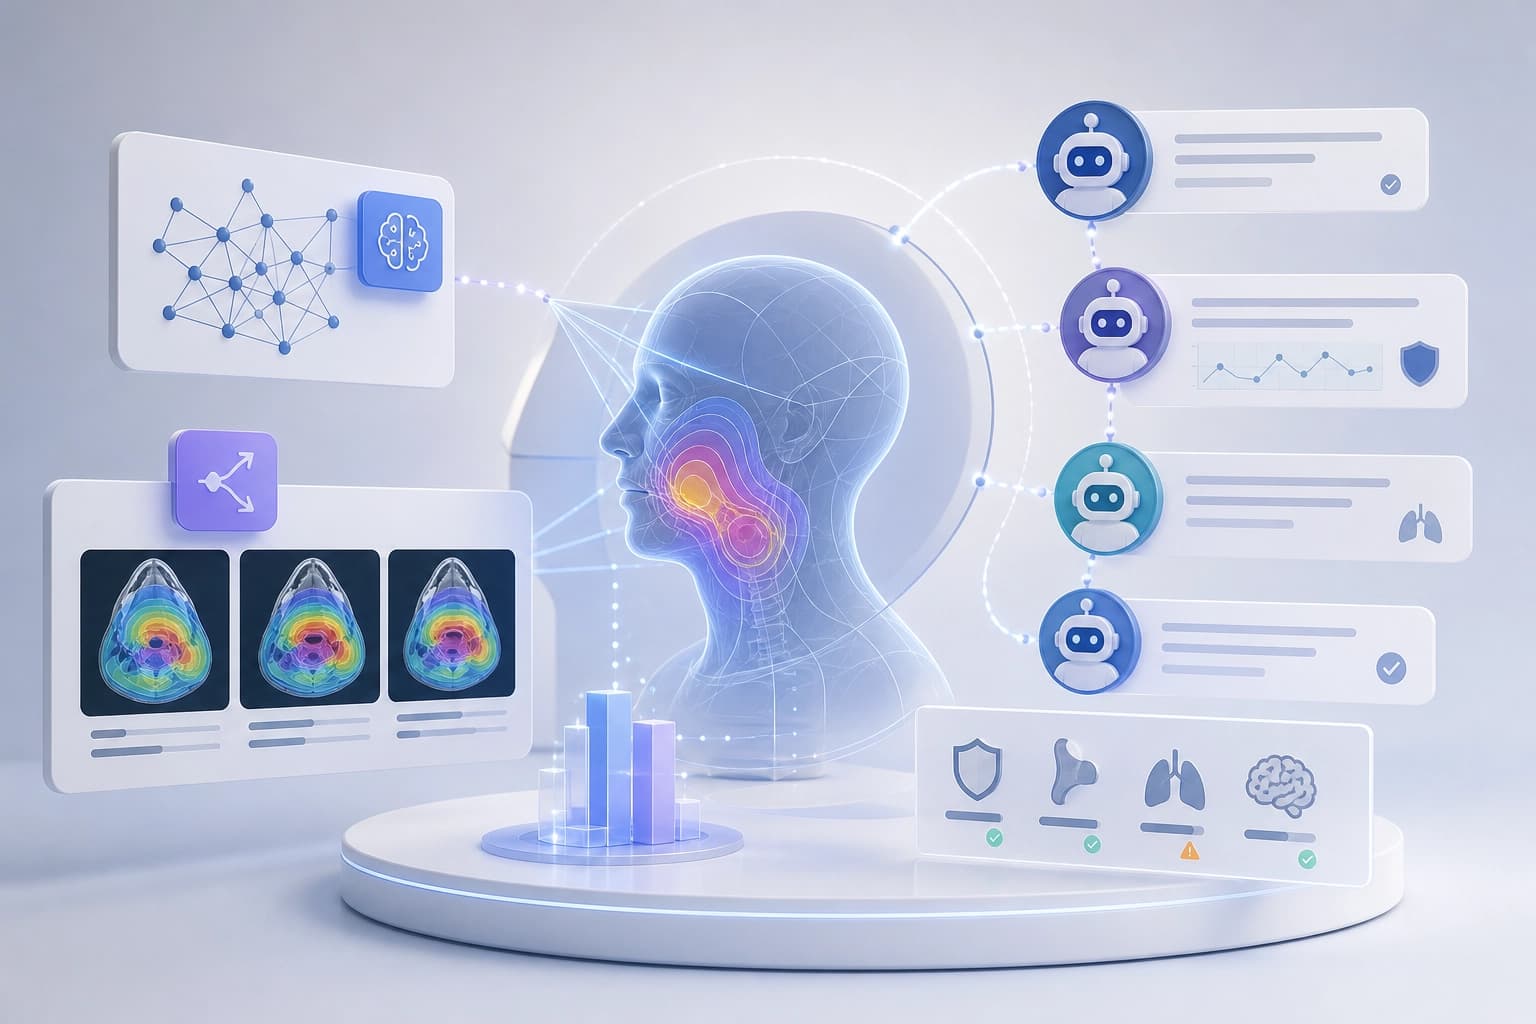
Arsitektur komposit: generasi dan penyempurnaan
Qingqing Wang, Liqiang Xiao, dan Chang Chang menerbitkan artikel di arXiv pada 21 Okt 2026 (arXiv:2610.29010). Di dalamnya, mereka menjelaskan sistem untuk terapi proton PBS pada kanker kepala dan leher. Sistem ini menggabungkan perencanaan otomatis berbasis DRL dan penyempurnaan rencana melalui dialog dengan bantuan LLM.
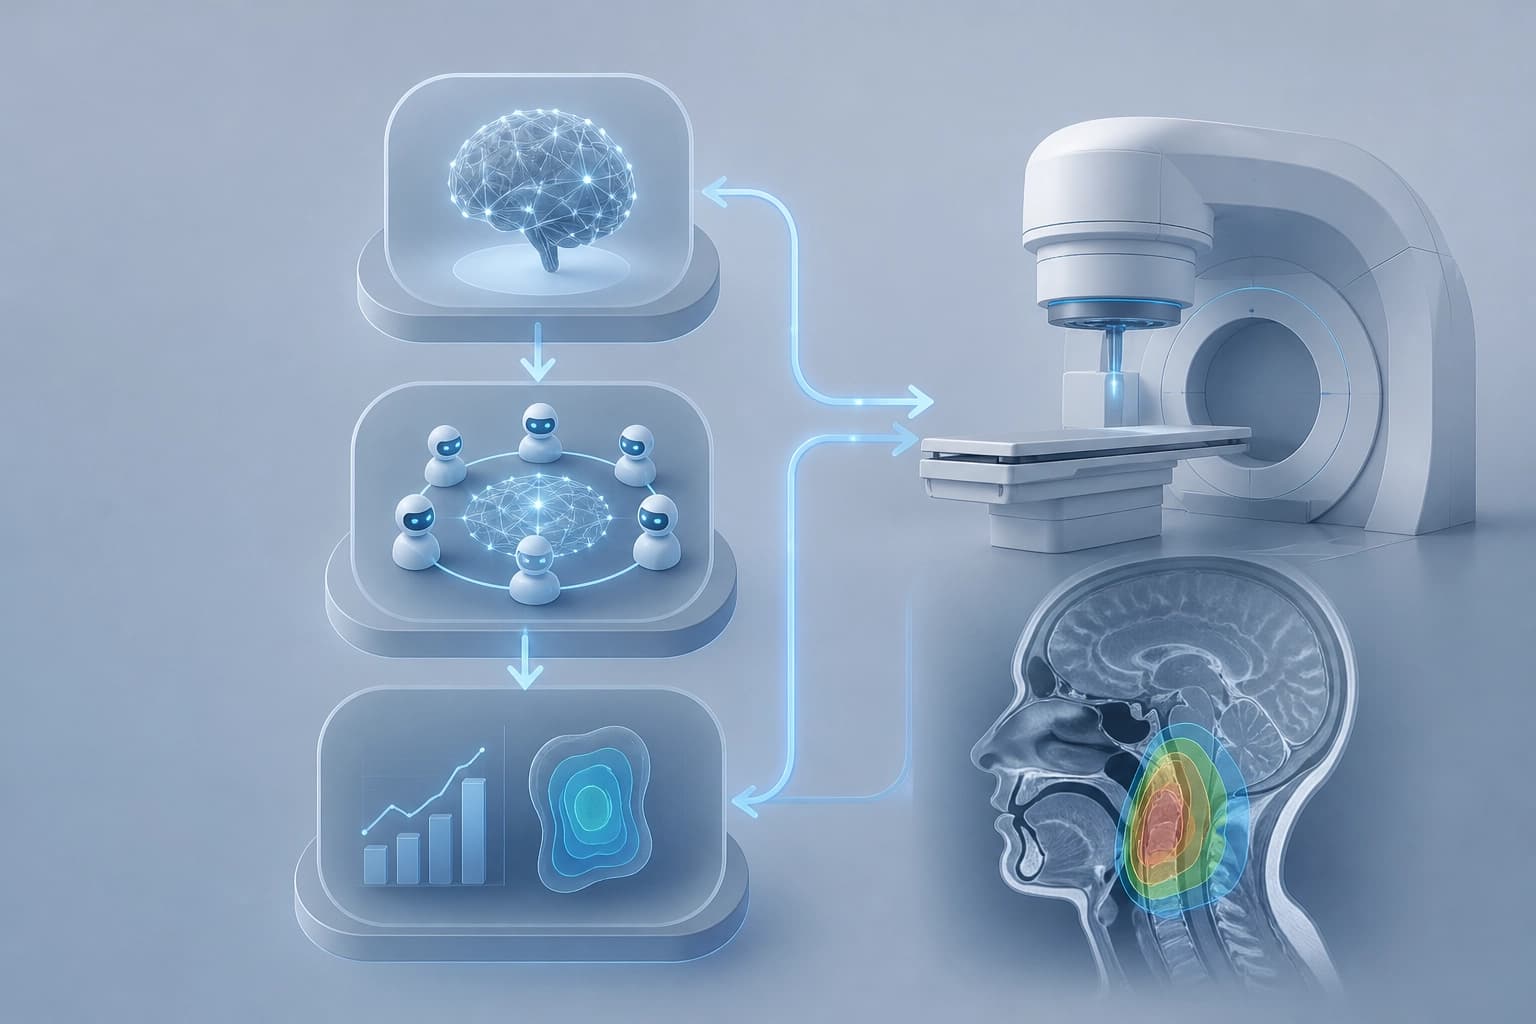
Tahap otomatis berbasis DRL menghasilkan sekumpulan rencana. Sistem memilih satu rencana sebagai target dan menggunakan rencana lainnya sebagai referensi untuk penyempurnaan. Untuk kasus yang kompleks, sistem menyediakan arsitektur LLM multiagen yang menyempurnakan rencana melalui dialog dalam bahasa alami. Kesimpulannya: skema ini memisahkan generasi otomatis dan penyempurnaan melalui dialog yang didukung data.
Generasi rencana otomatis dengan PPO
Tahap otomatis mengandalkan PPO policy network. Para penulis melatih jaringan tanpa keterlibatan manusia; jaringan tersebut terlebih dahulu menghasilkan beberapa rencana. Pelatihan dan evaluasi dilakukan menggunakan data dari 21 pasien kanker kepala dan leher. Untuk setiap pasien, para penulis menghasilkan 5 rencana PPO.
Kumpulan beberapa rencana menyediakan bahan untuk memilih rencana target dan menjadi basis referensi untuk penyempurnaan. Kriterianya: generasi otomatis harus menghasilkan sekumpulan rencana, bukan hanya satu. Dengan begitu, proses penyempurnaan memiliki landasan.
Proses penyempurnaan multiagen
Untuk kasus yang kompleks, sistem menggunakan arsitektur LLM multiagen. Sistem menyempurnakan rencana melalui interaksi dalam bahasa alami. Proses ini mencakup planning agent, chatbot, dan evaluation agent.
Planning agent mengusulkan penyesuaian dengan dukungan data. Chatbot berfungsi sebagai antarmuka tunggal untuk dialog. Evaluation agent membentuk proses yang berbasis bukti: mengambil metrik klinis dan mengidentifikasi pelanggaran batasan.
Proses ini membuat penyempurnaan dapat diverifikasi melalui metrik klinis dan batasan. Kriterianya: penyempurnaan harus didasarkan pada indikator klinis yang terukur, bukan hanya teks dialog.
Pelatihan planning agent
Planning agent menggunakan Qwen3-14B. Agent ini mendasarkan rekomendasinya pada data dari rencana yang telah dibuat sebelumnya. Untuk pelatihan tambahan pada tugas-tugas tersebut, para penulis menerapkan SFT dan GRPO.
Dibandingkan dengan LLM dasar, Qwen3-14B yang telah dilatih lebih lanjut menunjukkan kemampuan yang meningkat. Model ini lebih baik dalam mengikuti instruksi, mengekstrak informasi, dan melakukan penalaran di bidang terkait.
| Kriteria | LLM dasar | Qwen3-14B yang telah dilatih lebih lanjut |
|---|---|---|
| Mengikuti instruksi | Kemampuan dasar | Kemampuan meningkat |
| Ekstraksi informasi | Kemampuan dasar | Kemampuan meningkat |
| Penalaran di bidang terkait | Kemampuan dasar | Kemampuan meningkat |
Kriteria praktis: bagi planning agent, yang penting bukan hanya generasi, tetapi juga kemampuan mengikuti instruksi, mengekstrak data, dan melakukan penalaran di bidang terkait. Pelatihan lebih lanjut dengan SFT dan GRPO memperkuat kualitas-kualitas ini.
Evaluasi dan kompromi klinis
Para penulis memilih 50 rencana untuk disempurnakan berdasarkan instruksi. Penyesuaian lebih efektif dalam meningkatkan sasaran yang diprioritaskan pengguna. Sementara itu, penurunan pada sasaran yang bersaing tetap terbatas. Para penulis melaporkan bahwa penyesuaian memungkinkan tercapainya kompromi yang lebih sesuai secara klinis saat menyempurnakan rencana dengan mempertimbangkan pasien tertentu.
Kriteria praktis: evaluasi penyempurnaan berdasarkan peningkatan sasaran yang diprioritaskan dan terbatasnya penurunan pada sasaran yang bersaing.
Pertanyaan yang sering ditanyakan
Bahan terkait
Semua bahan
Seleksi komputasional alih-alih coba-coba empiris: pendekatan baru untuk material baterai
Materi ini menunjukkan bagaimana basis data komputasi, machine learning, dan model generatif mempersempit pilihan komposisi yang menjanjikan, sementara laboratorium otomatis mempercepat pengujiannya; hasil akhirnya tetap bergantung pada sintesis dan pengujian, karena prediksi dapat berbeda dari konduktivitas yang sebenarnya.
20 November 2026
Evolusi benchmark agen seiring peningkatan skala kumpulan tugas: peran seleksi bukti dan perlombaan berurutan
Studi ini menjelaskan mengapa menambah jumlah tugas dapat menghambat evolusi lingkungan pengujian agen: penyebabnya adalah pemilihan bukti yang buruk, bukan volume data itu sendiri. Successive Scale Racing yang diusulkan memilih kombinasi tugas yang beragam secara bergiliran dan membandingkan kandidat dengan biaya rendah; pada tiga benchmark, metode ini meningkatkan proporsi uji coba yang berhasil saat kumpulan tugas bertambah dari 40 menjadi 200, sedangkan metode dasar mengalami penurunan, dan jumlah peluncuran verifikasi berkurang sekitar 60%.
19 November 2026
Saling meyakinkan antar-model: posisi yang dinyatakan tidak sesuai dengan perilaku dalam dialog
Dalam debat terkontrol tentang penyebab perubahan iklim, empat pasang GPT-6 Luna dan Gemini 2.5 Flash Lite menunjukkan dinamika yang berbeda dalam konvergensi atau divergensi sikap. Instruksi langsung untuk meyakinkan tidak memberikan efek yang bertahan lama, sementara posisi yang dinyatakan dan gaya berdebat yang digunakan mencerminkan hal yang berbeda.
19 November 2026