
Pemilihan encoder tidak dilakukan berdasarkan metrik yang tepat
Encoder yang dibekukan biasanya diambil ke dalam proyek dengan melihat satu hal: seberapa baik sebuah head ringan — lapisan linear, MLP kecil, atau sesuatu semacam itu — dapat dilatih di atas representasinya. Jika head sederhana mampu menarik fitur yang dibutuhkan, encoder dianggap berhasil. Tetapi penilaian semacam ini menjawab pertanyaan "apakah mudah membaca sesuatu dari embedding ini", bukan pertanyaan "apakah geometri ruang itu sendiri memisahkan fitur tersebut". Ini dua pertanyaan yang berbeda, dan mencampuradukkannya mahal: head menutupi kelemahan representasi selama tugasnya sederhana dan jumlah kelasnya sedikit.
Secara terpisah, ada masalah keseimbangan. Selama kelas-kelas kurang lebih seimbang, perbedaan antara "encoder mampu" dan "head menarik" hampir tidak terlihat. Begitu satu kelas menjadi langka, metrik berbasis tetangga terdekat mulai berbohong secara sistematis.
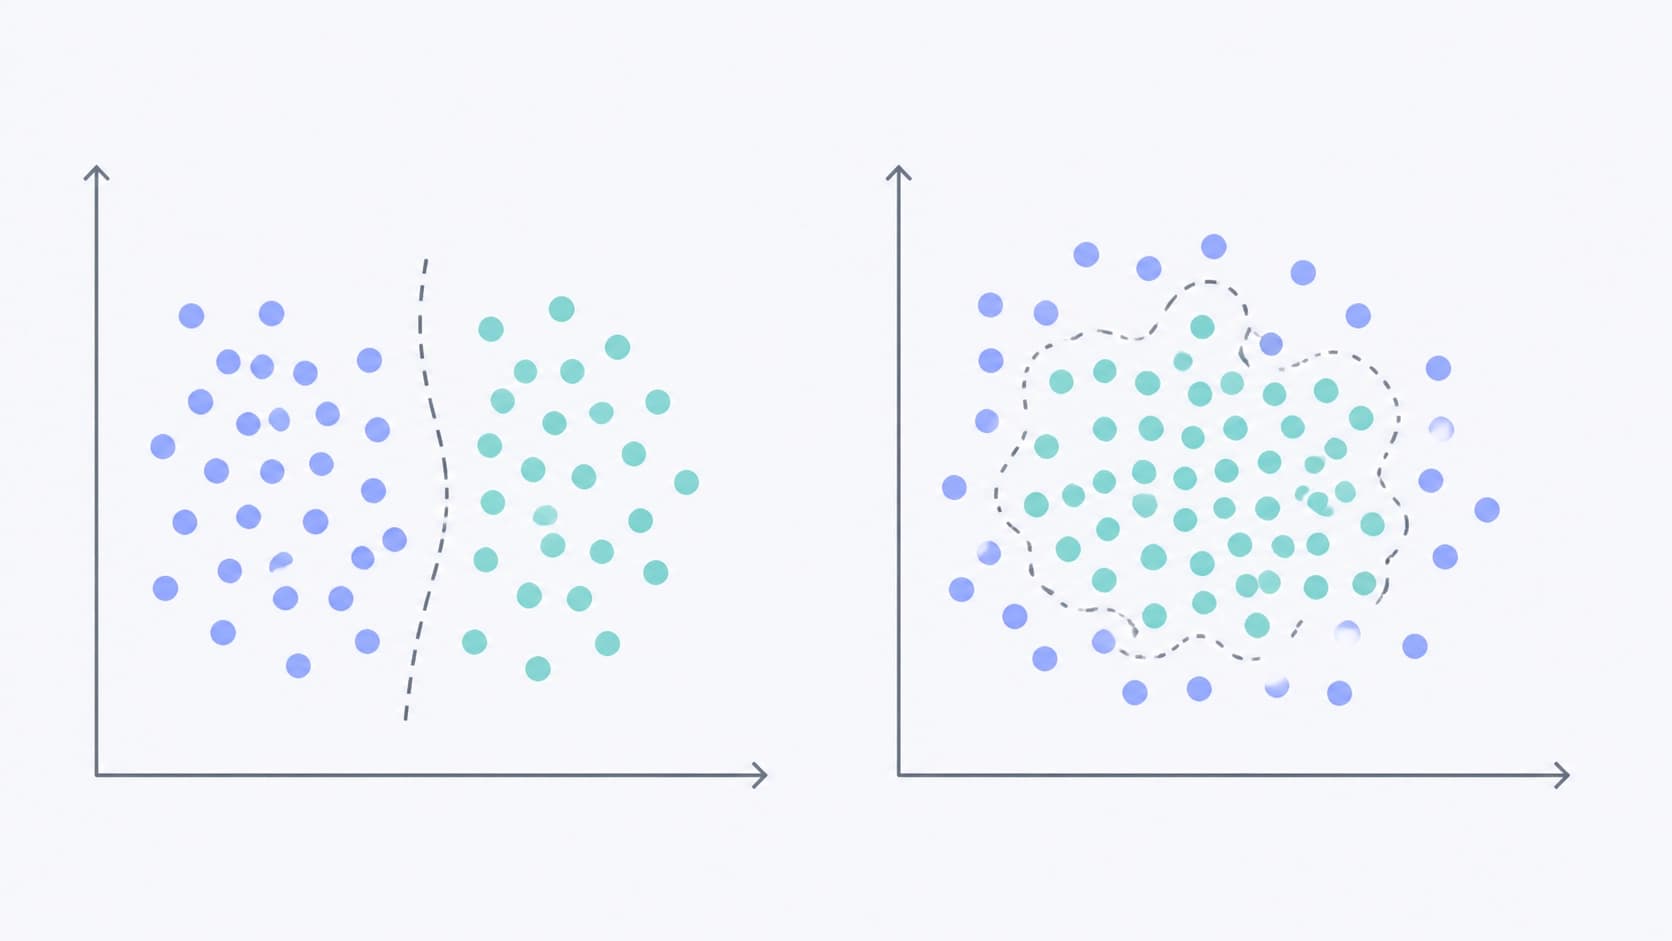
Mengapa diskordansi berdasarkan tetangga terdekat berbohong
Metrik diskordansi klasik disusun secara sederhana: untuk setiap titik dicari tetangga di ruang embedding, dan jika tetangga terdekat memiliki label yang berlawanan — kasus tersebut dicatat sebagai diskordan. Di dalam satu kelas, geometri bekerja dengan sangat baik, tidak ada keluhan terhadap tetangga.
Masalahnya terletak pada asimetri prosedur. Ketika tetangga untuk contoh positif dan negatif diambil dari himpunan dengan ukuran yang berbeda, tetangga terdekat dengan label berlawanan menang bukan karena geometrinya memang begitu, melainkan karena kelasnya memang lebih padat di sekitar lingkungan tersebut. Dengan kata lain, ke dalam hasil merembes prevalensi kelas — statistik dataset, bukan properti representasi. Efeknya tidak menyenangkan: encoder yang sepenuhnya tidak terinformasi mulai terlihat buta, padahal sebenarnya ia sama tidak bergunanya dengan koin yang jujur, dan tidak lebih buruk.
Apa yang sebenarnya diubah CANDOR
CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — mendefinisikan ulang prosedur penghitungannya sendiri. Bank tetangga di sini diambil dengan ukuran yang sama, dan konstruksi metriknya simetris terhadap permutasi label: tukar posisi positif dan negatif, dan nilainya tidak akan berubah. Akibatnya, tingkat tebakan acak ditetapkan tepat pada satu per dua — 50%. Bukan "kira-kira sekitar setengah, tergantung dataset", melainkan titik acuan yang ketat pada 1/2.
Ini bukan koreksi kosmetik. Justru titik acuan yang mengambang inilah yang menghalangi perbandingan encoder satu sama lain dan antar dataset: di tempat yang ketidakseimbangannya lebih kuat, tebakan acak tampak lebih buruk daripada kenyataannya, dan model mendapat kredit kepercayaan yang tidak layak. Ketika acuannya dipatok, perbandingan menjadi jujur.
Dan satu detail lagi yang penting untuk praktik: karena titik acuannya tetap, CANDOR dapat dihitung sebelum melatih head apa pun. Tidak ada fine-tuning, tidak ada penyetelan hyperparameter — metrik ini mendeskripsikan representasi itu sendiri dan memberi petunjuk di muka temuan mana yang didukung dengan buruk oleh encoder beku tertentu.
Verifikasi dalam skala besar
Para penulis menjalankan evaluasi secara luas: 22 encoder, 20 dataset dari 7 domain bidang, total 605.443 gambar. Cakupan sebesar itu memang diperlukan untuk memisahkan efek metrik dari kekhasan satu tugas.
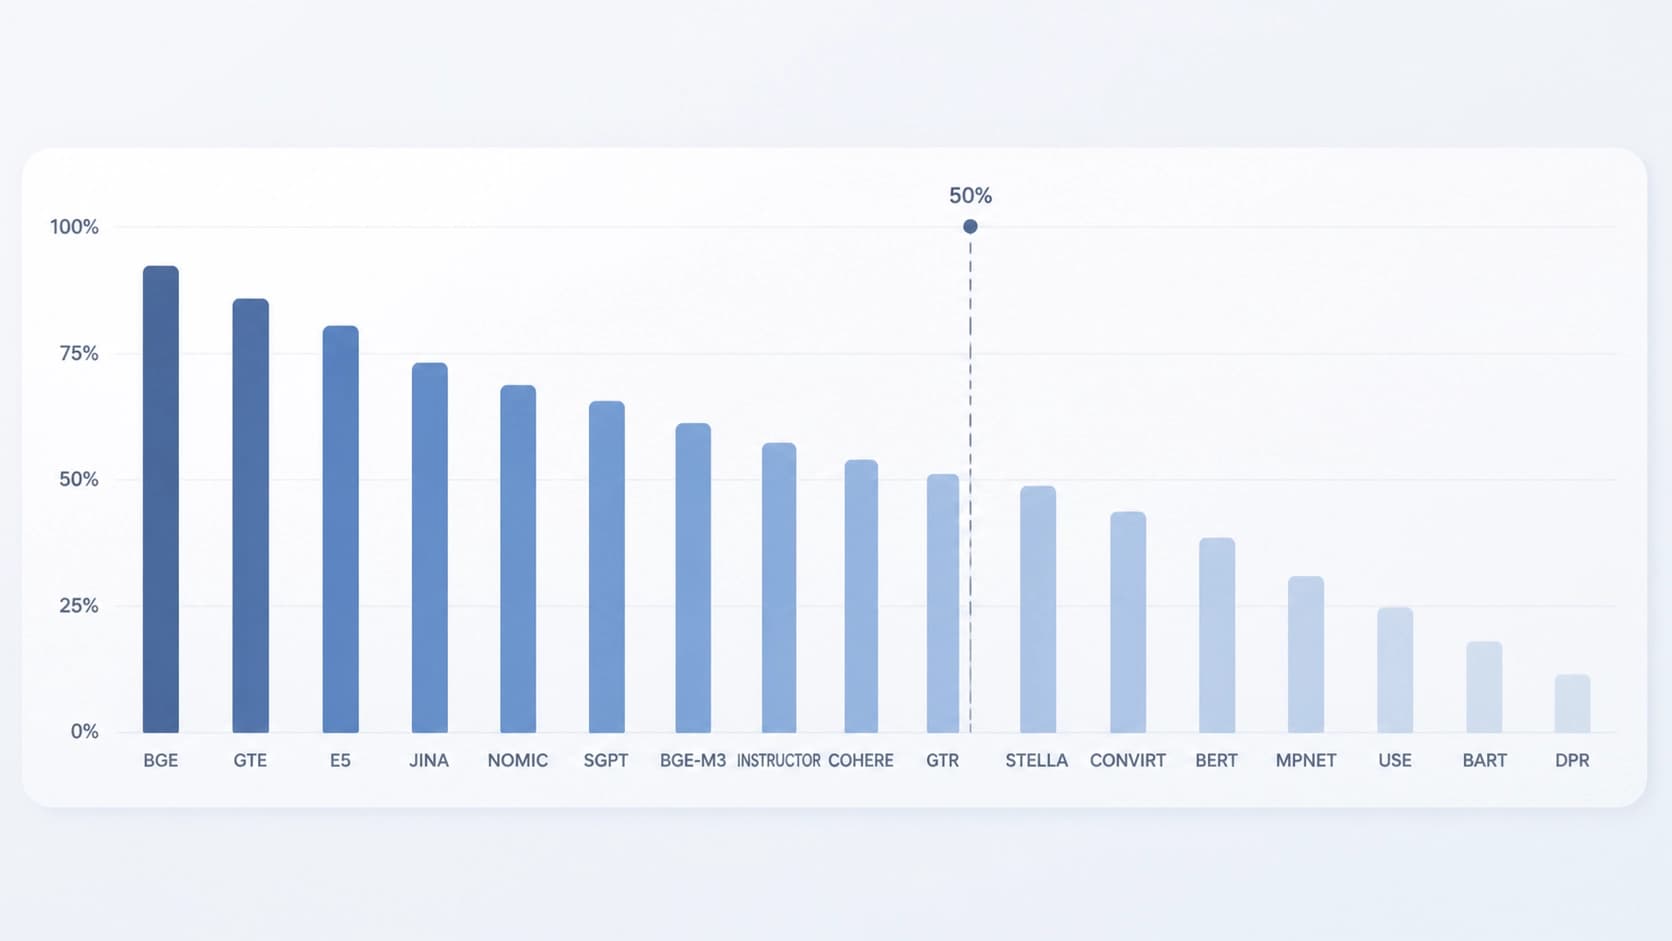
Hasilnya membalikkan kesimpulan yang dihasilkan prosedur lama. Setelah koreksi, kolaps representasi ternyata berada di bawah tingkat tebakan acak hampir di semua tempat. Cara membacanya begini: tidak ada satu pun encoder yang diuji bersifat buta — informasi tentang fitur ada dalam representasinya — tetapi semuanya lemah. Rumusan "semua lemah, tidak ada yang buta" terdengar lebih lunak daripada yang sebelumnya, dan sekaligus jauh lebih akurat menggambarkan kenyataan.
Contoh klinis: head yang kuat dengan geometri yang lemah
Ilustrasi paling jelas adalah pencitraan medis. Model terbaik untuk rongga dada membaca pneumotoraks dengan AUROC 84,5. Angkanya solid, dan biasanya itulah yang dilihat saat memilih model. Tetapi model yang sama menempatkan 18,4% kasus positif lebih dekat ke citra dengan label berlawanan daripada ke citranya sendiri dengan temuan yang sama — di dalam rumah sakit yang sama, jadi tanpa pergeseran domain sebagai penjelasannya.
Jurang antara "head menyelesaikan tugas dengan baik" dan "geometri mencampuradukkan positif dan negatif" — itulah ketidaksesuaian yang dimaksud. Head mengompensasi representasi yang lemah; metrik CANDOR menunjukkan bahwa yang harus dikompensasi itu banyak.
Selanjutnya — perbandingan antar domain. Encoder yang sama membedakan spesies burung pada tingkat 4,5 (yakni hampir sempurna), sementara temuan rongga dada tertinggal di 42,8, glaukoma di 49,8. Angka terakhir berada pada tingkat tebakan acak, dan pada dasarnya — lebih buruk daripada bobot acak. Satu encoder, satu pelatihan, tiga kualitas geometri yang sama sekali berbeda.
Defisit seleksi, bukan informasi
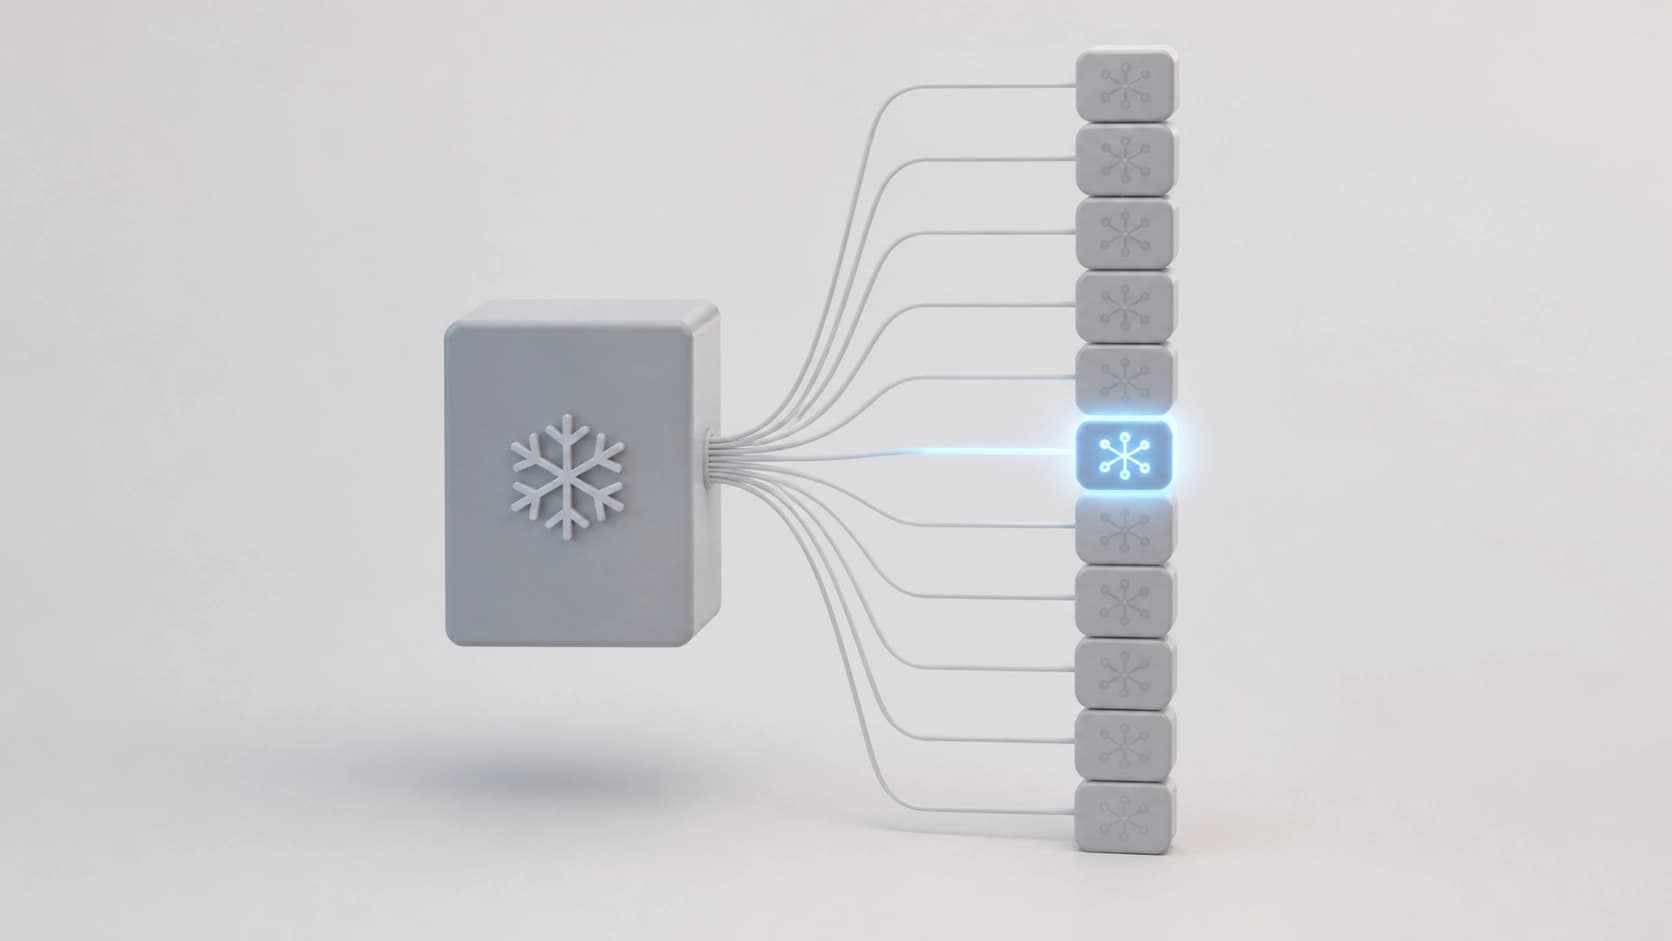
Dari sini muncul pertanyaan wajar: jadi, representasinya tidak ada harapan? Tidak juga. Kebetulan membatasi normalized margin dari head Lipschitz apa pun — yakni head dengan sensitivitas terbatas terhadap pergeseran input. Namun di dalam himpunan sebelas head terdapat satu head yang benar di semua kasus kecuali 2,8%, sedangkan satu head tunggal meleset pada 35,9%. Informasi tentang fitur ada dalam representasi — hanya saja tidak sama-sama dapat diakses oleh berbagai perangkat pembaca. Artinya, defisitnya terkait dengan seleksi, bukan dengan ketiadaan informasi.
Asosiasi menarik juga ditemukan di tempat lain: erasure retention terkait dengan kolaps. Namun dengan tujuan pelatihan, skala model, usia rilis, atau ukuran temuan, tidak ditemukan kaitan. Sederhananya, "ambil model yang lebih besar dan lebih baru" tidak menyelesaikan masalah — masalahnya bukan soal ukuran dan bukan soal usia.
Apa implikasinya dalam praktik
Tiga kesimpulan praktis.
- Hitung CANDOR sebelum melatih head. Ini pemeriksaan murah yang menunjukkan apakah encoder mendukung temuan langka tertentu, dan memungkinkan Anda menyaring backbone yang tidak cocok sebelum menghabiskan waktu untuk tuning.
- Jangan mencampuradukkan AUROC head dengan kualitas representasi. 84,5 dengan 18,4% positif diskordan — ini situasi yang normal, bukan jarang, dan layak diukur secara terpisah.
- Jangan berharap skala dan kebaruan akan memperbaiki semuanya. Tidak ditemukan asosiasi dengan ukuran, tujuan pelatihan, maupun usia rilis; kelemahan encoder beku tampak sistemik.
Nilai utama dari kisah ini bahkan bukan pada metriknya sendiri, melainkan pada kesimpulan yang terbalik. Sebelumnya tampak bahwa encoder "buta" terhadap kelas-kelas tertentu. Setelah kalibrasi berdasarkan peluang, terlihat hal lain: mereka melihat hampir di mana-mana, tetapi di mana-mana lemah. Ini gambaran yang jauh lebih tidak dramatis dan jauh lebih praktis — dengan gambaran ini jelas apa yang harus diperbaiki dan dalam urutan apa.


