
Evaluasi agen pencarian biasanya dibangun di atas skenario yang tertulis rapi: dialog yang sudah diketahui sebelumnya, kueri yang dapat diprediksi, satu pengguna "rata-rata". Pendekatan seperti ini mudah diukur, tetapi kurang mencerminkan kenyataan, di mana di balik antarmuka yang sama duduk orang-orang dengan tempo, gaya, dan kesabaran yang sangat berbeda. Karya AgentWorld: Personality-Aware Reliability Evaluation for Agentic Information Retrieval (arXiv:2608.24076, diterima di workshop Agent4IR @ KDD 2026) menawarkan cara lain untuk melihat keandalan agen — melalui karakter lawan bicara dan melalui upaya untuk merusak karakter tersebut.
Dari skrip ke kepribadian: di mana celahnya
Benchmark klasik untuk pencarian agentik menjawab pertanyaan "apakah agen menyelesaikan tugas". Namun ia diam tentang apa yang terjadi di antara langkah-langkah, dan hampir tidak mengatakan apa pun tentang sebaran hasil. Jika semua pengguna dalam pengujian berperilaku sama, dan serangan terhadap sistem tidak dimodelkan sama sekali, maka kesimpulannya pun menjadi steril: dari pengukuran seperti itu mustahil memahami di mana tepatnya agen mulai tersandung.
Justru celah inilah yang coba ditutup oleh para penulis — Gunja Agarwal, Arup Kumar Das, Arun Menon, Jitesh Chandra Mishra, dan Vignesh Divakaran. Gagasan kunci mereka sederhana: sebaran perilaku pengguna tidak boleh dihaluskan, melainkan diubah menjadi alat ukur tersendiri.
Apa itu AgentWorld
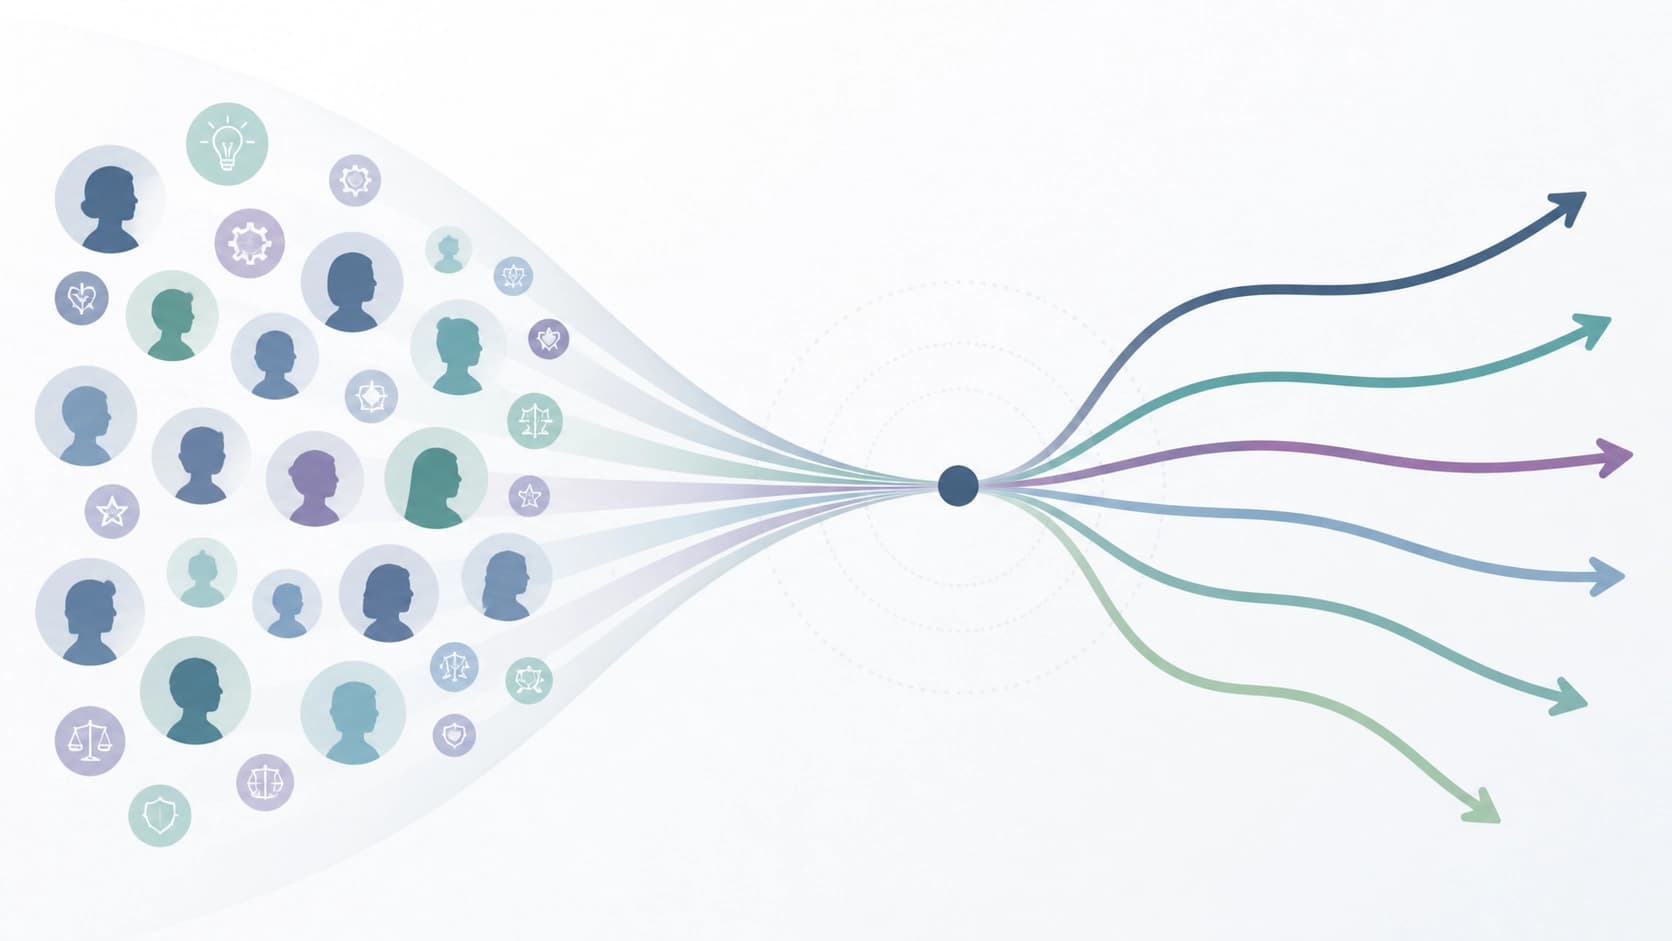
AgentWorld adalah simulator, bukan mesin pencari tersendiri. Ia tidak menyelesaikan tugas menggantikan agen, melainkan menciptakan lingkungan tempat agen dapat dijalankan melalui berbagai skenario dan berbagai tipe lawan bicara, dengan mencatat bukan hanya jawaban akhir, tetapi juga lintasan untuk memperolehnya.
Empat blok penopang
- Model pengguna berdasarkan Big Five. Persona ditentukan berdasarkan model lima faktor (juga disebut OCEAN), dan mereka tidak bekerja dalam ruang hampa: setiap pengguna memiliki keadaan sendiri dan kumpulan alat sendiri yang tersedia, dan keadaan-keadaan ini berubah sepanjang dialog.
- Metrik konsistensi pass^k. Ini bukan sekadar "berapa kali berhasil". Di sampingnya ada klasifikasi kegagalan yang struktural, pemberian poin sebagian untuk kemajuan yang tidak lengkap namun bermakna, dan verifikasi ganda atas pengalihan kendali — yaitu secara terpisah diverifikasi apakah agen mengalihkan giliran kepada manusia atau sistem lain dengan benar.
- Ekspor data untuk pelatihan lanjutan. Simulator dapat mengekspor proses yang telah terakumulasi, menyaring yang bernilai rendah, langsung dalam enam format yang layak untuk fine-tuning.
- Risk Analyser yang bersifat adversaria. Modul ini mengambil cuplikan dari "punggung" keadaan antara yang wajib dilalui agen, lalu mencabangkan proses dengan metode Monte Carlo melalui empat jenis gangguan yang terkait dengan tugas tertentu. Risiko akhir dihitung melalui rasio ΔP / ΔT, penggabungan bukti menurut Dempster—Shafer, dan atribusi kategori serangan menurut Shapley.
Perhatikan logikanya: tiga blok pertama berkaitan dengan pengukuran dan pelatihan, blok keempat berkaitan dengan prediksi kerusakan. Kerangka kerja ini sejak awal dibangun sebagai alat bukan hanya untuk diagnostik, tetapi juga untuk pengujian tekanan.
Tiga proses: dari analitik hingga serangan adversaria
Bagian eksperimental terdiri dari tiga bagian dengan tingkat "beban" yang berbeda.
- Agen analitik percakapan dijalankan terhadap sepuluh persona OCEAN. Untuk anotasi kualitas dikumpulkan 240 penilaian juri.
- Agen dukungan pelanggan diuji pada lima tugas, masing-masing dalam empat varian persona.
- Uji tekanan adversaria terhadap lima tugas yang sama: di sini ditambahkan gangguan untuk melihat seberapa cepat lintasan runtuh.
Proses ketiga ternyata paling menunjukkan. Bahkan tanpa gangguan, stabilitas lintasan minimum adalah V_min = 0.375 — artinya bahkan kondisi "bersih" pun tidak memberikan margin ketahanan. Dan ketika serangan diaktifkan, terungkap bahwa yang paling berbahaya adalah serangan bukan pada isi kueri, melainkan pada alat dan infrastruktur: atribusi menurut Shapley memberikan sekitar 46% pada tingkat sistem, dan sekitar 38% pada tingkat tindakan.
Ini adalah pergeseran penekanan yang penting. Diskusi tentang keamanan agen sering kali terbatas pada prompt injection ke dalam teks, padahal angka-angka menunjukkan bahwa risiko utama hidup di lapisan yang bertanggung jawab atas pemanggilan alat dan keadaannya.
Karakter sebagai sumber perbedaan
Yang paling menarik dalam artikel ini bukanlah skor absolut, melainkan sebaran antar persona. Pada tugas yang sama, tingkat keberhasilan berbeda secara radikal: 50% versus 100%. Ini bukan derau pengukuran, melainkan sinyal bahwa agen menangani gaya komunikasi yang berbeda dengan cara yang berbeda.
Secara terpisah disebutkan mode-mode kegagalan yang tidak ditunjukkan sama sekali oleh pengujian yang seragam:
- kebocoran lintas domain — ketika konteks satu tugas merembes ke tugas lain;
- pergeseran konteks — pergeseran topik dan tujuan secara bertahap sepanjang dialog yang panjang;
- kesenjangan kualitas antar persona sebesar 0.27 poin.
Para penulis menekankan bahwa Risk Analyser mampu mengukur kerapuhan pada tingkat lintasan — di tempat di mana metrik tunggal pass^k tidak berdaya, karena ia hanya mencatat fakta berhasil atau gagal dan tidak membedakan antara "gagal pada langkah pertama" dan "hampir sampai akhir tetapi tidak mempertahankan keadaan".
Apa manfaatnya dalam praktik
Jika kesimpulannya dianggap sebagai resep, maka tampilannya seperti ini: ujilah agen bukan pada satu pengguna "rata-rata", melainkan pada sekumpulan karakter, dan lihatlah sebaran di antara mereka, bukan rata-ratanya. Skor rata-rata bisa terbilang lumayan, sementara separuh persona secara konsisten gagal dalam skenario.
Lapisan praktis kedua adalah data. Karena simulator dapat menandai proses yang berhasil dan tidak berhasil serta mengekspornya dalam format yang siap pakai, kepribadian menjadi bukan hanya ujian, tetapi juga sumber materi pelatihan. Titik lemahnya di sini jelas: kualitas dataset semacam itu sepenuhnya bergantung pada kualitas anotasi, dan penilaian juri adalah bagian proses yang paling mahal dan subjektif.
Akhirnya, lapisan ketiga adalah prioritas dalam perlindungan. Karena bagian terbesar risiko berada pada tingkat sistem dan tindakan, bukan pada formulasi, maka yang perlu diperkuat terlebih dahulu adalah hak akses, verifikasi pemanggilan, dan ketepatan pengalihan kendali, bukan hanya filter pada teks masukan.
Apa yang perlu diingat
Perlu diingat soal skala: yang dibahas adalah tiga kumpulan eksperimen, sepuluh persona di salah satunya, dan lima tugas di dua lainnya. Angka seperti 50% versus 100% tampak dramatis, tetapi dibangun di atas sampel yang kecil — ini lebih merupakan petunjuk arah daripada putusan akhir. Selain itu, simulasi pengguna berdasarkan Big Five pasti menyederhanakan karakter nyata: manusia hidup tidak konsisten, sedangkan persona dalam simulasi tetap mengikuti profil yang telah ditentukan.
Meskipun demikian, gagasan metodologisnya tampak kokoh dan dapat dipindahkan. Keandalan agen bukanlah satu angka, melainkan distribusi menurut tipe lawan bicara dan menurut tipe kegagalan. Simulator AgentWorld mengambil langkah serius pertama agar distribusi ini dapat diukur, bukan ditebak.
Versi artikel v1 muncul pada 25 Agustus 2026, versi saat ini v2 dari 26 Agustus 2026 (ukuran 1,710 KB); DOI — 10.48550/arXiv.2608.24076, topik — cs.AI.


