
कैसे DALL-E 3 के साथ शुरू करने के लिए: सेटअप से तैयार छवियों तक एक कदम-दर-चरण गाइड
न्यूरल नेटवर्क OpenAI पाठ विवरण से छवियां बनाता है। हम कैसे पहुँच प्राप्त करने के लिए तोड़, एक विस्तृत संकेत शिल्प, और परिणाम डाउनलोड, साथ ही जहां मुक्त विकल्प उपलब्ध हैं।.
DALL-E 3 क्या है और यह कहाँ काम करता है?
DALL-E 3 OpenAI की मूल छवि मॉडल का नवीनतम संस्करण है। यह तैयार किए गए चित्रों में सादे पाठ विवरण को बदल देता है, और यह अपने पूर्ववर्तियों की तुलना में अधिक सटीक रूप से देखता है। मुख्य अंतर एक चैट इंटरफ़ेस के साथ अंतर्निहित एकीकरण है: आप सिर्फ एक संकेत नहीं भेज सकते हैं, बल्कि इसे तंत्रिका नेटवर्क के साथ भी चर्चा कर सकते हैं, विवरण को स्पष्ट कर सकते हैं, और चरण-दर-चरण प्रक्रिया को निर्देशित कर सकते हैं। नतीजतन, मॉडल एक साधारण जनरेटर से एक संवादात्मक मोड के साथ एक पूर्ण विकसित चित्रकार में बदल देता है।
मॉडल तक पहुंच भुगतान योजनाओं के माध्यम से उपलब्ध है। व्यक्तिगत उपयोगकर्ताओं के लिए, सबसे स्पष्ट विकल्प प्रति माह $ 20 पर एक ChatGPT प्लस सदस्यता है। यह आपको हर तीन घंटे में 50 छवियों को बनाने की अनुमति देता है, जिससे यह नियमित प्रयोग और व्यावसायिक कार्यों के लिए उपयुक्त हो जाता है। व्यवसाय एंटरप्राइज़ कॉर्पोरेट योजना के लिए साइन अप कर सकते हैं, जहां शर्तों को व्यक्तिगत रूप से चर्चा की जाती है। यदि आप अभी तक भुगतान नहीं करना चाहते हैं, तो एक हल्का रास्ता है - मुफ्त तीसरे पक्ष की वेबसाइट जो मॉडल के साथ काम करती हैं। उनके पास आमतौर पर दैनिक पीढ़ी की सीमा होती है, लेकिन यह पहली कोशिश के लिए पर्याप्त है।
कनेक्ट होना और उत्पन्न करना शुरू करना
अपनी पहुँच विधि चुनें
सबसे पहले, यह तय करें कि आप कहां काम करेंगे। यदि आपको पूर्ण सुविधा सेट और निर्बाध चैट एकीकरण की आवश्यकता है, तो सदस्यता लें आधिकारिक OpenAI वेबसाइट। भुगतान के बाद, भुगतान तक पहुंच DALL-E 3 आपके खाते में खुल जाएगा - मॉडल को पहले से ही चैट इंटरफ़ेस में एकीकृत किया जाएगा। बिना पंजीकरण के त्वरित परीक्षण के लिए, dalle3.org जैसी साइट अच्छी तरह से काम करती है। इस तरह के प्लेटफार्मों को आमतौर पर एक बैंक कार्ड की आवश्यकता नहीं होती है, लेकिन प्रति दिन प्रयास की संख्या सीमित है - फिर भी, आप यह पता लगा सकते हैं कि क्या आप बातचीत की यह शैली आपको सूट करती है।
अपने खाते में लॉग इन करें और अपना पहला अनुरोध भेजें
सब्सक्राइबर्स को सिर्फ चैटजीपीटी वेबसाइट पर जाने और एक नई बातचीत शुरू करने की आवश्यकता है। वहाँ आप एक नियमित इनपुट क्षेत्र देखेंगे - यही वह जगह है जहाँ आप अपना प्रॉम्प्ट टाइप करते हैं। इंटरफ़ेस आपको शब्द के साथ मदद करने के लिए मॉडल से भी पूछता है: "एक खिलने वाले जंगल में अंतरिक्ष यात्री के साथ एक दृश्य के विस्तृत विवरण के साथ आओ" लिखें - और तंत्रिका नेटवर्क अनुरोध का एक विस्तारित संस्करण सुझाएगा, जिसे आप फिर सीधे पीढ़ी में भेज सकते हैं। पहली छवि कुछ सेकंड के भीतर दिखाई देगी, जिसके बाद आप इसे बचा सकते हैं या विवरण को परिष्कृत रख सकते हैं।
कैसे शिल्प संकेत और परिणाम को परिष्कृत
अधिक जानकारी
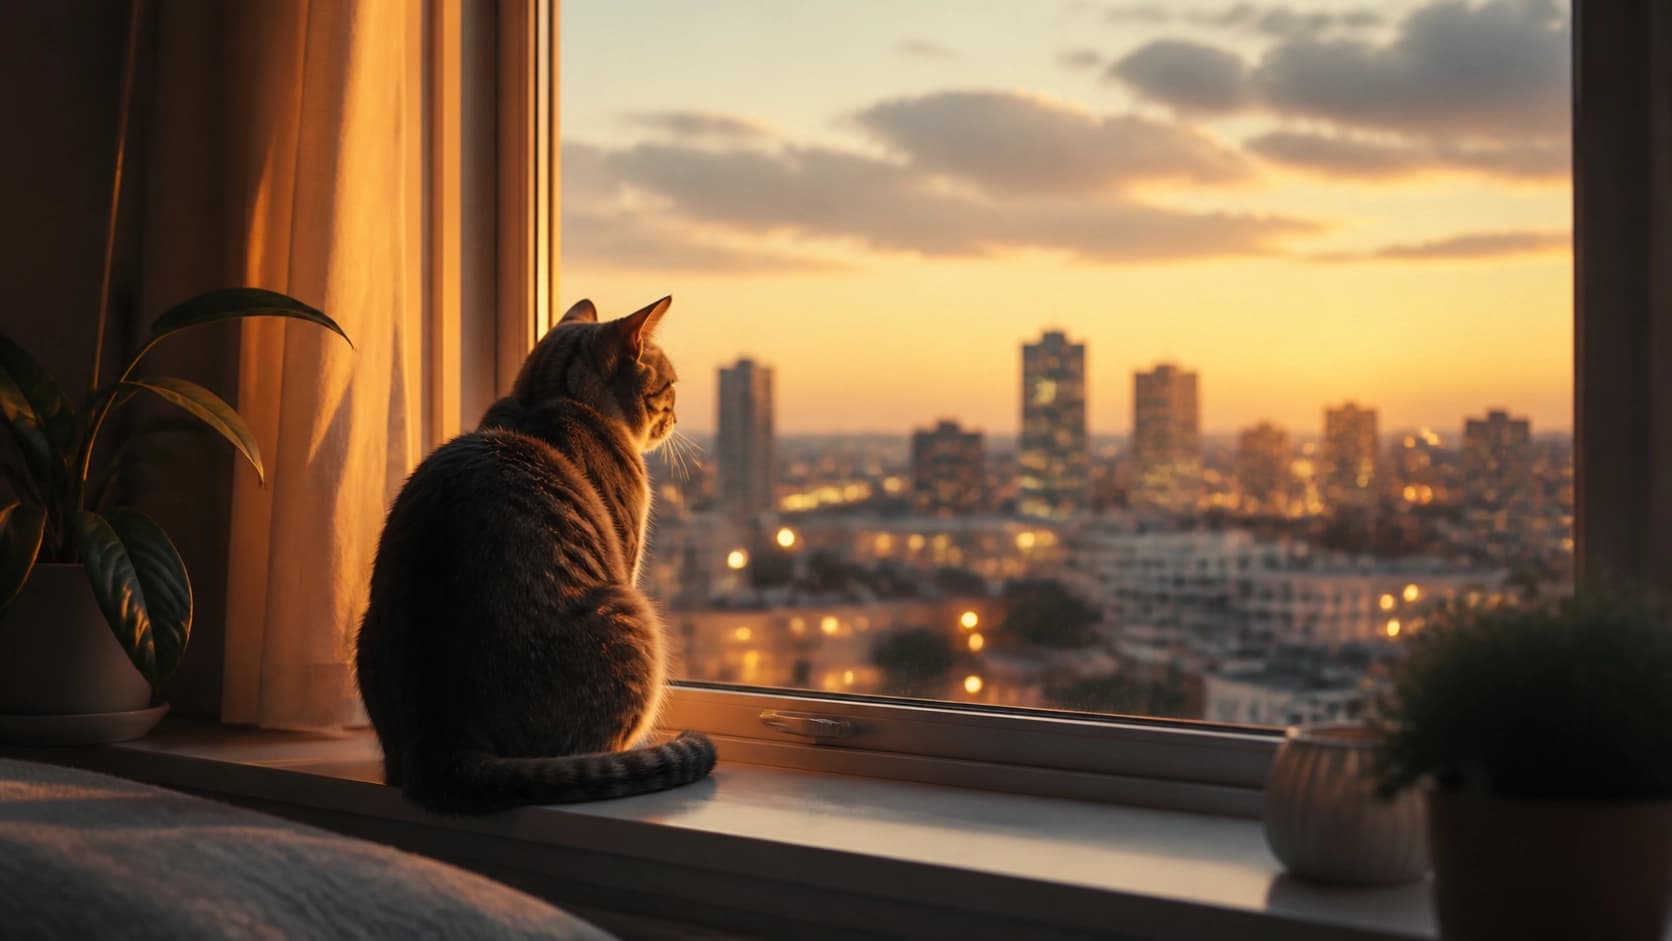
DALL-E 3 अमीर विवरणों को अच्छी तरह से समझता है, लेकिन बिना किसी विशिष्ट परिणाम के अक्सर धुंधला हो जाता है। रंग, आकार, सामग्री, प्रकाश व्यवस्था, वस्तु प्लेसमेंट और यहां तक कि मूड निर्दिष्ट करें। "एक बिल्ली आकर्षित" के बजाय यह बेहतर है कि "विंडो के बाहर एक windowsill, शाम की रोशनी, शहर पर एक ग्रे धारीदार बिल्ली झूठ बोलना" लिखना बेहतर है। मॉडल सटीक दृश्य तत्वों में इस तरह के विवरण बदल जाता है। यदि आप एक प्रॉम्प्ट को स्ट्रक्चर करने का आश्वासन नहीं देते हैं, तो आप मदद के लिए चैटजीपीटी से पूछ सकते हैं - यह एक विस्तृत परिदृश्य में एक लघु अनुरोध को पीछे छोड़ देगा, और वहाँ कम होगा।
रिफाइनिंग और डाउनलोड करना
डिफ़ॉल्ट रूप से, DALL-E 3 प्रत्येक अनुरोध के लिए दो छवि संस्करण उत्पन्न करता है। अगर उनमें से एक पहले से ही काम करता है - महान, आप सीधे डाउनलोड करने के लिए जा सकते हैं। लेकिन अक्सर आप कुछ बदलना चाहते हैं: रंग, पृष्ठभूमि, चरित्र मुद्रा, या संरचना। खरोंच से शुरू होने के बजाय, बस बातचीत में लिखें कि क्या तय करना है, और मॉडल आपके संपादन के साथ छवि को वापस ले जाएगा। जब तक आप चाहते हैं तब तक आप इस संवाद को रख सकते हैं। एक बार छवि तैयार होने के बाद, डाउनलोड आइकन पर क्लिक करें - फ़ाइल को उच्च गुणवत्ता में आपके डिवाइस पर सहेज लिया जाएगा।
उत्पन्न छवियों का उपयोग कहां करें
ऐसे चित्रों के लिए आवेदनों की सीमा व्यावहारिक रूप से असीम है। विपणन में, वे सोशल मीडिया, विज्ञापन बैनर और इवेंट घोषणाओं के लिए उपयोग किए जाते हैं। डिजाइनर उन्हें अवधारणाओं, प्रस्तुतियों और मॉकअप के आधार पर उपयोग करते हैं। जेनरेशन का उपयोग कपड़ों, मग, ग्रीटिंग कार्ड और अन्य व्यक्तिगत उत्पादों पर प्रिंट बनाने के लिए भी किया जाता है।
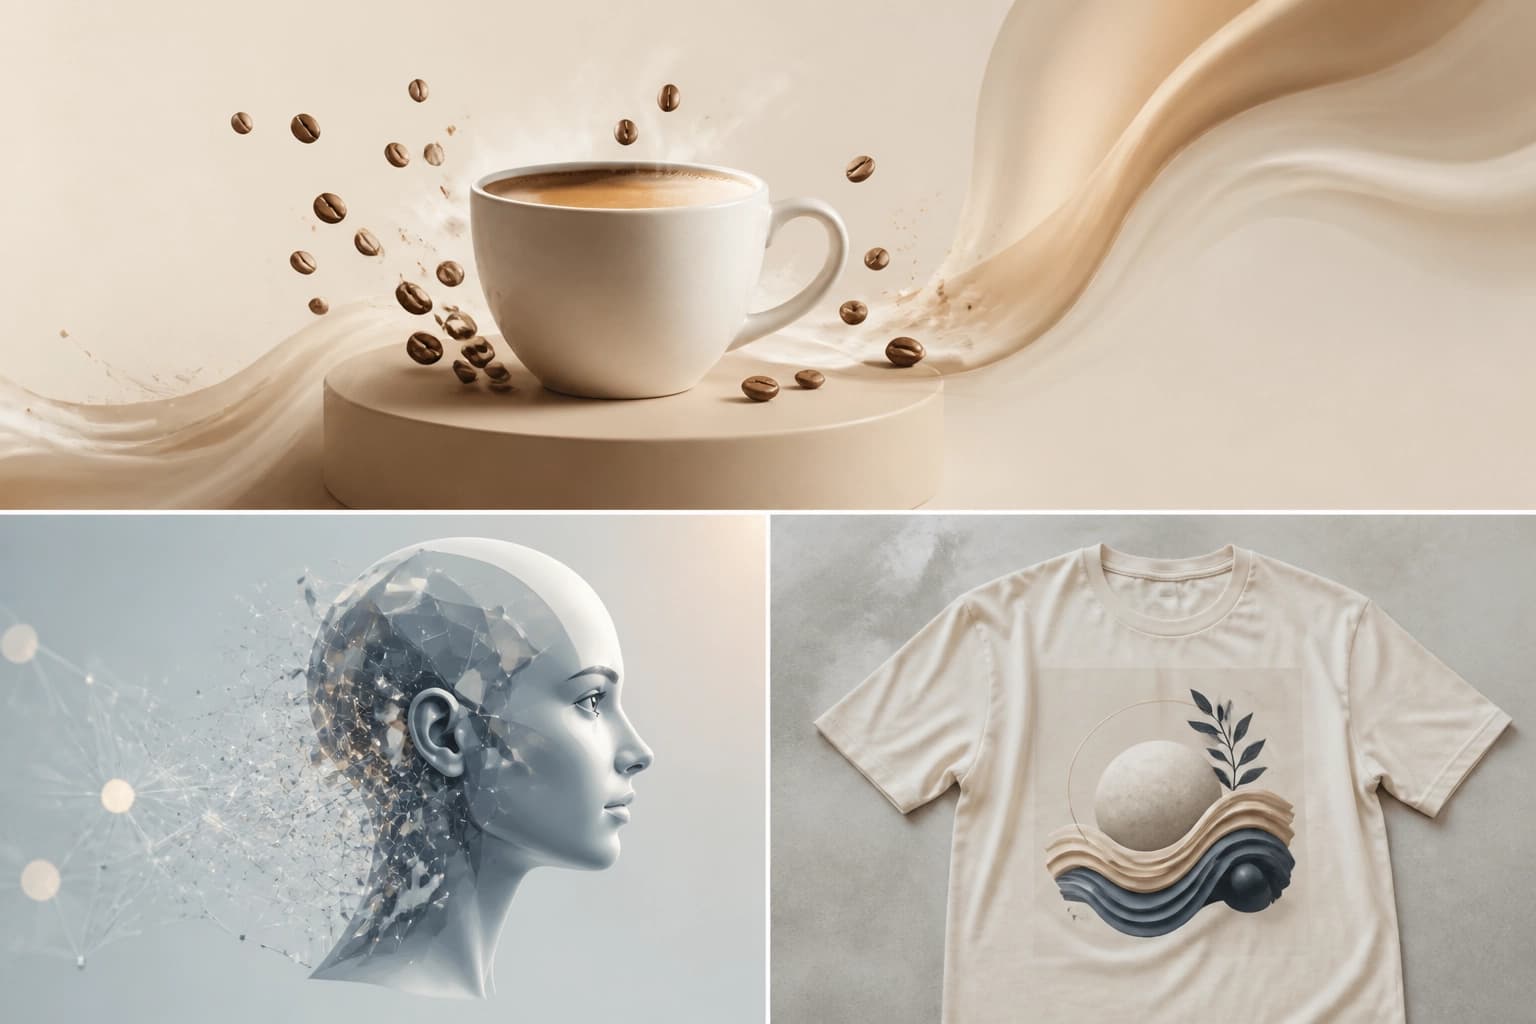
शिक्षा में, ऐसी छवियां पाठ और पाठ्यक्रमों के लिए दृश्य सामग्री बनाने में मदद करती हैं, और मीडिया और मनोरंजन में - लेख, वीडियो, कवर और गेम अवधारणा कला को चित्रित करने के लिए। मुख्य बात यह है कि हमेशा यह जांचना है कि क्या परिणाम कार्य से मेल खाता है, और इसे बातचीत में परिष्कृत करने में संकोच नहीं करता है, क्योंकि यह ठीक से ठीक-ट्यून की क्षमता है जो इस मॉडल के साथ काम करना इतना सुविधाजनक बनाता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
डिफ्यूज़न भाषा मॉडल्स को फ़ाइन-ट्यून करने की GoldiMask विधि: संदर्भ चयन और लक्ष्य भारांकन
इस कार्य में GoldiMask प्रस्तुत किया गया है—डिस्क्रीट डिफ्यूज़न वाले भाषा मॉडलों के लिए supervised fine-tuning का एक तरीका, जो सबमॉड्यूलर फ़ंक्शन के लगभग अधिकतमीकरण के ज़रिए दिखाई देने वाले टोकन चुनता है और शेष लक्ष्यों को उनकी प्रशिक्षण उपयोगिता के अनुसार वज़न देता है। कई मॉडलों और डेटासेट पर किए गए प्रयोग औसत सटीकता में वृद्धि, तर्क और प्रोग्रामिंग कार्यों में बेहतर प्रदर्शन, और लगभग समान गुणवत्ता के साथ GSM8K तथा MATH-500 पर समानांतर डिकोडिंग के कम पुनरावृत्ति चरण दर्शाते हैं।
30 अक्टूबर 2026
Google Research का MSEB: बेंचमार्क अनुबंध के तहत ऑडियो एन्कोडर का कार्यान्वयन और चार कार्य-श्रेणियों पर मूल्यांकन
mseb==0.1.0 पैकेज का व्यावहारिक विश्लेषण: types, encoder और evaluators लेयरों की आर्किटेक्चर, सिंथेटिक कॉर्पस पर दो प्रदर्शनकारी एनकोडर, और वर्गीकरण, क्लस्टरिंग, खोज तथा सेगमेंटेशन के मेट्रिक्स को सीधे कॉल करना। यह सामग्री दिखाती है कि अपने मॉडल को अमूर्त MultiModalEncoder के साथ कैसे संगत करें, SoundEmbedding फ़ॉर्मैट की व्याख्या कैसे करें और बेंचमार्क में बाद में भेजने के लिए TaskMetadata कैसे तैयार करें।
10 अक्टूबर 2026
तर्क-कौशल खोए बिना RL के बाद LLM को फाइन-ट्यून करने के लिए शून्य-आधार LoRA
लेखक सुदृढीकरण सीखने से प्रशिक्षित मॉडलों को अनुकूलित करने का एक पैरामीटर-कुशल तरीका प्रस्तुत करते हैं, जिसमें LoRA अपडेट्स को तर्क-संबंधी सक्रियणों के सन्निकट शून्य-स्थान में प्रक्षेपित किया जाता है। यह तरीका अनुकूलन की गुणवत्ता में सामान्य LoRA से पीछे रहे बिना, तर्क की सटीकता को फ़ाइन-ट्यूनिंग से पहले के स्तर पर बनाए रखता है।
5 अक्टूबर 2026