RL के बाद SFT से तर्क-क्षमता को खतरा क्यों है
रीइन्फोर्समेंट लर्निंग बड़े भाषा मॉडलों की तर्क-क्षमता विकसित करती है। यह तरीका LLM के पोस्ट-ट्रेनिंग के लिए प्रभावी साबित हुआ है। इसके बाद किया जाने वाला supervised fine-tuning, पोस्ट-RL मॉडल को ज्ञान के नए क्षेत्रों या व्यवहार के नए प्रकारों के अनुकूल बनाता है। ऐसा SFT अर्जित क्षमताओं को गंभीर रूप से बदल सकता है।
क्षमताओं को भूलने से बचाने के मौजूदा तरीके:
- अनुभव का पुनः उपयोग;
- विशेषीकृत इनिशियलाइज़ेशन;
- ग्रेडिएंट प्रोजेक्शन के साथ सीमित ऑप्टिमाइज़ेशन।
इन तरीकों से या तो क्षमताएँ सीमित रूप से सुरक्षित रहती हैं, या फिर इनके लिए काफी अतिरिक्त कंप्यूटिंग की ज़रूरत होती है। व्यावहारिक मानदंड: पोस्ट-RL मॉडल के लिए ऐसी विधि चुनें, जो तर्क-क्षमता के बदल जाने का जोखिम कम करे।
अनुकूलन के संसाधन के रूप में नल-स्पेस
लेखक दिखाते हैं कि तर्क-क्षमता से जुड़ी एक्टिवेशन कम आयाम वाले उपस्पेस में केंद्रित होती हैं। अनुकूलन के लिए नल-स्पेस में काफी क्षमता बची रहती है। कुछ ही उदाहरणों से अनुमानित नल-स्पेस का भरोसेमंद आकलन किया जा सकता है।
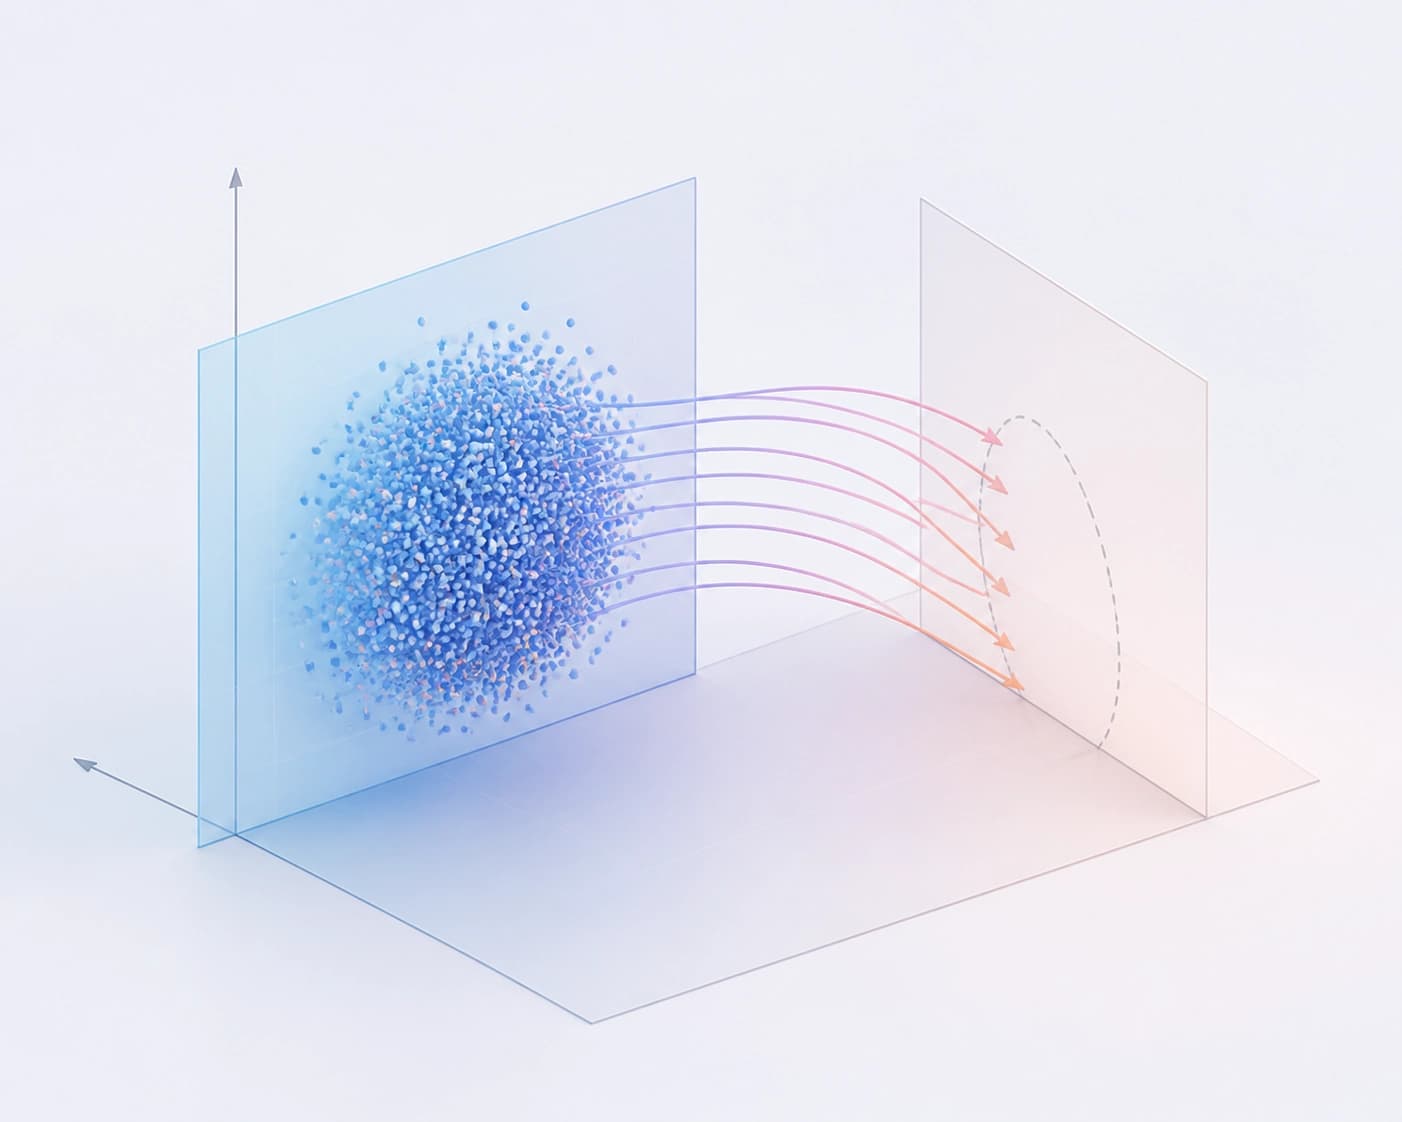
व्यावहारिक मानदंड: नल-स्पेस में अपडेट बनाने वाली विधि उपलब्ध खाली क्षमता का इस्तेमाल करती है। इससे तर्क-क्षमता से जुड़ी एक्टिवेशन प्रभावित नहीं होतीं।
NB-LoRA की संरचना
Null-Basis Low-Rank Adaptation (NB-LoRA), पोस्ट-RL LLM के लिए पैरामीटर-कुशल अनुकूलन की एक विधि है। इसे arXiv:2609.25618 लेख में प्रस्तावित किया गया था। यह अर्जित तर्क-क्षमताओं को सुरक्षित रखती है।
काम करने के चरण:
- तर्क-क्षमता से जुड़ी एक्टिवेशन के आधार पर एक स्थिर अनुमानित नल-बेसिस बनाया जाता है।
- LoRA अपडेट को इस बेसिस के ज़रिए पुनः पैरामीटराइज़ किया जाता है।
- तर्क-क्षमता को सुरक्षित रखने के लिए लेयर-स्तर पर हिडन स्टेट्स को बनाए रखने की बाधा तय की जाती है।
- फाइन-ट्यूनिंग के दौरान इस बाधा का पालन किया जाता है।
व्यावहारिक मानदंड: जब पोस्ट-RL मॉडल की तर्क-क्षमता को बनाए रखते हुए SFT करना हो, तो NB-LoRA चुनें।
मौजूदा तरीकों से तुलना
तालिका में तंत्र और विशेषताओं की तुलना की गई है।
| मानदंड | मौजूदा तरीके | NB-LoRA |
|---|---|---|
| तंत्र | अनुभव का पुनः उपयोग, विशेषीकृत इनिशियलाइज़ेशन, ग्रेडिएंट प्रोजेक्शन के साथ सीमित ऑप्टिमाइज़ेशन | स्थिर अनुमानित नल-बेसिस के ज़रिए LoRA का पुनः पैरामीटराइज़ेशन |
| विशेषता | क्षमताएँ सीमित रूप से सुरक्षित रहती हैं या काफी अतिरिक्त कंप्यूटिंग की ज़रूरत होती है | लेयर-स्तर पर हिडन स्टेट्स को बनाए रखने की बाधा |
व्यावहारिक मानदंड: अगर तर्क-क्षमता को सुरक्षित रखना प्राथमिकता है, तो NB-LoRA इसके लिए एक अंतर्निहित बाधा देती है। मौजूदा तरीकों में सीमित संरक्षण और अतिरिक्त कंप्यूटिंग के बीच चुनाव करना पड़ता है।
प्रयोगों के नतीजे और चयन के मानदंड
प्रयोगों में RL से प्रशिक्षित कई LLM और बाद के विविध कार्य शामिल हैं। NB-LoRA, मानक LoRA के स्तर का अनुकूलन-गुणवत्ता दिखाती है। यह तर्क-क्षमता की सटीकता को फाइन-ट्यूनिंग से पहले के स्तर के करीब बनाए रखती है। यह संरक्षण तर्क-क्षमता के होल्डआउट बेंचमार्क तक भी बना रहता है।
व्यावहारिक मानदंड: ऐसे पोस्ट-RL LLM के लिए, जिनकी तर्क-क्षमता को SFT से खतरा है, NB-LoRA को अपने कार्यों पर जाँचने योग्य विकल्प के रूप में देखा जा सकता है।