
डिफ्यूज़न भाषा मॉडल्स को फ़ाइन-ट्यून करने की GoldiMask विधि: संदर्भ चयन और लक्ष्य भारांकन
इस कार्य में GoldiMask प्रस्तुत किया गया है—डिस्क्रीट डिफ्यूज़न वाले भाषा मॉडलों के लिए supervised fine-tuning का एक तरीका, जो सबमॉड्यूलर फ़ंक्शन के लगभग अधिकतमीकरण के ज़रिए दिखाई देने वाले टोकन चुनता है और शेष लक्ष्यों को उनकी प्रशिक्षण उपयोगिता के अनुसार वज़न देता है। कई मॉडलों और डेटासेट पर किए गए प्रयोग औसत सटीकता में वृद्धि, तर्क और प्रोग्रामिंग कार्यों में बेहतर प्रदर्शन, और लगभग समान गुणवत्ता के साथ GSM8K तथा MATH-500 पर समानांतर डिकोडिंग के कम पुनरावृत्ति चरण दर्शाते हैं।
मास्किंग एक साथ दो निर्णय तय करती है
डिस्क्रीट डिफ्यूज़न भाषा मॉडल का फ़ाइन-ट्यूनिंग, मास्क किए गए टोकन को पुनर्स्थापित करने पर निर्भर करता है। उत्तर के कुछ टोकन मास्क से ढक दिए जाते हैं, और मॉडल दिखाई देने वाले संदर्भ के आधार पर उनके मूल मानों का अनुमान लगाता है।
मास्किंग की योजना एक साथ दो चीज़ें तय करती है। यह निर्धारित करती है कि मॉडल को कौन-सा संदर्भ उपलब्ध होगा। यह भी तय करती है कि कौन-से टोकन पूर्वानुमान के लक्ष्य बनेंगे।
ये निर्णय आपस में जुड़े हुए हैं: किसी टोकन को दिखाने पर वह लक्ष्य नहीं रह जाता। समान रूप से यादृच्छिक मास्किंग इस संबंध पर ध्यान नहीं देती। इसलिए कुछ टोकन ऐसे स्थानों पर दिखा दिए जाते हैं जहाँ इससे पूर्वानुमान में बहुत कम मदद मिलती है।
GoldiMask पद्धति का वर्णन शोधपत्र Fine-Tuning Diffusion Language Models with Context Selection and Target Weighting (arXiv:2609.38385, 29 सितंबर 2026) में किया गया है। इसे डिस्क्रीट डिफ्यूज़न भाषा मॉडल के supervised fine-tuning के लिए बनाया गया है।
| निर्णय | समान रूप से यादृच्छिक मास्किंग | GoldiMask |
|---|---|---|
| संदर्भ के रूप में कौन-से टोकन दिखाने हैं | यादृच्छिक चयन | सबमॉड्यूलर उद्देश्य फ़ंक्शन के आधार पर चयन |
| बचे हुए लक्ष्य टोकन का भार | चुने गए संदर्भ पर निर्भर नहीं करता | संदर्भ से मिलने वाली मदद और प्रशिक्षण की संभावना पर निर्भर करता है |
| दोनों निर्णयों के बीच संबंध | ध्यान में नहीं रखा जाता | मॉडल के संकेतों के ज़रिए ध्यान में रखा जाता है |
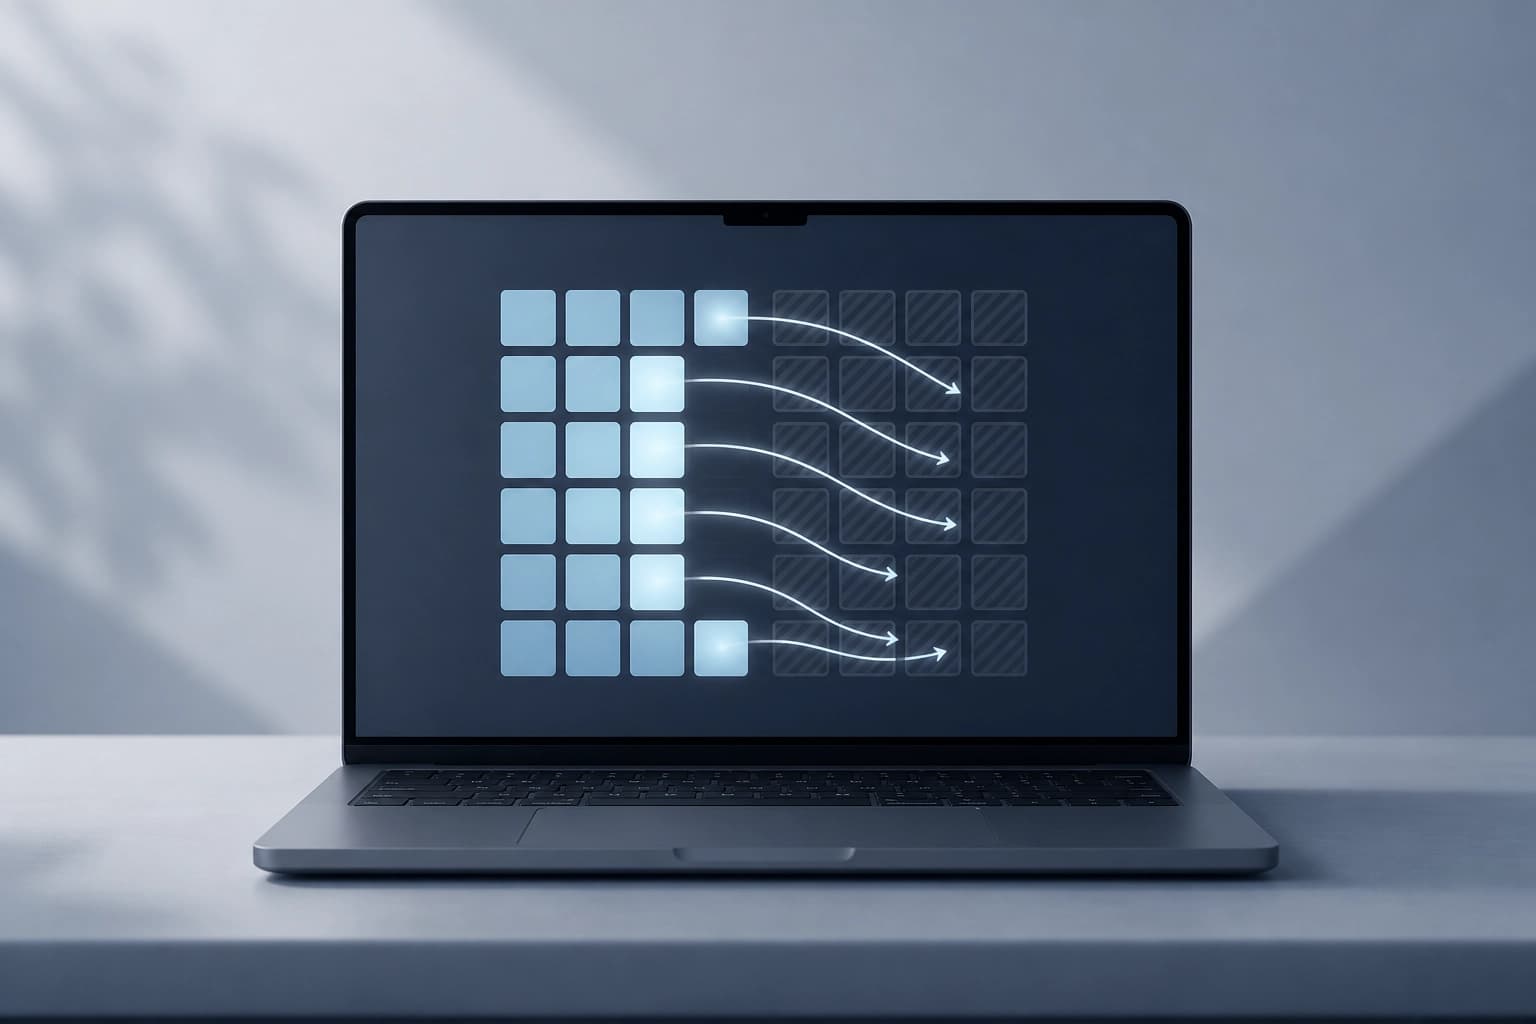
मानदंड: मास्किंग योजना का मूल्यांकन संदर्भ और लक्ष्यों के बारे में एक संयुक्त निर्णय के रूप में किया जाना चाहिए। इससे पता चलता है कि टोकन दिखाना कहाँ उचित है और कहाँ नहीं।
मॉडल के संकेतों के आधार पर संदर्भ का चयन
GoldiMask उन टोकन का चयन करता है जिन्हें संदर्भ के रूप में दिखाया जाएगा। यह चयन लगभग सबमॉड्यूलर उद्देश्य फ़ंक्शन को अधिकतम करता है।
यह विधि मॉडल के संकेतों का उपयोग करती है और दो चीज़ों के बीच संतुलन बनाती है:
- किसी विशिष्ट टोकन को दिखाने से मिलने वाला लाभ;
- पूर्वानुमान के लक्ष्य के रूप में उस टोकन का मूल्य।
जो टोकन आसपास के टोकन का पूर्वानुमान लगाने में मदद करता है, उसे दिखाना फ़ायदेमंद है। जिस टोकन का मॉडल ठीक से पूर्वानुमान नहीं लगा पाता, उसे लक्ष्य के रूप में छोड़ना अधिक फ़ायदेमंद है।
व्यावहारिक मानदंड: संदर्भ का यादृच्छिक चयन मॉडल के संकेतों का उपयोग नहीं करता। यदि यही योजना अपनाई जाती है, तो संदर्भ चयन की संभावना का उपयोग नहीं हो पाता।
लक्ष्य टोकन का भार निर्धारित करना
संदर्भ चुनने के बाद, कुछ टोकन पूर्वानुमान के लक्ष्य बने रहते हैं। GoldiMask दो कारकों को ध्यान में रखते हुए उनका भार निर्धारित करता है:
- चुना गया संदर्भ किसी विशिष्ट टोकन का पूर्वानुमान लगाने में कितनी मदद करता है;
- उस टोकन में प्रशिक्षण की कितनी संभावना बाकी है।
इस तरह भार, लक्ष्यों को संदर्भ के बारे में पहले ही लिए गए निर्णय से जोड़ता है। भार निर्धारित करने से यह नहीं चुना जाता कि क्या दिखाना है। इससे तय होता है कि बंद रह गए टोकन प्रशिक्षण में कितना योगदान देंगे।
मानदंड: मास्किंग योजना का विश्लेषण करते समय दो प्रश्न अलग-अलग रखना उपयोगी है—क्या दिखाना है और बचे हुए टोकन को किस भार से प्रशिक्षित करना है।
मॉडल और डेटासेट पर परिणाम
GoldiMask को तीन बेस मॉडल और तीन प्रशिक्षण डेटासेट पर परखा गया। अधिकांश मूल्यांकित सेटिंग में इस विधि की औसत सटीकता सबसे अधिक रही।
इससे तर्क और कोड जनरेशन से जुड़े कार्यों में सुधार हुआ। घटकों के एब्लेशन से पता चला कि सुधार में दोनों तंत्र योगदान देते हैं: संदर्भ का चयन और लक्ष्य टोकन का भार निर्धारित करना।
व्यावहारिक मानदंड: अधिकांश सेटिंग में सबसे अधिक सटीकता का अर्थ यह नहीं है कि हर कॉन्फ़िगरेशन में लाभ मिलेगा। इस विधि को किसी विशिष्ट “बेस मॉडल + प्रशिक्षण डेटासेट” जोड़ी पर जाँचना उपयोगी है।
समानांतर डिकोडिंग पर प्रभाव
एक अलग परिणाम विश्वास सीमा के साथ समानांतर डिकोडिंग से संबंधित है। GSM8K और MATH-500 पर GoldiMask डिकोडिंग पुनरावृत्तियों की संख्या कम करता है।
विश्वास की ऊँची सीमाओं पर भी सटीकता लगभग समान बनी रहती है।
व्यावहारिक मानदंड: यदि पाइपलाइन में विश्वास सीमा के साथ समानांतर डिकोडिंग का उपयोग होता है, तो यह विधि डिकोडिंग चरणों की संख्या और सटीकता—दोनों को प्रभावित करती है। यहाँ केवल सटीकता के आधार पर मूल्यांकन करना अधूरा होगा।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026