
मिथुन 2.5 फ्लैश नैनो केले के साथ सेल्फी से आर्ट एल्बम कैसे बनाएं
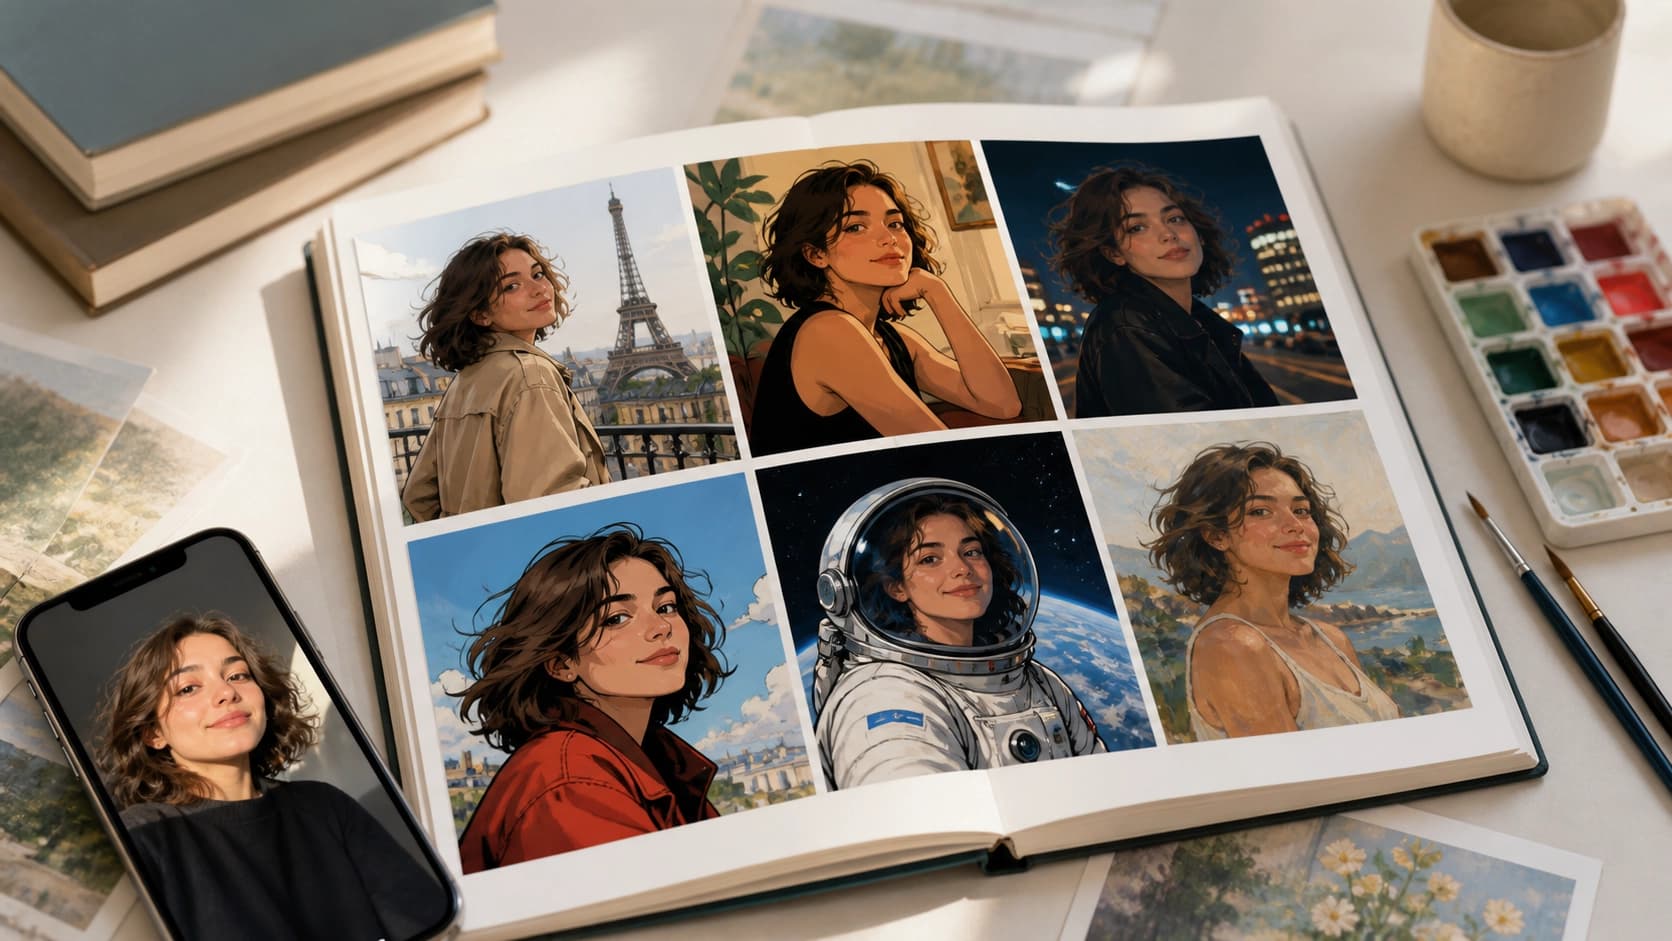
जेमिनी 2.5 फ्लैश नैनो केले मॉडल के साथ काम करने के लिए चरण-दर-चरण गाइड: अपनी तस्वीर अपलोड करें, संकेत चुनें, और विभिन्न शैलियों और स्थानों में नई छवियां प्राप्त करें - पेरिस से अंतरिक्ष तक। हम बताते हैं कि Google AI स्टूडियो में मुफ्त में एक व्यक्तिगत कला एल्बम कैसे बनाया जाए और कैसे बनाया जाए पर वैकल्पिक मंच lmarena.ai।.
नैनो केले क्या है?
मिथुन 2.5 फ्लैश नैनो केले Google AI स्टूडियो के माध्यम से उपलब्ध एक प्रयोगात्मक छवि उत्पादन मॉडल है। इसकी मुख्य विशेषता तस्वीरों को संपादित करने की क्षमता है जबकि किसी व्यक्ति की चेहरे की विशेषताओं को लगभग अपरिवर्तित रखने की क्षमता है। सीधे शब्दों में कहें, आप अपनी सेल्फी अपलोड करते हैं, और तंत्रिका नेटवर्क "redresses" आप, किसी भी सेटिंग में आपको स्थान देता है, और बदलता है चित्र की शैली - पेरिस के कलाकार से एक विज्ञान-फाई ब्लॉकबस्टर में एक चरित्र के लिए।
इसके लिए धन्यवाद, आप फोटोशॉप कौशल के बिना और स्टूडियो शूट पर पैसे खर्च किए बिना पूरी कला एल्बम को एक साथ रख सकते हैं। सभी कार्यों को मुक्त करने के लिए किया जाता है, और परिणाम काफी प्रभावशाली दिखता है - आपको सिर्फ अवधारणा के माध्यम से सोचने और अपने संकेतों को शिल्प करने की आवश्यकता है।
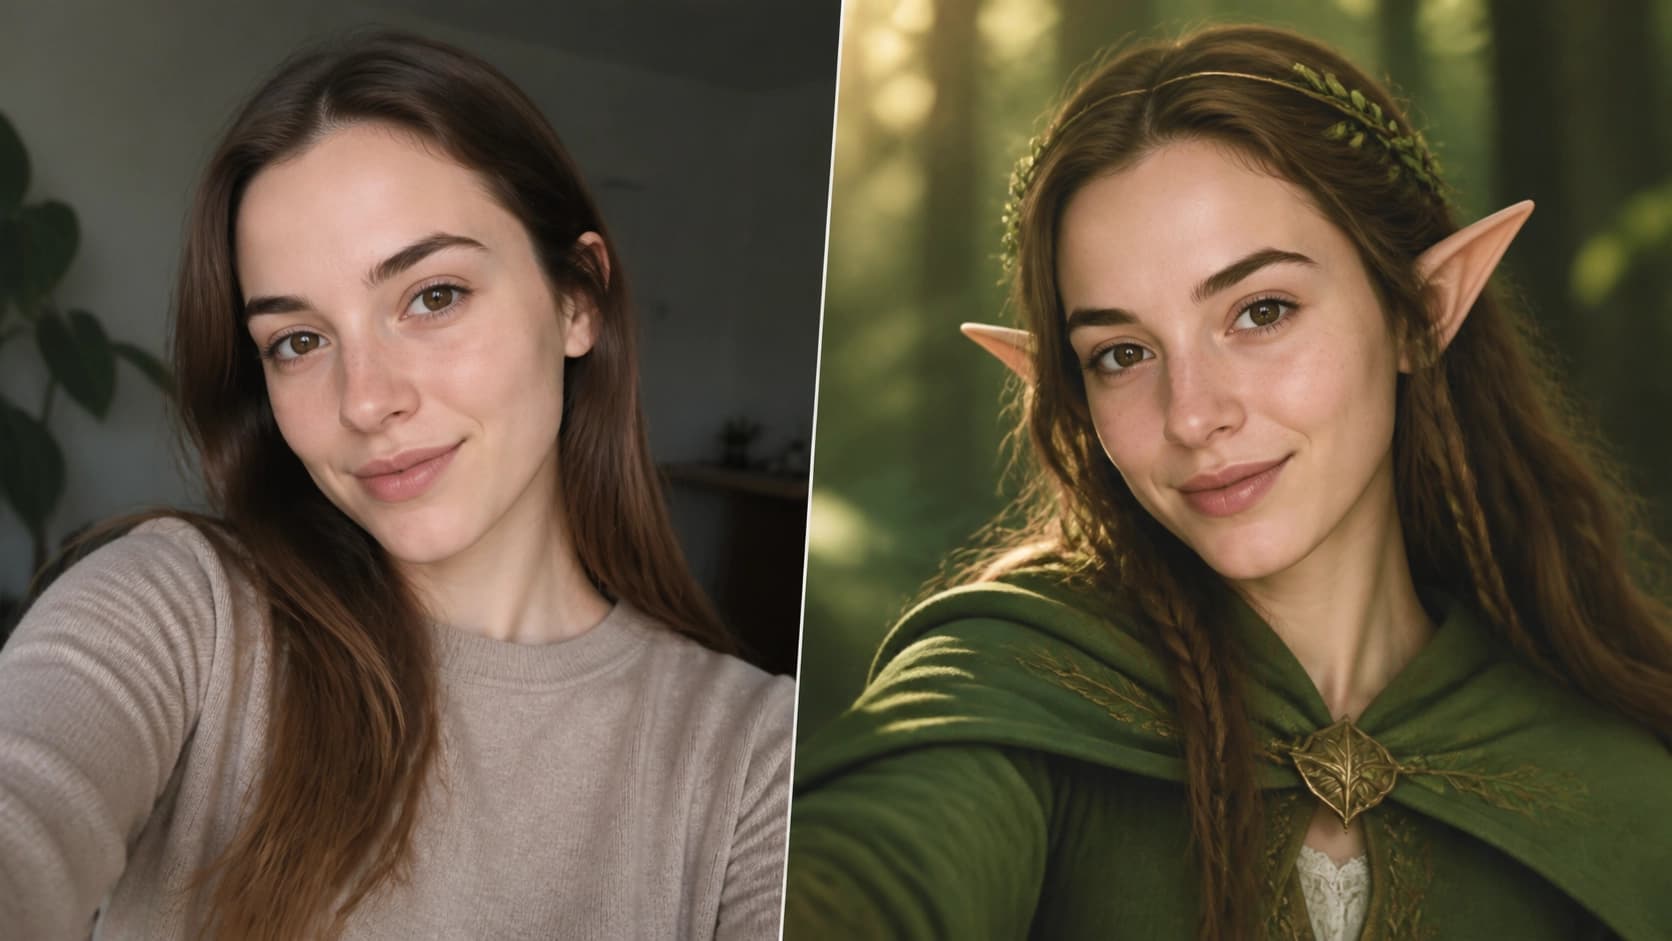
शुरू करने से पहले क्या तैयार किया जाए
आपको शुरू करने के लिए बहुत कम आवश्यकता होगी:
- स्थिर इंटरनेट — छवि अपलोड और प्रसंस्करण बादल में होता है।
- एक एल्बम विचार - विषय के माध्यम से सोचें: काल्पनिक, विज्ञान-फाई, ऐतिहासिक युग, हास्यजनक लग रहा है, या कुछ और।
- एक अच्छा selfie - फोटो तेज होना चाहिए, चेहरे को अच्छी तरह से जला दिया और फ्रेम में तैनात किया जाना चाहिए। बेहतर स्रोत छवि, परिणामों की गुणवत्ता जितनी अधिक होगी।
- संकेत का एक सेट - प्रत्येक चित्र के लिए पाठ विवरण तैयार करना ताकि प्रक्रिया तेज हो जाए।
Google AI स्टूडियो में चरण-दर-चरण प्रक्रिया
पूरी प्रक्रिया कुछ सरल कार्यों के लिए नीचे आती है। चलो उन्हें क्रम में ले जाएँ।
चरण 1: एक सेल्फी लें
आपको एक पेशेवर शॉट की आवश्यकता नहीं है - एक नियमित फोन फोटो पर्याप्त है। मुख्य बात यह है कि चेहरा करीबी है, बिना अतिरिक्त वस्तुओं के इसे कवर किया गया है।
चरण 2: ओपन गूगल एआई स्टूडियो
वेबसाइट पर जाएं [https://a]
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
हाइब्रिड इमेज एनोटेशन: ऑटोमेशन कंप्यूटर विज़न मॉडल्स के प्रशिक्षण को तेज़ करता है
यह लेख बताता है कि एल्गोरिदम द्वारा पूर्व-लेबलिंग मैन्युअल काम को कैसे कम करती है और प्रशिक्षण डेटासेट की गुणवत्ता कैसे बढ़ाती है, साथ ही यह भी कि इंसानों द्वारा नमूना-आधारित सत्यापन अब भी क्यों ज़रूरी है। इसमें कठिन शूटिंग परिस्थितियों और दुर्लभ प्रकार की वस्तुओं के मामले में इस विधि की सीमाओं पर चर्चा की गई है।
5 नवम्बर 2026
डिफ्यूज़न भाषा मॉडल्स को फ़ाइन-ट्यून करने की GoldiMask विधि: संदर्भ चयन और लक्ष्य भारांकन
इस कार्य में GoldiMask प्रस्तुत किया गया है—डिस्क्रीट डिफ्यूज़न वाले भाषा मॉडलों के लिए supervised fine-tuning का एक तरीका, जो सबमॉड्यूलर फ़ंक्शन के लगभग अधिकतमीकरण के ज़रिए दिखाई देने वाले टोकन चुनता है और शेष लक्ष्यों को उनकी प्रशिक्षण उपयोगिता के अनुसार वज़न देता है। कई मॉडलों और डेटासेट पर किए गए प्रयोग औसत सटीकता में वृद्धि, तर्क और प्रोग्रामिंग कार्यों में बेहतर प्रदर्शन, और लगभग समान गुणवत्ता के साथ GSM8K तथा MATH-500 पर समानांतर डिकोडिंग के कम पुनरावृत्ति चरण दर्शाते हैं।
30 अक्टूबर 2026
Transformers ने Apple Silicon पर क्वांटाइज़्ड GGUF मॉडल चलाने की सुविधा जोड़ी
लेख में llama.cpp के GGUF फ़ॉर्मेट को Transformers के साथ एकीकृत करने का वर्णन है: Mac पर स्थानीय इन्फ़रेंस, लाइब्रेरी API के माध्यम से मॉडल लोड करना और OpenAI-संगत सर्वर चलाना। Qwen3.5-4B के उदाहरण से दिखाया गया है कि क्वांटाइज़ेशन स्तर का चुनाव वेट्स के आकार और मेमोरी की आवश्यकताओं को कैसे प्रभावित करता है।
18 अक्टूबर 2026