
हाइब्रिड इमेज एनोटेशन: ऑटोमेशन कंप्यूटर विज़न मॉडल्स के प्रशिक्षण को तेज़ करता है
यह लेख बताता है कि एल्गोरिदम द्वारा पूर्व-लेबलिंग मैन्युअल काम को कैसे कम करती है और प्रशिक्षण डेटासेट की गुणवत्ता कैसे बढ़ाती है, साथ ही यह भी कि इंसानों द्वारा नमूना-आधारित सत्यापन अब भी क्यों ज़रूरी है। इसमें कठिन शूटिंग परिस्थितियों और दुर्लभ प्रकार की वस्तुओं के मामले में इस विधि की सीमाओं पर चर्चा की गई है।
कंप्यूटर विज़न के प्रशिक्षण को मैन्युअल लेबलिंग क्यों सीमित करती है
कंप्यूटर विज़न को लेबल की गई छवियों पर प्रशिक्षित किया जाता है। ऐसी प्रणालियों के विकास में लेबलिंग लंबे समय तक सबसे धीमा हिस्सा रही है। आधुनिक AI मॉडल को अच्छी तरह काम करने के लिए लाखों लेबल की गई छवियों की ज़रूरत होती है।
मैन्युअल काम इस मात्रा के साथ तालमेल नहीं बिठा पाता। इसलिए मॉडल के प्रशिक्षण में लेबलिंग एक अड़चन बन जाती है। मैन्युअल लेबलिंग आधुनिक मॉडलों की ज़रूरतों के मुताबिक बड़े पैमाने पर नहीं की जा सकती।
हाइब्रिड लेबलिंग कैसे काम करती है
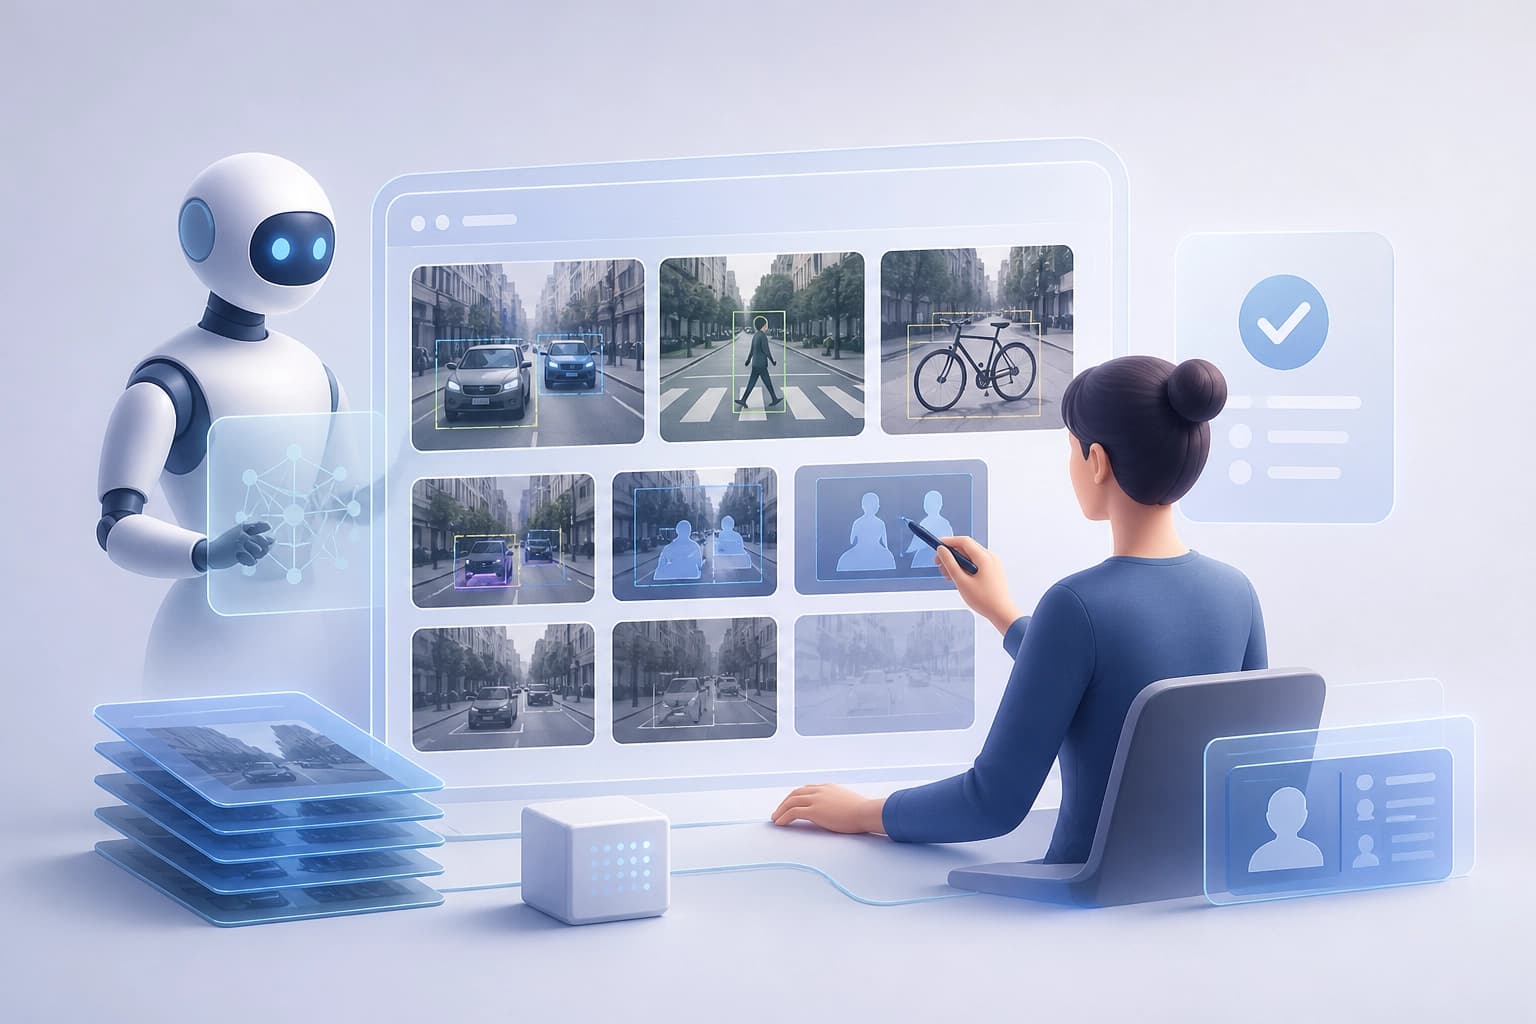
स्वचालित टूल पहले से प्रशिक्षित मॉडलों का उपयोग करते हैं। वे हर पिक्सेल को मैन्युअल रूप से प्रोसेस किए बिना नई छवियों को लेबल करते हैं। इंसान शुरुआत से लेबलिंग करने के बजाय नतीजे की जाँच करता है और उसे ठीक करता है।
हाइब्रिड लेबलिंग के चरण:
- पहले से प्रशिक्षित मॉडल के आधार पर स्वचालित प्रारंभिक लेबलिंग।
- इंसान द्वारा नतीजे की जाँच और सुधार।
हाइब्रिड तरीका स्वचालन की गति और गुणवत्ता नियंत्रण को जोड़ता है।
लेबलिंग का स्वचालन किन कार्यों को पूरा करता है
स्वचालन कई तरह की लेबलिंग करता है। कार्यों की सूची:
- ऑब्जेक्ट का पता लगाना और बाउंडिंग बॉक्स बनाना;
- सिमेंटिक सेगमेंटेशन;
- इंस्टेंस सेगमेंटेशन;
- छवियों का वर्गीकरण;
- मुख्य बिंदुओं और मुद्राओं का आकलन;
- वीडियो फ़्रेम की लेबलिंग।
स्वचालन कंप्यूटर विज़न के मुख्य कार्यों को कवर करता है।
मैन्युअल लेबलिंग की तुलना में हाइब्रिड तरीके के क्या फायदे हैं
| मानदंड | केवल मैन्युअल | हाइब्रिड तरीका |
|---|---|---|
| लेबलिंग में लगने वाला समय | तुलना के लिए आधार | समय लगभग 40% तक घट सकता है |
| त्रुटियों की दर | हाइब्रिड तरीके की तुलना में 25% तक अधिक हो सकती है | त्रुटियों की दर कम |
| डेटासेट का विस्तार | लेबलिंग करने वालों की संख्या को उसी अनुपात में बढ़ाना पड़ता है | कर्मचारियों की संख्या को उसी अनुपात में बढ़ाए बिना डेटासेट का विस्तार संभव |
हाइब्रिड तरीका तेज़, अधिक सटीक और बड़े पैमाने पर लागू करना आसान है।
स्वचालित लेबलिंग का उपयोग कहाँ होता है
स्वचालित लेबलिंग का उपयोग इन क्षेत्रों में होता है:
- स्वायत्त वाहन;
- मेडिकल इमेजिंग;
- खुदरा व्यापार और ई-कॉमर्स;
- कृषि और विनिर्माण।
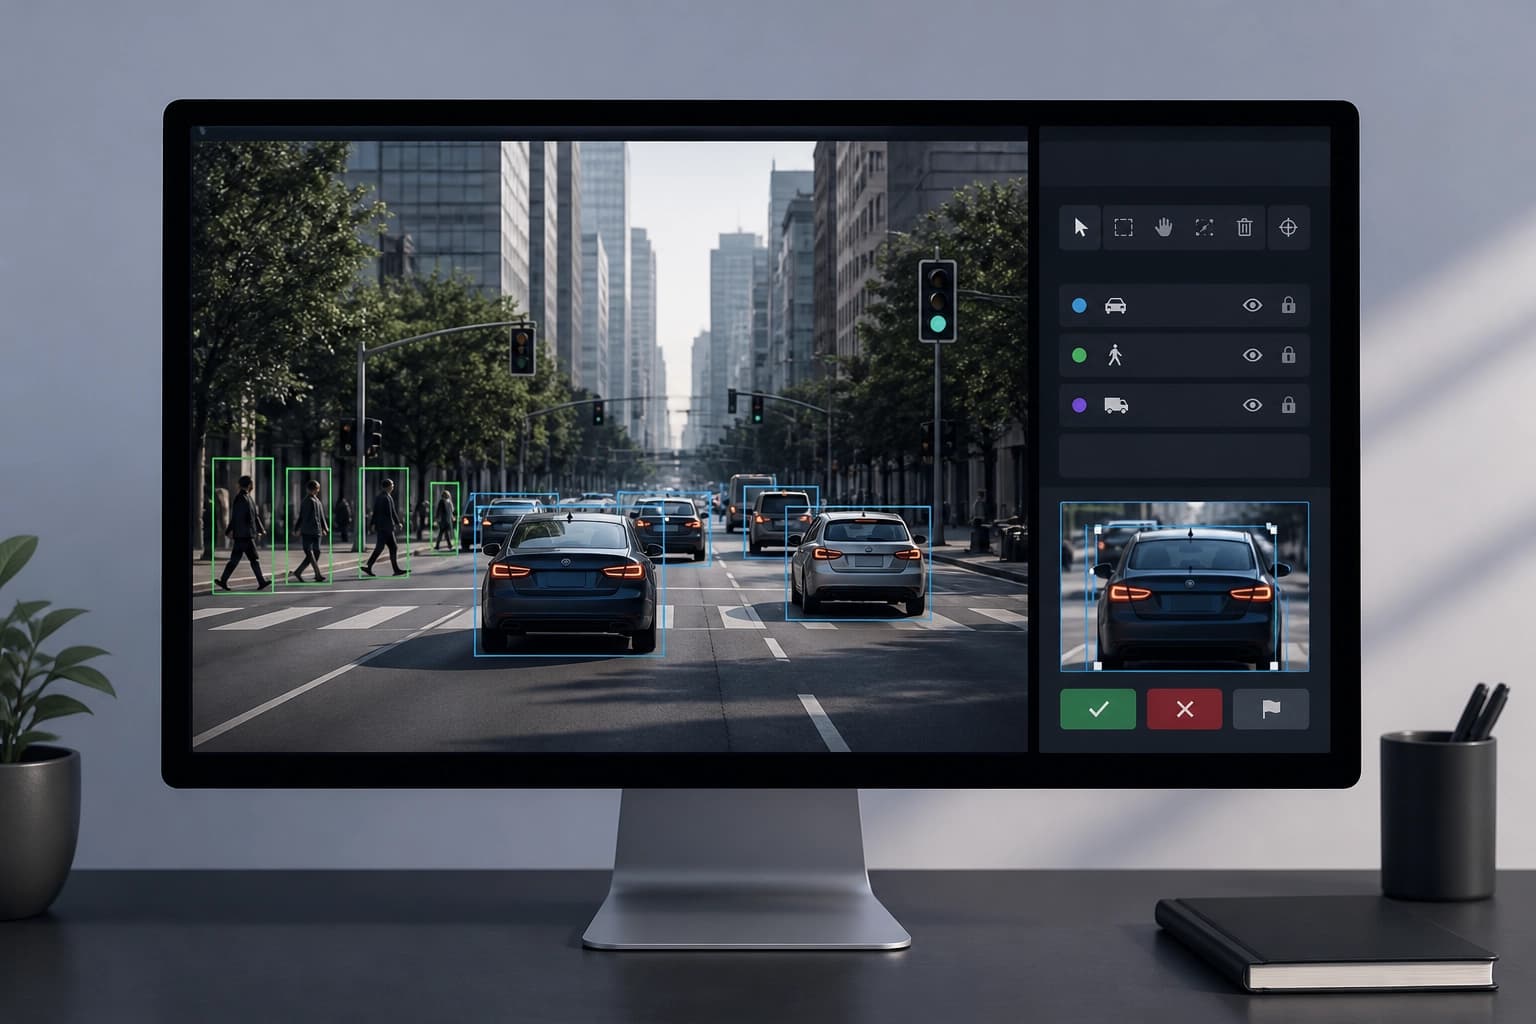
उच्च जोखिम वाले उद्योगों में लेबलिंग की गुणवत्ता विशेष रूप से महत्वपूर्ण होती है। पैदल यात्रियों से जुड़े डेटा में त्रुटियाँ स्वायत्त वाहनों की सुरक्षा के लिए जोखिम पैदा करती हैं। ट्यूमर की सीमाओं की असंगत लेबलिंग के कारण मेडिकल मॉडल निदान में चूक सकता है।
स्वचालित लेबलिंग की सीमाएँ
असामान्य रोशनी, ऑब्जेक्ट के एक-दूसरे को ढकने, ऑब्जेक्ट की दुर्लभ श्रेणियों और असामान्य परिस्थितियों में स्वचालित प्रणालियाँ अब भी गलतियाँ कर सकती हैं। प्रशिक्षण डेटा का पूर्वाग्रह स्वचालित लेबलिंग में भी आ सकता है।
इसलिए स्वचालन को शुरुआती चरण के रूप में देखा जाता है। इंसान द्वारा जाँच जारी रहती है, खासकर स्वास्थ्य सेवा में। जहाँ गलती की कीमत अधिक होती है, वहाँ हाइब्रिड तरीका अनिवार्य है।
लेबलिंग का तरीका चुनने के लिए व्यावहारिक मानदंड
चुनने के मानदंड:
- गलती की अधिक कीमत (सुरक्षा, चिकित्सा) के लिए इंसान द्वारा जाँच ज़रूरी है।
- लेबलिंग करने वालों की संख्या को उसी अनुपात में बढ़ाए बिना डेटा की मात्रा बढ़ाने के लिए स्वचालित प्री-लेबलिंग की जाती है।
- छोटी कंपनियों के लिए क्लाउड लेबलिंग सेवाएँ और ओपन-सोर्स मॉडल प्रवेश की बाधा कम करते हैं।
लेबलिंग का तरीका गलती की कीमत और विस्तार की ज़रूरत के आधार पर चुना जाता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
पंद्रह कंपनियों ने माइनिंग के स्वचालन के लिए MDK Tether का समर्थन किया
उपकरण निर्माताओं, पूलों और ऑपरेटरों ने उपकरणों की निगरानी और प्रबंधन को एकीकृत करने के लिए Tether के ओपन स्टैक के साथ इंटीग्रेशन विकसित करने की जिम्मेदारी ली है; AI एजेंट QVAC पहले से ही इसी आधार पर काम कर रहा है। बिजली की लागत में कमी या दक्षता में वृद्धि की स्वतंत्र पुष्टि अभी तक प्रकाशित नहीं हुई है।
2 नवम्बर 2026
अलग-अलग ऑप्टिमाइज़र की जगह एजेंट: एकीकृत ढाँचा, जो एक साथ कई कार्यों पर विकसित होता है
लेखक दिखाते हैं कि अपरिवर्तित रैपर के एक ही संस्करण पर आधारित एक स्थिर मॉडल पहले समस्याएँ हल करता है, फिर पूर्ण रन लॉग के आधार पर अपने कोड को स्वयं संपादित करता है। 49 पंक्तियों वाले फ्रेमवर्क के बहु-कार्य विकास से वितरण के भीतर और अलग रखे गए बेंचमार्क पर परिणाम बेहतर हुए, और उनमें से कुछ पर Codex को पीछे छोड़ दिया।
29 अक्टूबर 2026
LLM के युग्मित संवाद: मौजूदा विचारों से सहमति, नई मान्यताएँ थोपने की तुलना में, कट्टरपंथ को अधिक बढ़ाती है
प्रीप्रिंट arXiv:2609.38296 के लेखकों ने एक ऐसे लक्ष्य मॉडल और इन्फ्लुएंसर एजेंट के बीच हुई बातचीत का मॉडल तैयार किया, जिसमें लक्ष्य मॉडल एक मानवीय व्यक्तित्व की भूमिका निभाता है और एजेंट उसके रुझानों को चरम ध्रुव की ओर मोड़ने की कोशिश करता है। दोनों ही परिदृश्यों—पहले से मौजूद राय को मजबूत करना और पहले गौण रही राय को बढ़ावा देना—से भावात्मक और व्यवहारगत पैमानों पर बदलाव आया, हालांकि पहला परिदृश्य अधिक लगातार प्रभावी रहा।
27 अक्टूबर 2026