Problème : des signaux différents se périment à des vitesses différentes
Les systèmes de recommandation multimodaux ont depuis longtemps cessé de s'appuyer uniquement sur l'historique des clics. Ils intègrent aux interactions « utilisateur — objet » le contenu de l'objet lui-même : description, image, son. La logique est simple : plus il y a de canaux d'information, plus la prédiction est précise. En pratique, c'est plus complexe : la contribution de chaque canal n'est pas constante, elle évolue dans le temps, et ce à sa propre vitesse.
Les auteurs du travail arXiv:2608.10983 (Pengyu Zhang, Yangqin Jiang, Klim Zaporojets, Congfeng Cao, Paul Groth ; première version — 11 août 2026, deuxième — 24 août) appellent cela modality time-scale mismatch — le décalage des échelles temporelles des modalités. Leur exemple : à l'approche de la Saint-Valentin, au moment de choisir un chocolat, les gens lisent moins la composition et regardent davantage l'emballage et l'accompagnement sonore de la fiche. Les traits textuels perdent du poids, les traits visuels et audio en gagnent. Deux semaines plus tard, la proportion change à nouveau.
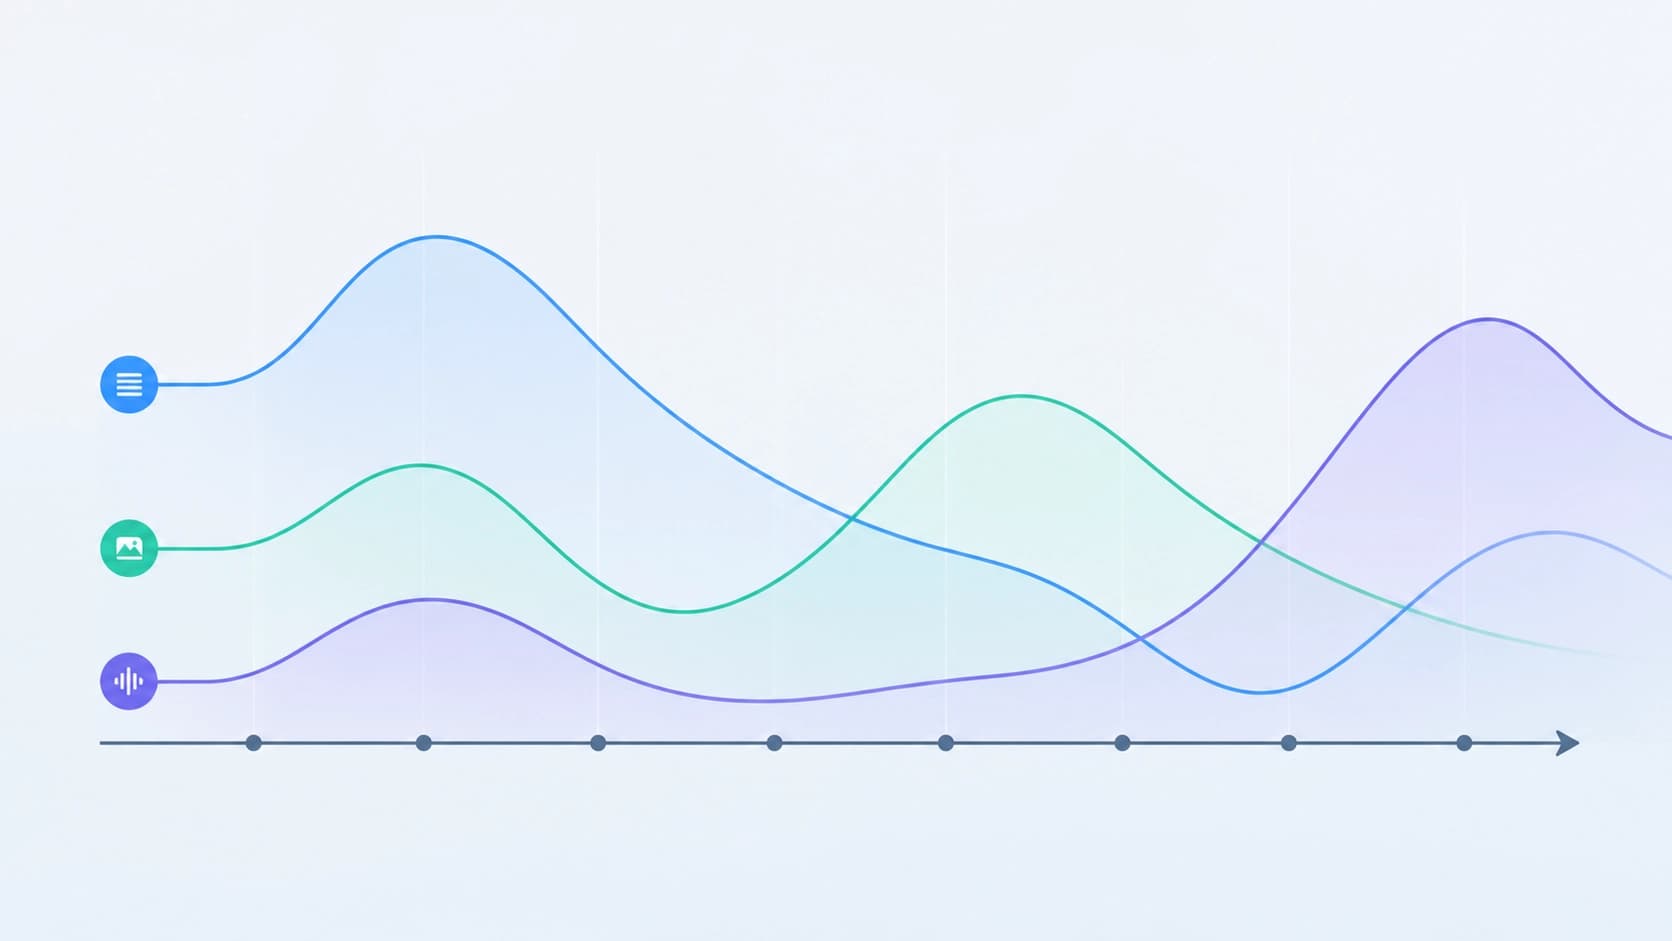
De cette observation découlent deux problèmes distincts. Le premier : les gens ont des rythmes de comportement différents, et un utilisateur a besoin d'une proportion de modalités, un autre d'une toute autre. Le second, moins évident : une modalité devenue obsolète ne cesse pas simplement d'aider — elle commence activement à nuire, en injectant dans le modèle des signaux périmés et trompeurs.
TimeRoute : un routage propre à chaque utilisateur
La solution aux deux problèmes est réunie dans une seule architecture diffusionnelle — TimeRoute. Son sens réside dans le rejet des coefficients de fusion universels qui ont été la norme pendant des années : soi-disant, le texte pèse toujours 0,4, l'image — 0,35, le reste — des broutilles.
Une distribution personnelle au lieu de poids communs
L'élément clé est le routeur temporel de modalités. Il agrège le comportement d'un utilisateur donné en un profil temporel compact et le transforme en une distribution personnelle de poids par modalité. Autrement dit, la question « sur quoi faut-il se concentrer en priorité ici » n'est pas résolue globalement pour tout le système, mais séparément pour chaque profil de comportement temporel.
Deux horizons de débruitage
La deuxième partie est le reconstructeur diffusionnel de graphe. Le même profil temporel y est injecté via Feature-wise Linear Modulation (FiLM), et le débruitage est scindé en deux flux de têtes : long terme et court terme. Les tendances lentes et les pics rapides sont traités par des branches différentes, et c'est fondamental — les mélanger dans un seul canal revient à perdre précisément la distinction pour laquelle tout a été entrepris.
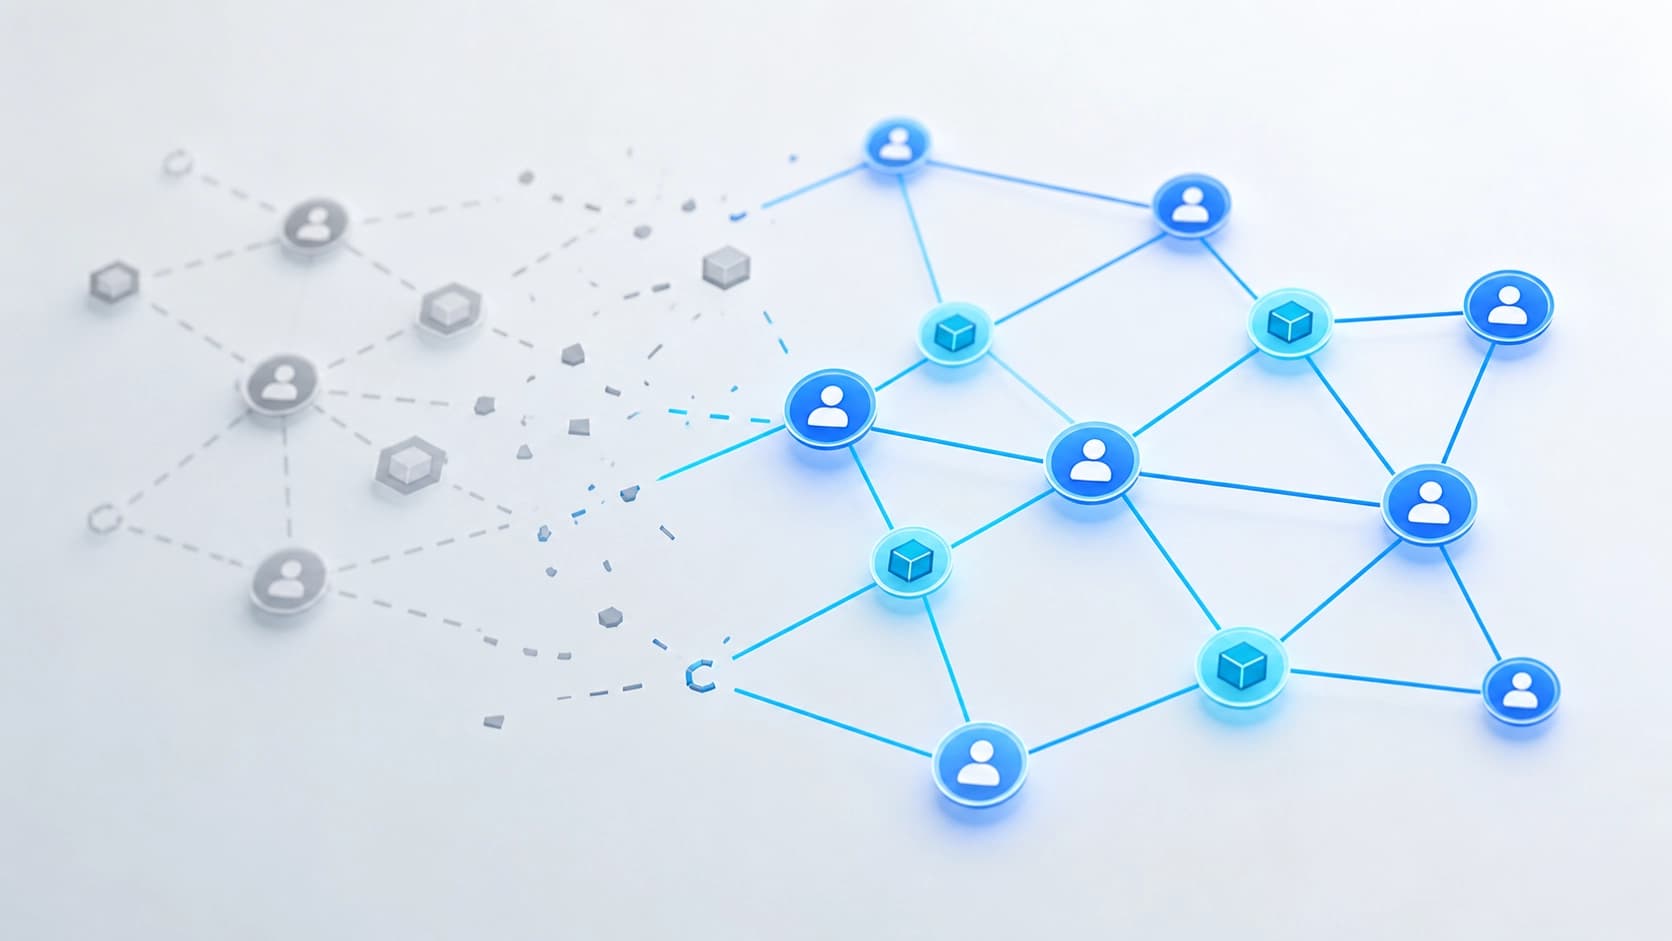
Pourquoi la diffusion est-elle nécessaire ici précisément ? Elle permet de filtrer les arêtes modales avant qu'elles n'entrent dans le graphe de propagation. Un lien périmé n'est pas affaibli a posteriori — il n'est pas construit du tout. C'est une approche fondamentalement différente de la pondération d'un graphe déjà prêt.
Expériences : trois jeux de données, dix exécutions
Les auteurs ont testé le système sur trois ensembles de données — des vidéos courtes de TikTok, Amazon-Baby et Amazon-Sports. Chaque résultat est moyenné sur dix initialisations aléatoires, ce qui est assez rigoureux pour les benchmarks de recommandation : la dispersion entre les exécutions y engloutit généralement la moitié du gain.
Les améliorations par rapport à de solides modèles de référence sont stables selon Recall@K, Precision@K et NDCG@K. Le résultat le plus marquant enregistré est une hausse allant jusqu'à 9,8 % selon P@20 sur Amazon-Baby. Il est important de noter que le gain n'est pas ponctuel et n'est pas lié à une seule métrique : il se manifeste sur tout l'ensemble des mesures.
Attribution : vérifier les mécanismes, pas seulement les chiffres
Une partie distincte du travail est constituée d'études d'attribution contrôlées. C'est une tentative de répondre à une question qui reste souvent dans l'ombre : qu'est-ce qui a précisément produit le gain — l'idée proposée ou une coïncidence fortuite dans l'architecture ?
Les conclusions se sont révélées sévères. Les améliorations exigent simultanément de nouveaux mécanismes et une entrée temporelle. Si l'on fournit le même profil temporel à un backbone ordinaire, sans modifier la procédure de routage, il n'y aura pas de gain. Et si l'on glisse un bruit aléatoire au routeur, le résultat ne sera pas meilleur qu'avec la suppression complète du routeur du modèle.
Autrement dit, ce n'est pas le simple fait de disposer de données temporelles dans le système qui fonctionne, mais la combinaison précise « profil → distribution des modalités → reconstruction par débruitage contrôlée ». Retirez n'importe quel élément — la construction s'effondre.
Ce que cela signifie en pratique
L'idée principale du travail dépasse le cadre des recommandations. La multimodalité est généralement perçue comme une accumulation : on a ajouté une source de données supplémentaire — c'est devenu meilleur. TimeRoute rappelle que les sources sont en concurrence entre elles, et que leur rapport est une grandeur aussi ajustable que n'importe quels poids du modèle.
La deuxième conclusion pratique concerne l'obsolescence. Dans les systèmes de recommandation, il est d'usage de lutter contre les signaux anciens au niveau des préférences utilisateur — recalculer l'historique, oublier les clics lointains. Ici, le même problème est élevé au niveau des modalités : ce qui peut se périmer, ce n'est pas le goût d'une personne, mais la pertinence de tout un canal d'information. Et il est plus logique de lutter contre cela à l'entrée du graphe, plutôt qu'après que les déchets se sont déjà répandus dans toute la structure.
Le troisième point est la personnalisation de la distribution. L'idée que les proportions de modalités doivent être dérivées du profil temporel d'une personne donnée, plutôt que définies une fois pour toute la plateforme, semble transférable. Le même principe est applicable là où convergent des signaux hétérogènes : la recherche, le classement du fil d'actualité, les catalogues mixtes par type de contenu. Les auteurs ont ouvert le code, il est donc tout à fait possible de tester l'approche sur ses propres données.