Le budget qui part toujours en images fraîches
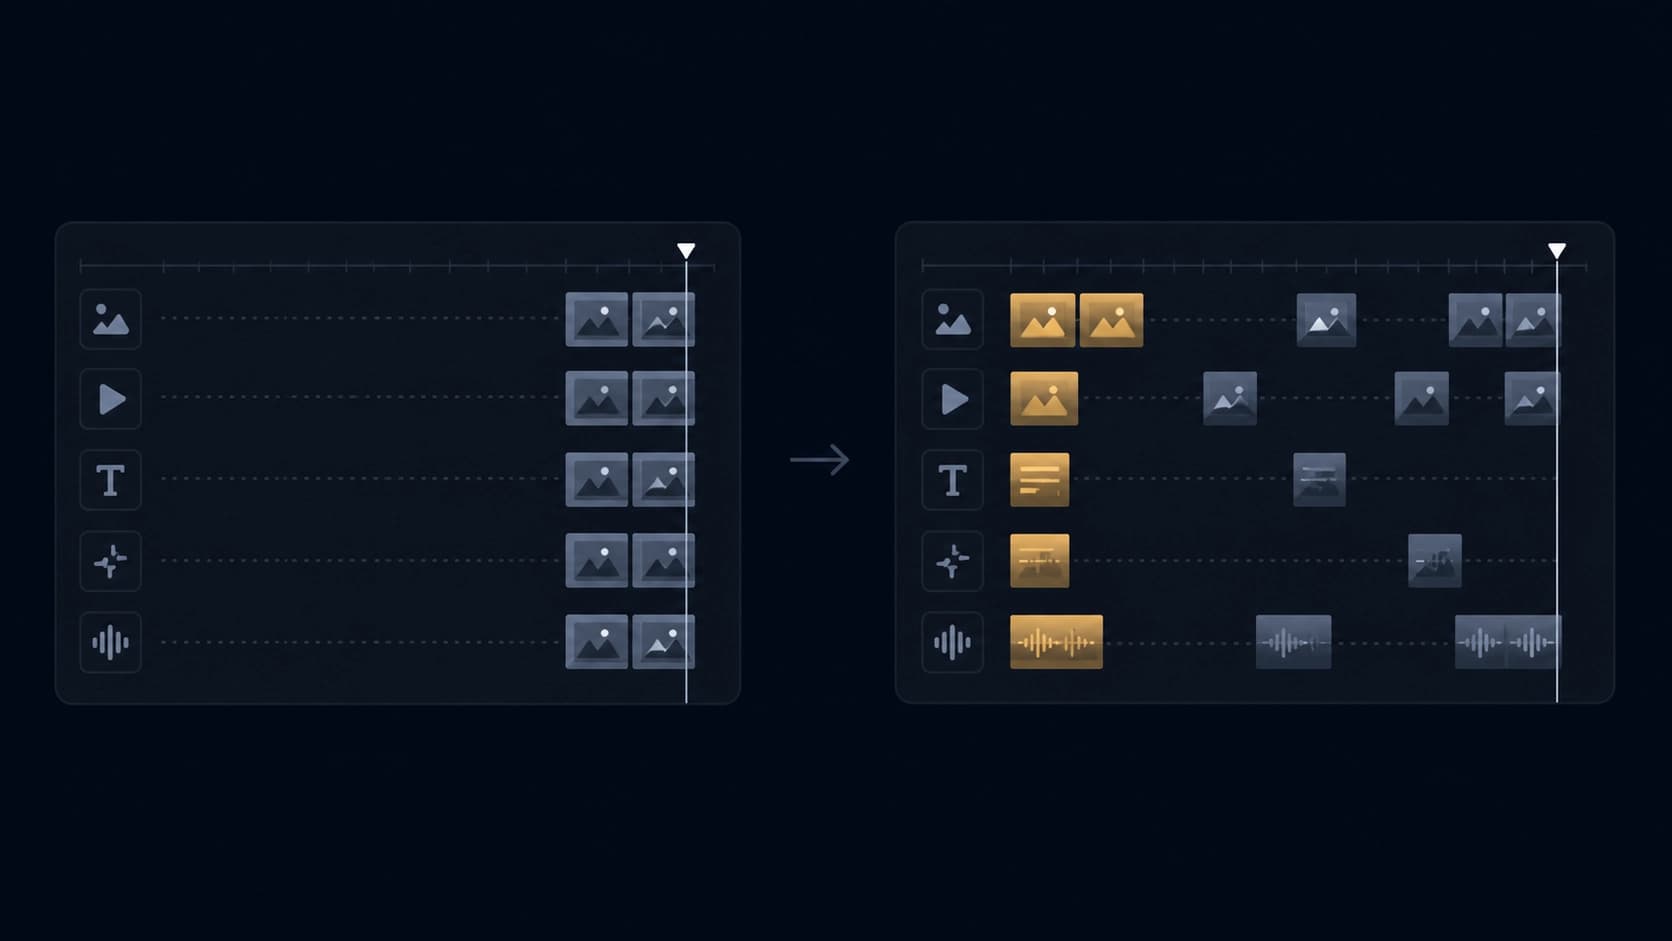
Un agent GUI à longue durée de vie est conçu comme une créature ayant une mauvaise mémoire des images. Il peut traîner derrière lui un historique textuel d'actions presque indéfiniment — la summarisation pèse peu. Mais les captures d'écran coûtent cher : seule une poignée d'images tient dans la fenêtre active du modèle. D'où le problème que les auteurs appellent budgeted fidelity restoration. Chaque événement subsiste sous forme de description compressée, mais un budget fixe B décide quels événements précis récupéreront leurs pixels archivés.
La variante de base Recent-B répond à cette question de la manière la plus simple : tous les emplacements visuels sont attribués aux événements les plus récents. La logique « plus c'est récent, plus c'est utile » semble naturelle, mais elle a un angle mort — elle ne vérifie jamais si l'écran récent est réellement plus important que celui d'il y a vingt étapes. Parfois, l'utilisateur est passé à une autre fenêtre, y a réglé quelque chose, est revenu — et l'essentiel pour l'action suivante est resté loin dans l'historique.
Un autre principe de sélection
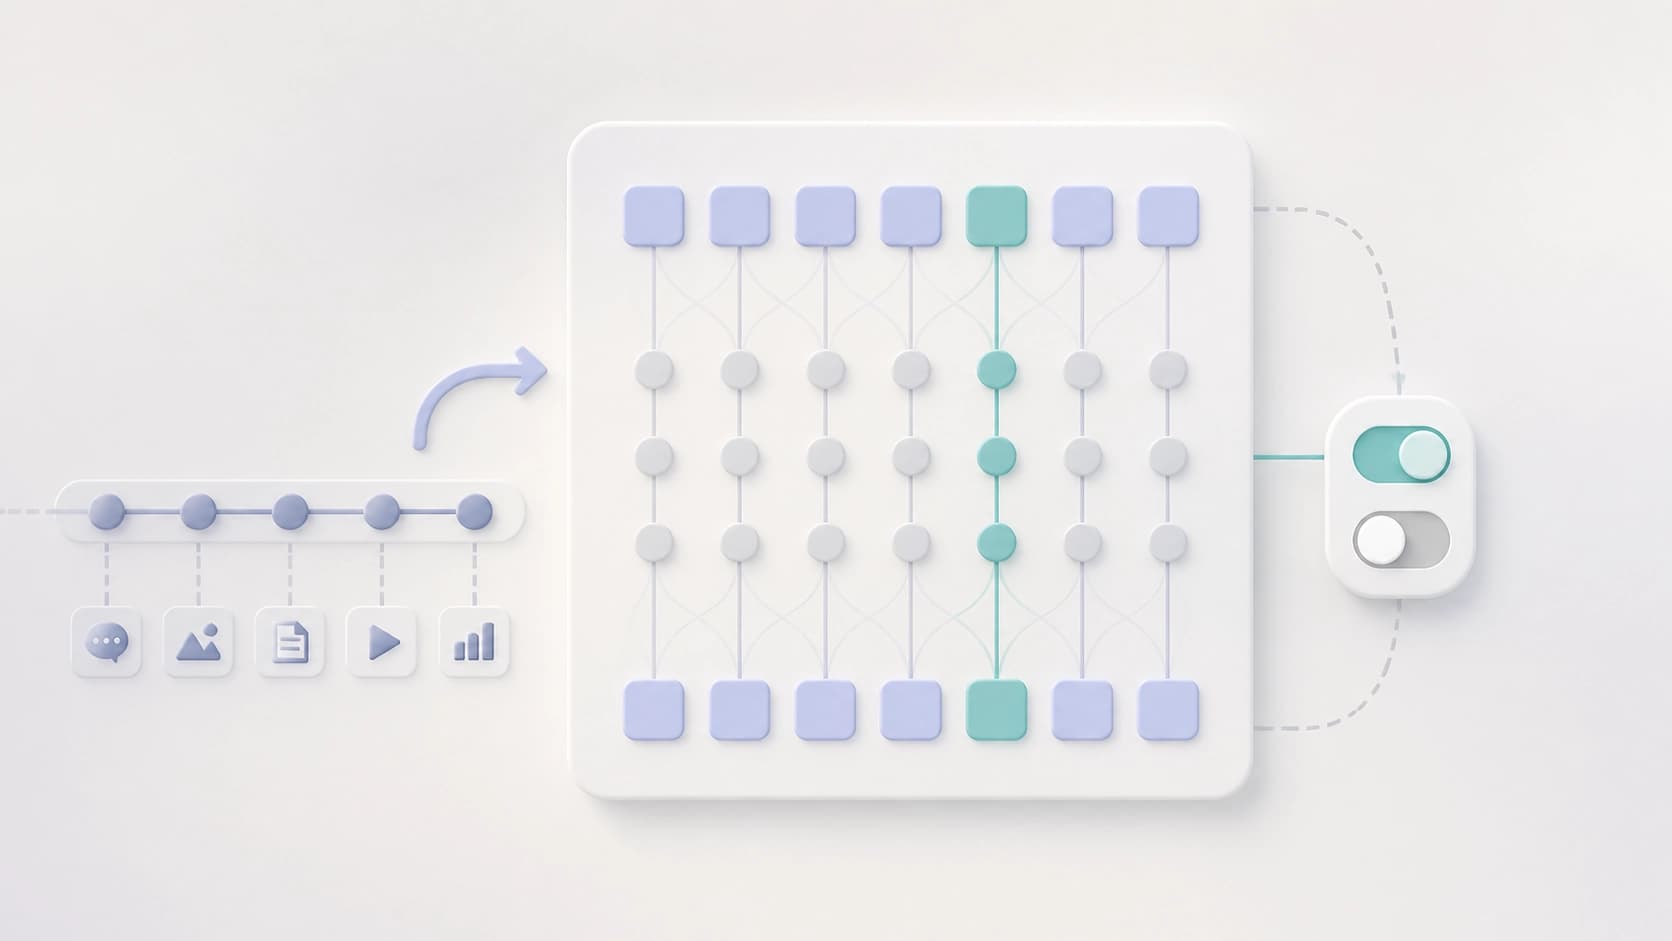
CausalCache — méthode décrite dans les travaux arXiv:2608.22577 (Jiaxuan Luo, Zhanfeng Liao, Jiayao Teng, Yuan Wang ; v1 du 23 août 2026, mise à jour v2 du 25 août, neuf pages et quatre figures). Au lieu de la règle « tout aux derniers », il évalue l'historique dans son ensemble et substitue un événement plus ancien précisément lorsque son utilité prédite dépasse celle du candidat récent. La question n'est pas « que s'est-il passé à l'instant », mais « qu'est-ce qui sera utile à l'étape suivante ».
Un adaptateur qui sait rester à sa place
La seconde moitié de la construction — un adaptateur clé/valeur history-gated. Il ne touche qu'aux tokens des images historiques restaurées et se désactive complètement lorsqu'aucune de ces images n'est présente dans le contexte. C'est un détail important : le traitement de l'écran actuel ne se dégrade pas du fait que le système sait en principe récupérer d'anciennes images.
Le sélecteur et l'adaptateur sont entraînés avec des interventions à budget apparié — matched-budget interventions — sur des trajectoires de bureau, puis testés en zero-shot sur mobile, c'est-à-dire sans aucun réglage spécifique à la nouvelle plateforme.
Ce que les mesures ont montré
Bureau : un gain réel, mais pas immédiat
Sur OSWorld-Verified, l'activation des captures d'écran historiques augmente le taux de réussite d'environ 13 points de pourcentage par rapport à une mémoire ne contenant que des summarisations textuelles. Cela semble impressionnant, mais les nuances commencent ensuite.
Avec la limite officielle de 15 étapes, CausalCache et le simple Recent-4 sont statistiquement indiscernables. Autrement dit, sur les épisodes courts, toute l'entreprise ne vaut pas la peine : l'historique n'a tout simplement pas le temps d'accumuler quoi que ce soit de précieux, et la sélection avide de nouveauté fait tout aussi bien. En revanche, dans le diagnostic à 30 étapes, l'écart apparaît — 46,7 % contre 42,4 %, soit un gain de 4,3 points.
Mobile : un transfert sans réentraînement
Le zero-shot sur 117 tâches MobileWorld donne 36,8 % contre 30,2 % pour Recent-4. La méthode, entraînée sur des trajectoires de bureau, gagne aussi sur téléphone — c'est précisément le résultat qui indique qu'il ne s'agit pas d'un ajustement à une interface particulière.
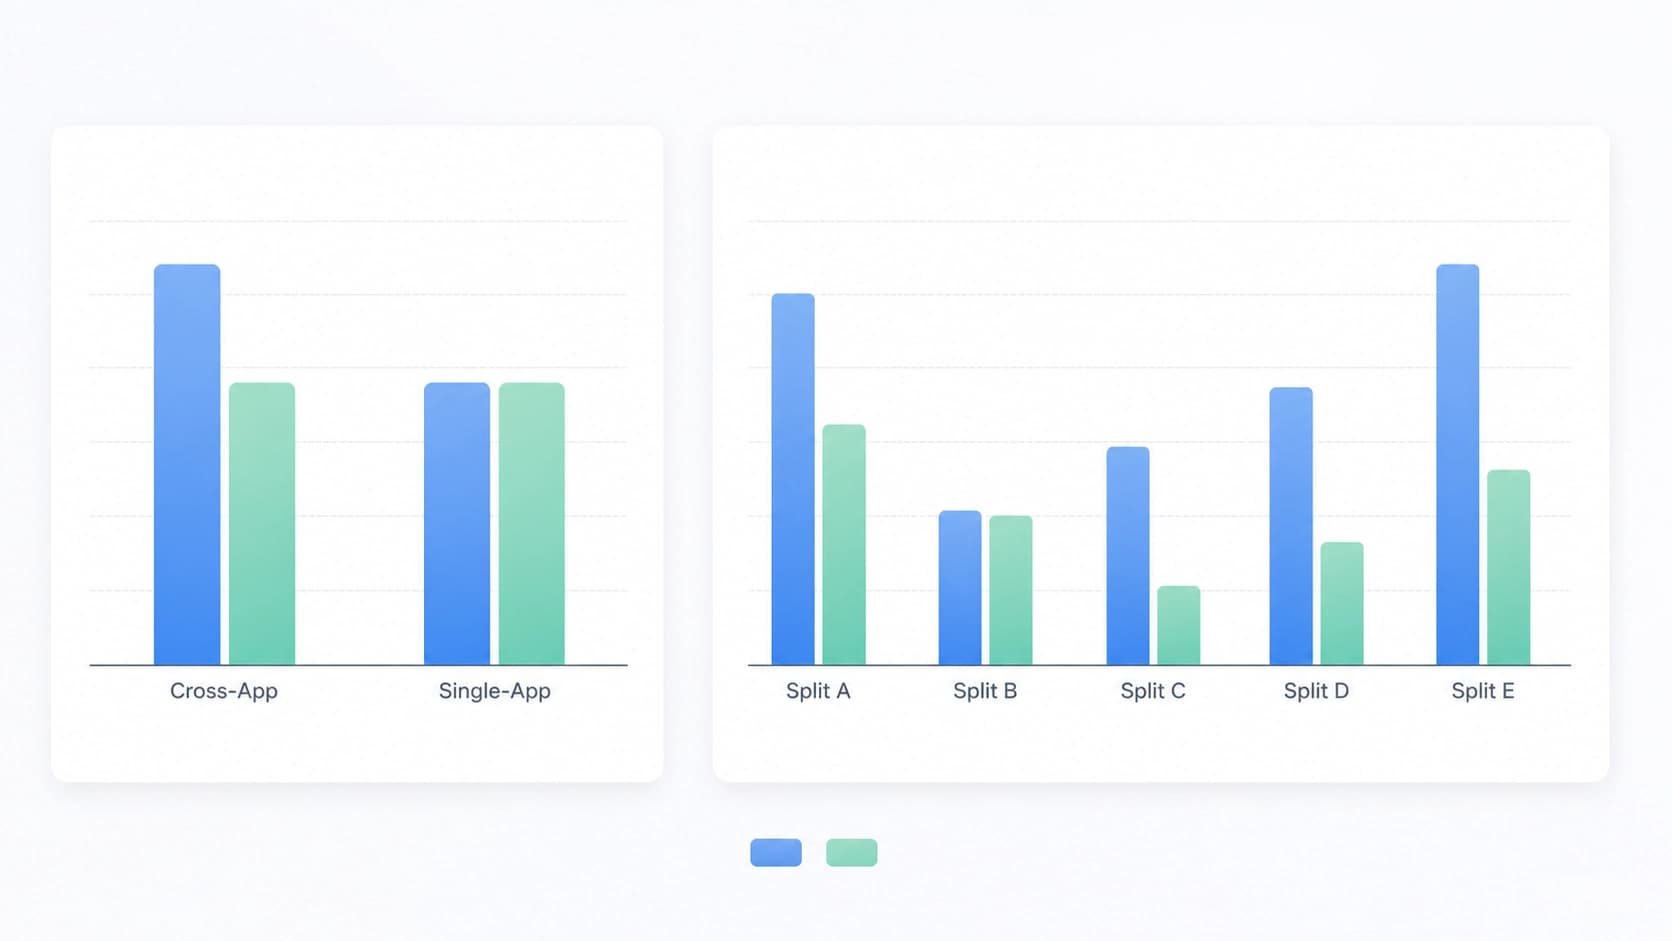
Plus intéressant encore : où se loge exactement le gain. Il se concentre sur le split prédéfini cross-app memory-candidate : 30,6 % contre 19,4 %, soit +11,2 points. Dans les contrôles single-app, aucune différence n'a été trouvée — 43,6 % contre 42,4 %. Le tableau est cohérent : l'avantage se manifeste là où la tâche exige de se souvenir de l'état d'une application tout en agissant dans une autre.
Ce qu'il faut en retenir
La formulation des auteurs est la suivante : choisir à quels événements passés restituer leurs pixels est plus efficace que de consacrer entièrement un budget visuel fixe à la récence. Difficile de contester cela après que le gain s'est révélé concentré précisément dans les tâches impliquant un basculement entre applications.
Mais une interprétation honnête exige deux réserves. Premièrement : sur les horizons courts, il n'y a pas de différence, ce qui signifie que la méthode n'est pas une amélioration gratuite, mais un pari sur les épisodes longs, où l'historique accumulé a réellement un sens. Deuxièmement : l'absence de différence dans les contrôles single-app implique que la sélection par utilité n'est pas universelle — elle résout une classe précise de problèmes, où l'agent doit ramener dans le contexte un écran depuis longtemps disparu.
Conclusion pratique pour ceux qui construisent des agents : la récence est un critère commode, mais pas le seul. Dès que le budget d'images devient un goulot d'étranglement, il vaut la peine de se demander ce que vous y placez exactement — les dernières images par inertie, ou celles qui seront réellement utiles à l'étape suivante.