
La science moléculaire est depuis longtemps considérée comme l'un des domaines les plus prometteurs — et les plus complexes — pour l'IA. C'est précisément à elle qu'est consacré le préprint arXiv:2608.23104 « Molecular LLM Agents: From Architectural Design to Scientific Autonomy » : 25 pages, catégories cs.CL et cs.AI, version v1 du 24 août 2026 et version v2 affinée du 25 août. Le collectif d'auteurs — Jiatong Li, Wengyu Zhang, Weida Wang, Yuxuan Ren, Wei Liu, Chenyang Mao, Yuqiang Li, Yatao Bian, Changmeng Zheng, Xiaoyong Wei et Qing Li. Ce travail est intéressant non pas pour un nouveau record sur un benchmark, mais pour sa tentative de mettre de l'ordre dans les termes : qu'est-ce qui constitue réellement un agent moléculaire, à partir de quels nœuds il s'assemble et dans quelle mesure il peut agir de façon autonome.
En quoi un agent moléculaire diffère d'un agent « ordinaire »
Les assistants conversationnels et les agents de code vivent dans un monde de texte, de dépôts et de pages web. Les outils qu'ils manipulent acceptent et renvoient presque toujours quelque chose qui peut se lire à l'œil nu. Avec la chimie, ce tour de passe-passe ne fonctionne pas : une molécule n'est pas un paragraphe.
Un agent de domaine doit composer avec plusieurs types de données incompatibles à la fois :
- les notations symboliques comme les SMILES — des chaînes compactes où un seul caractère erroné transforme un candidat médicament en une autre substance ;
- les graphes moléculaires, où comptent non seulement les atomes, mais aussi l'ordre des liaisons, les charges, la stéréochimie ;
- les conformations tridimensionnelles — car les propriétés d'une molécule sont déterminées par sa forme, et pas seulement par sa formule ;
- les spectres et les résultats de simulations — de longues séries numériques dont il faut extraire le sens ;
- les mesures issues du laboratoire « humide », c'est-à-dire les données d'expériences réelles sur une substance, et non sur un fichier.
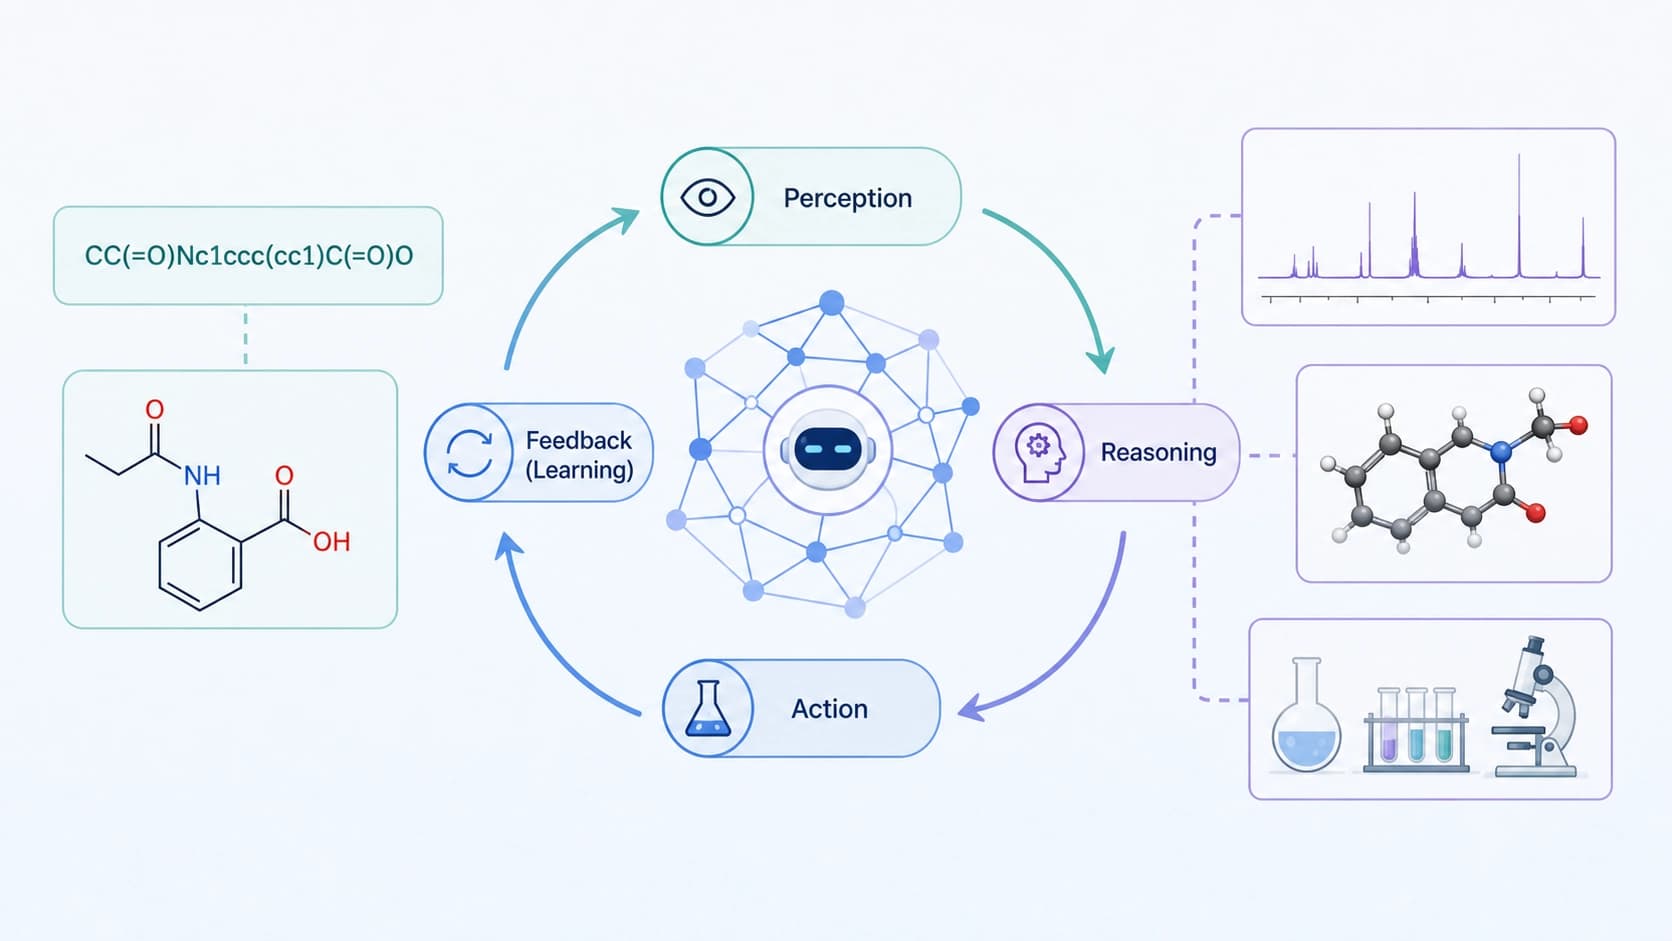
D'où l'idée principale des auteurs : les capacités d'un tel agent ne se composent pas d'un seul modèle réussi, mais de plusieurs piliers à la fois. Il faut une perception chimiquement correcte des objets moléculaires, un framework agentique avec un modèle de langage au centre, des outils liés à un domaine précis, ainsi qu'un canal de rétroaction — computationnel ou expérimental. Par-dessus vient s'ajouter la capacité à planifier et à invoquer l'outil adéquat au bon moment.
Regard architectural : de quoi est fait un agent moléculaire
La première des deux perspectives de l'article est ingénieriale. Les auteurs décomposent la construction en quatre couches et proposent d'examiner tout projet existant précisément ainsi.
Perception : la molécule comme objet, non comme paragraphe
Les modèles de langage sont entraînés sur du texte, c'est pourquoi une chaîne SMILES leur apparaît d'abord comme un ensemble de tokens et ils « hallucinent » facilement des valences inexistantes. C'est là qu'aide le couplage avec des modèles de domaine : par exemple, AlphaFold montre comment une architecture spécialisée résout une tâche moléculaire étroite plus précisément qu'une architecture universelle. Pour un agent, cela signifie une chose simple : avant de raisonner, il doit savoir valider — vérifier si la molécule existe réellement, si son graphe correspond à la formule, si la stéréochimie ne s'est pas perdue lors du passage entre formats.
Framework, boîtes à outils et apprentissage
Les deuxième et troisième couches sont le « cerveau » et les « mains ». Le modèle de langage planifie et décide quel calcul lancer ; la boîte à outils de domaine lui fournit le docking, le calcul de chimie quantique, la recherche dans les bases, la prédiction de propriétés. Un bon exemple de cette approche est l'agent ChemCrow : la valeur y est créée non par le modèle lui-même, mais par les outils soigneusement décrits qu'il invoque.
La quatrième couche est l'apprentissage et l'optimisation. On peut affiner l'agent sur des trajectoires de solutions réussies, ou simplement améliorer la description des outils et la stratégie de leur sélection. La seconde voie est moins coûteuse, et les auteurs font clairement comprendre : la moitié des échecs dans ce domaine ne tiennent pas à un modèle faible, mais à une boucle de rétroaction mal conçue.
L'échelle de l'autonomie scientifique : L1–L4
La seconde perspective de l'article est cette fameuse « échelle de l'autonomie », empruntée à la logique des niveaux dans les systèmes d'ingénierie. Elle sert à ne pas débattre abstraitement de savoir « si l'agent est intelligent », mais à comprendre combien de décisions il prend réellement à sa charge.
L1 — assistant à scénario fixe
Ici, l'humain définit la séquence des étapes, et le modèle exécute des opérations isolées : traduire une structure, calculer des descripteurs, proposer des variantes. L'autonomie est quasi nulle, mais la prévisibilité est maximale.
L2 — agent computationnel adaptatif
L'agent décide lui-même quel outil invoquer et dans quel ordre, replanifie en cas d'erreur, travaille dans une boucle entièrement numérique. C'est le courant dominant actuel : le risque se limite à un calcul raté, et non à un échantillon raté.
L3 — agent prenant en compte les résultats d'expériences réelles
Le niveau le plus intéressant et le plus risqué. L'agent ne se contente pas de planifier : il reçoit aussi une rétroaction du laboratoire physique — spectres, chromatogrammes, données de synthèse — et ajuste son plan en fonction. Des exemples de systèmes de cette classe existent : Coscientist a démontré la planification de synthèses en faisant appel à l'automatisation de laboratoire. Mais c'est précisément ici que le coût d'une erreur cesse d'être abstrait : un pas erroné consomme des réactifs, du temps d'appareil et, dans le pire des cas, la sécurité des personnes.
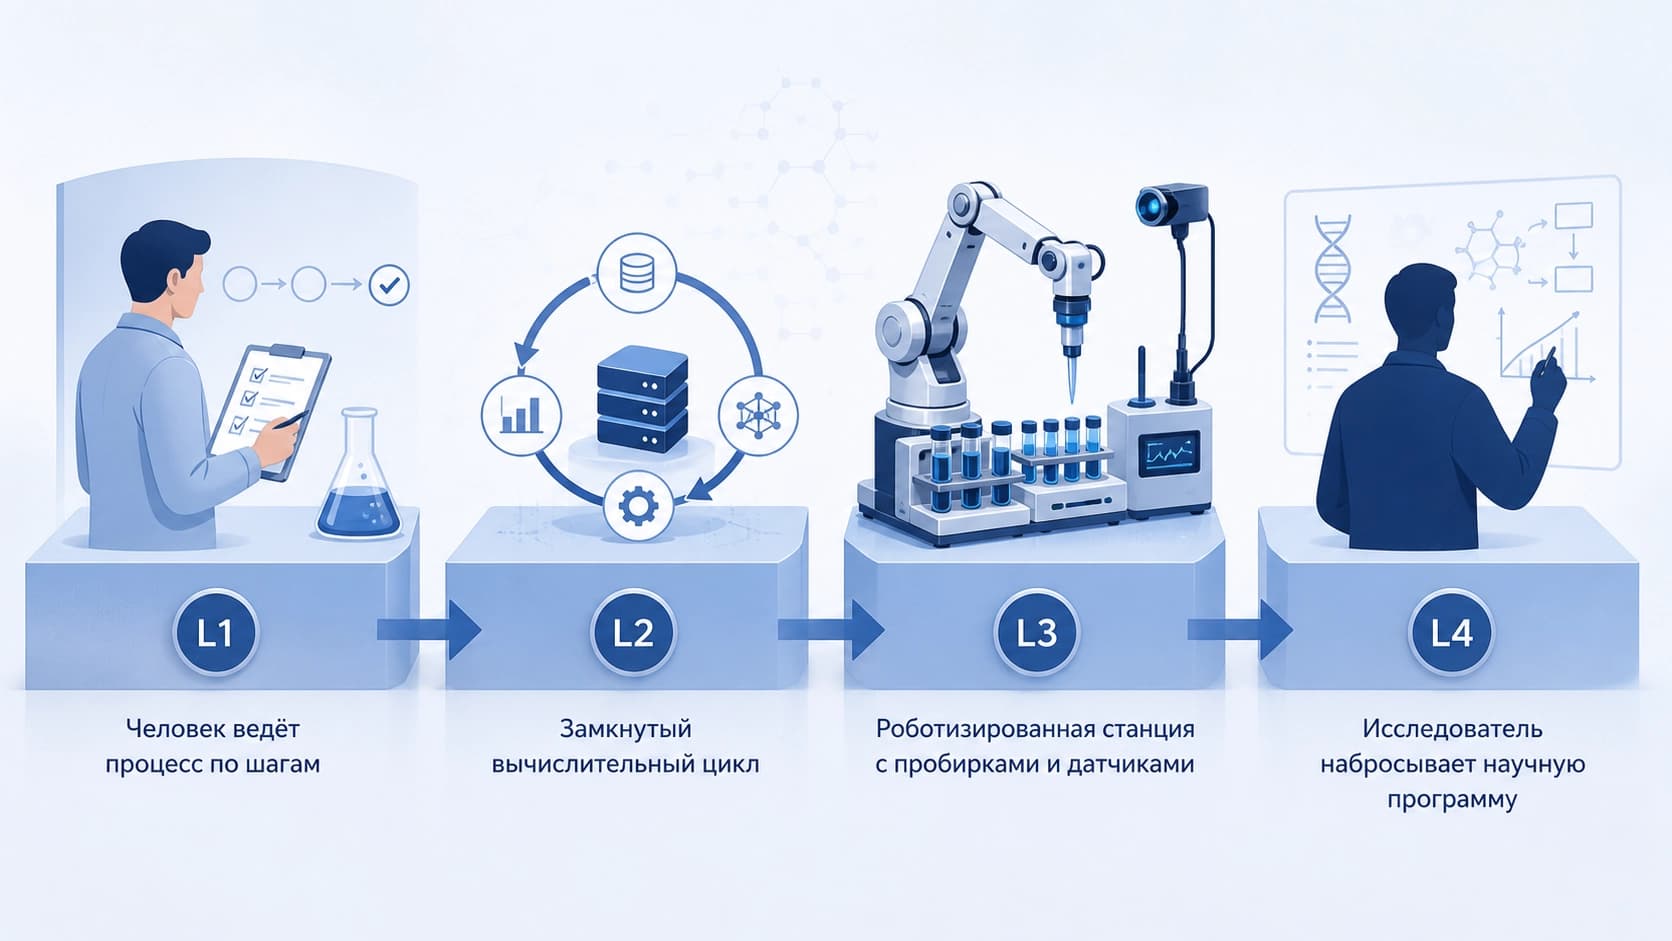
L4 — agent formulant l'agenda scientifique
Le degré supérieur — lorsque le système choisit lui-même quelles hypothèses tester, quelles directions considérer comme prioritaires et où chercher des lacunes dans la littérature. Pour l'instant, c'est plutôt un repère qu'une description de solutions opérationnelles. Mais c'est précisément lui qui donne la direction : la différence entre un « exécutant rapide » et un « coauteur-concepteur » est fondamentale, et il vaut la peine de la fixer par des mots plutôt que par l'intuition.
Pourquoi un tel cadre est nécessaire
L'utilité pratique des deux perspectives réside dans la possibilité de comparer l'incomparable. Si deux agents se disent tous deux « autonomes », mais que l'un tourne dans un simulateur et que l'autre pilote un robot synthétiseur, ce sont des systèmes de classes de responsabilité différentes.
Les auteurs proposent d'utiliser le framework pour trois tâches :
- Diagnostic. En décomposant l'agent par couches, on voit où se situe sa faiblesse : dans la perception des molécules, dans les outils ou dans la planification.
- Évaluation des risques. Plus le niveau est élevé, plus les conséquences d'une défaillance sont graves — et plus les vérifications avant l'action, plutôt qu'après, sont importantes.
- Conception. Comprendre quel niveau d'autonomie est réellement nécessaire pour une tâche évite la tentation de construire un L4 là où un L2 soigné suffirait.
Limites et questions non résolues
Une réserve honnête : l'échelle est un modèle conceptuel, et non une échelle mesurée. Elle aide à penser, mais ne remplace pas la validation, la certification et la reproductibilité des résultats. De plus, la chimie tolère mal le « presque correct » : dans un texte, une coquille est fâcheuse ; dans une formule structurale, c'est déjà une autre substance.
Une question non résolue à part entière — les données. La rétroaction issue d'un vrai laboratoire est coûteuse et rare, et sans elle, l'agent L3 reste une théorie. La seconde question est l'interprétabilité : le chimiste doit comprendre pourquoi le système a proposé précisément cette voie de synthèse, sinon la confiance ne sera pas au rendez-vous.
L'essentiel en bref
Les agents LLM moléculaires ne sont pas simplement « de la chimie plus un chatbot ». C'est une classe distincte de systèmes, où le modèle de langage joue le rôle de répartiteur entre graphes, spectres, logiciels de calcul et équipements de laboratoire. Le travail arXiv:2608.23104 est utile avant tout par son vocabulaire : quatre couches architecturales et quatre degrés d'autonomie offrent un langage commun pour parler de ce que ces agents savent déjà faire, de ce qui leur manque et de l'endroit où passe la frontière entre une accélération utile de la routine et une décision qu'il vaut mieux laisser à l'humain.


