
Une couche de classification au-dessus de SpeechLLM : là où elle surpasse la génération d’étiquettes pour la reconnaissance des émotions
À partir des corpus IEMOCAP et MELD, l’étude compare la génération d’étiquettes émotionnelles à un classificateur linéaire appliqué aux représentations latentes d’une SpeechLLM compacte. Le gain de performance apporté par le classificateur n’est pas universel : il dépend du corpus et de l’utilisation de transcriptions de référence ou de résultats ASR.
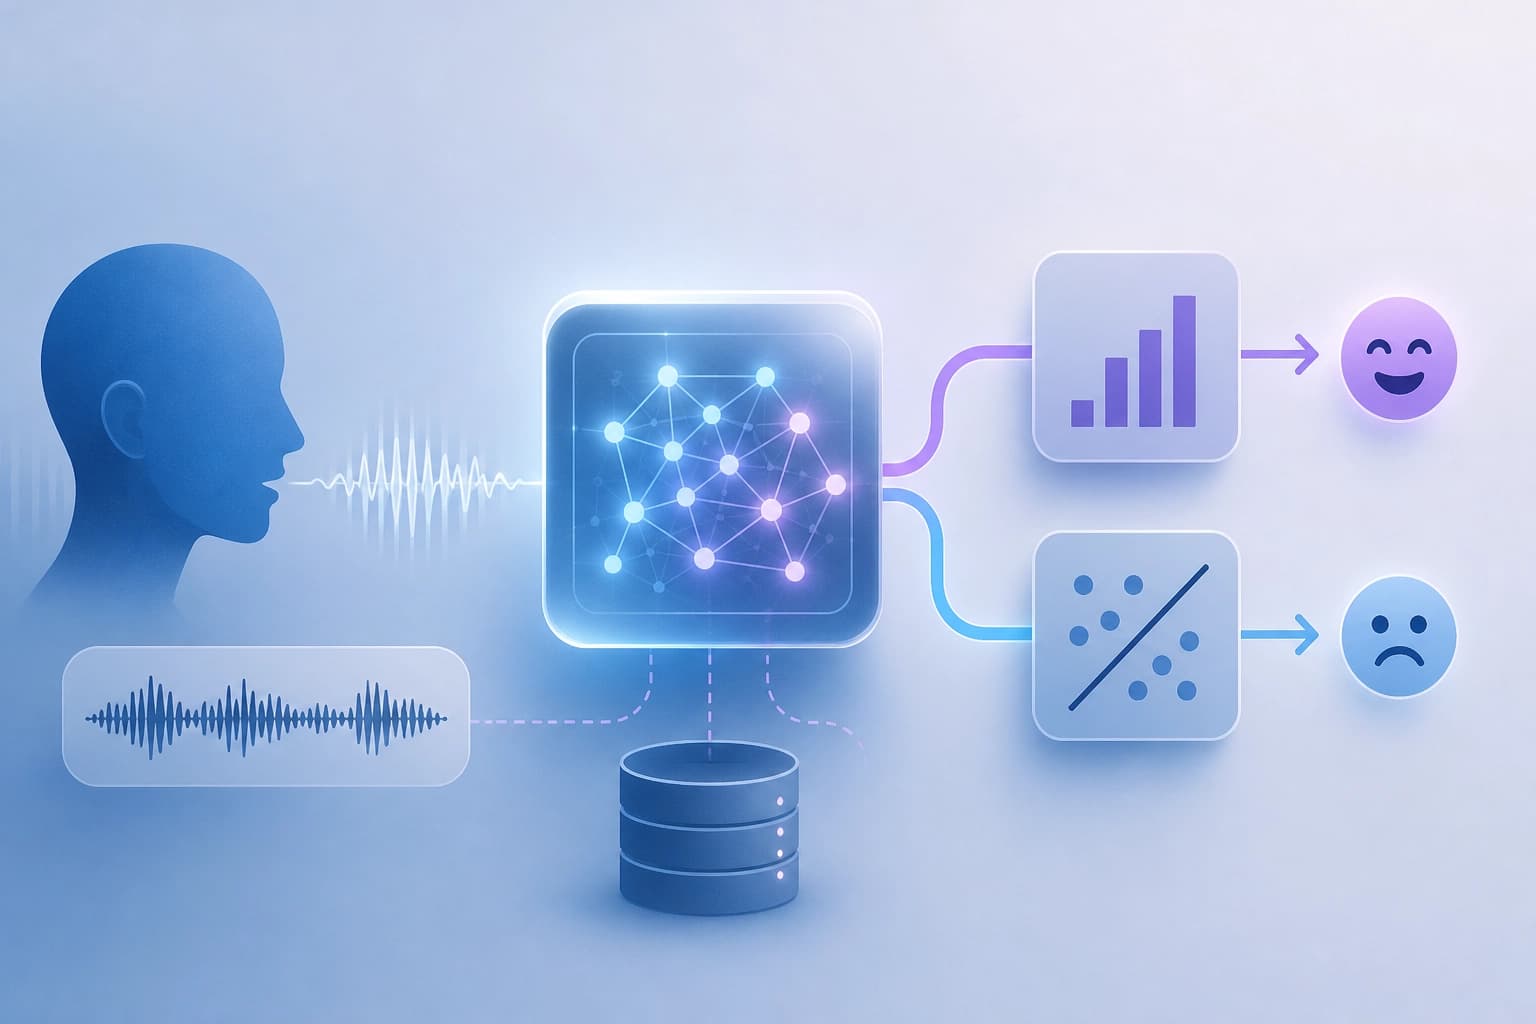
Deux approches de reconnaissance des émotions
L’article compare la génération d’un token-étiquette par un LLM et la classification discriminative au moyen d’une tête linéaire appliquée aux états cachés du LLM. L’approche générative s’appuie sur les représentations de sortie déjà disponibles du LLM. L’approche discriminative ajoute à celui-ci une tête de classification distincte.
| Critère | Génération d’un token-étiquette | Classification discriminative |
|---|---|---|
| Rôle du LLM | Fournit les représentations de sortie pour l’étiquette | Fournit les états cachés à la tête |
| Mécanisme de décision | Le LLM génère un token-étiquette | Une tête linéaire classe l’état caché |
| Élément utilisé | Sortie déjà générée par le modèle | États cachés du LLM |
La différence pratique est que la génération utilise la sortie déjà produite par le modèle, tandis que la tête lit les états cachés.
Conditions de comparaison
Les comparaisons ont été réalisées sur IEMOCAP et MELD. Un SpeechLLM compact a été utilisé : un encodeur Whisper-medium gelé et un LLM de 3B. Pour chaque comparaison, des transcriptions de référence et des transcriptions ASR ont été utilisées. La comparaison couvre deux sources de texte ; l’effet de la tête a donc été évalué séparément pour chacune. Critère d’évaluation : comparer les résultats uniquement au sein d’un même jeu de données et pour une même source de transcription.
Dans quels cas la tête de classification surpasse la génération d’étiquettes
La tête de classification a amélioré le Macro F1 dans 10 configurations sur 14. Sur IEMOCAP, elle a amélioré toutes les configurations avec des transcriptions ASR et atteint 76,97 % de Macro F1. Le mode audio seul a également montré un gain significatif sur ce jeu de données. Sur MELD, la tête a été bénéfique en mode audio seul, mais pas avec les transcriptions ASR. Conclusion : le gain dépend du jeu de données et de la source de transcription. La génération d’étiquettes n’est pas systématiquement surpassée.
Pourquoi ne pas généraliser les conclusions tirées des transcriptions de référence
Sur MELD, les transcriptions ASR présentent un WER de 32,38 %. Dans 4 configurations sur 6 utilisant du texte, l’effet de la tête s’inverse entre les transcriptions de référence et les transcriptions ASR. Les conclusions tirées des transcriptions de référence ne se maintiennent donc pas nécessairement avec l’ASR. Critère pratique : évaluer la tête sur la source de texte qui sera utilisée.
Ce que révèlent les tokens du vocabulaire les plus proches
Sur IEMOCAP et MELD, les tokens du vocabulaire du LLM les plus proches des vecteurs de classe appris étaient principalement des mots associés aux émotions. Il ne s’agissait pas de noms explicites d’émotions. Cela montre que le nom explicite d’une émotion ne correspond pas nécessairement au token du vocabulaire le plus proche. Critère de vérification : examiner les tokens proches du vecteur de classe, et pas seulement le nom de l’étiquette.
Critère de choix
Le choix de l’approche repose sur deux éléments : le jeu de données et la source de transcription.
- Pour les transcriptions ASR, évaluer la tête sur l’ASR, et non sur le texte de référence.
- Pour le mode audio seul, tenir compte des gains observés sur IEMOCAP et MELD.
- Pour les transcriptions de référence, ne pas généraliser les conclusions à l’ASR.
- Pour interpréter les classes, examiner les tokens du vocabulaire du LLM les plus proches.
Critère final : la tête surpasse la génération d’étiquettes lorsque l’évaluation sur le jeu de données et la source de transcription visés montre un gain.
Foire aux questions
Matériaux connexes
Tous matériaux
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026
Modèle du monde pour les agents basés sur des LLM fermés : correction aux points de risque
PAWM est proposé comme un prédicteur externe qui ne reproduit pas l’observation étape par étape, mais s’active en cas d’échec probable et détourne l’agent d’une action erronée. Après un SFT sur des scénarios synthétiques et un co-entraînement GRPO, la méthode a enregistré des gains de 24,3 % sur ScienceWorld et de 7,7 % sur WebArena-Lite pour Claude Sonnet 4.5.
4 novembre 2026
Des évaluations individuelles aux ensembles admissibles : décodage global sous contraintes DDI
L’article compare une sélection globale exacte d’un ensemble compatible de médicaments, réalisée au moyen de la programmation linéaire en nombres entiers mixtes, à plusieurs méthodes locales de résolution des conflits DDI avec les scores FLAME fixés sur MIMIC-III. Sur l’échantillon de test, la méthode globale offre un gain faible mais constant en Jaccard, qui augmente lorsque les contraintes se durcissent et atteint +0.0064 par rapport à la meilleure méthode locale de référence.
4 novembre 2026