
Modèle du monde pour les agents basés sur des LLM fermés : correction aux points de risque
PAWM est proposé comme un prédicteur externe qui ne reproduit pas l’observation étape par étape, mais s’active en cas d’échec probable et détourne l’agent d’une action erronée. Après un SFT sur des scénarios synthétiques et un co-entraînement GRPO, la méthode a enregistré des gains de 24,3 % sur ScienceWorld et de 7,7 % sur WebArena-Lite pour Claude Sonnet 4.5.
Problème : l’agent manque de connaissances sur l’environnement
Les agents avancés basés sur des LLM de type « boîte noire » raisonnent bien sur un horizon long et génèrent des actions avec précision. Mais ils ne disposent pas de connaissances acquises sur l’évolution de l’environnement pour une tâche agentique donnée. L’article arXiv:2610.29139, soumis le 21 octobre 2026, décrit cette lacune.
Un modèle du monde apporte à l’agent des connaissances sur un environnement spécifique. Il prédit la réaction de l’environnement à l’action que l’agent s’apprête à exécuter. Ce modèle apporte des informations propres à la tâche.
Critère pratique : vérifier le lien entre le modèle du monde et l’environnement cible. Des connaissances générales en raisonnement ne comblent pas la lacune dans la compréhension d’une tâche spécifique.
Mode de correction : intervenir au point de risque, pas à chaque étape
Les modèles du monde précédemment conçus pour les agents LLM prédisent principalement l’observation suivante à chaque étape. Ce mode est coûteux et peu informatif. Les observations isolées apportent peu de conseils liés à la tâche. Il n’est pas nécessaire d’anticiper à chaque étape.
Une étude pilote a montré que les conseils du modèle du monde sont les plus utiles lorsqu’il anticipe les pièges dans un futur limité à plusieurs étapes. La correction doit donc intervenir aux points de risque, plutôt que fonctionner en continu.
| Option | Ce que l’on sait |
|---|---|
| Prédiction étape par étape | Prédit l’observation suivante à chaque étape ; coûteuse et peu informative. |
| Anticipation des pièges | Anticipe les pièges dans un futur limité à plusieurs étapes ; fournit les conseils les plus utiles. |
Critère pratique : choisir un mode qui s’active en cas de piège potentiel et n’utilise pas l’anticipation à chaque étape.
Comment fonctionne l’anticipation des pièges
Les auteurs ont présenté Pitfall Anticipation World Model (PAWM). Le modèle repose sur trois éléments :
- intervient sélectivement en cas de piège potentiel ;
- prédit l’échec imminent ;
- détourne l’agent du piège au point de risque.
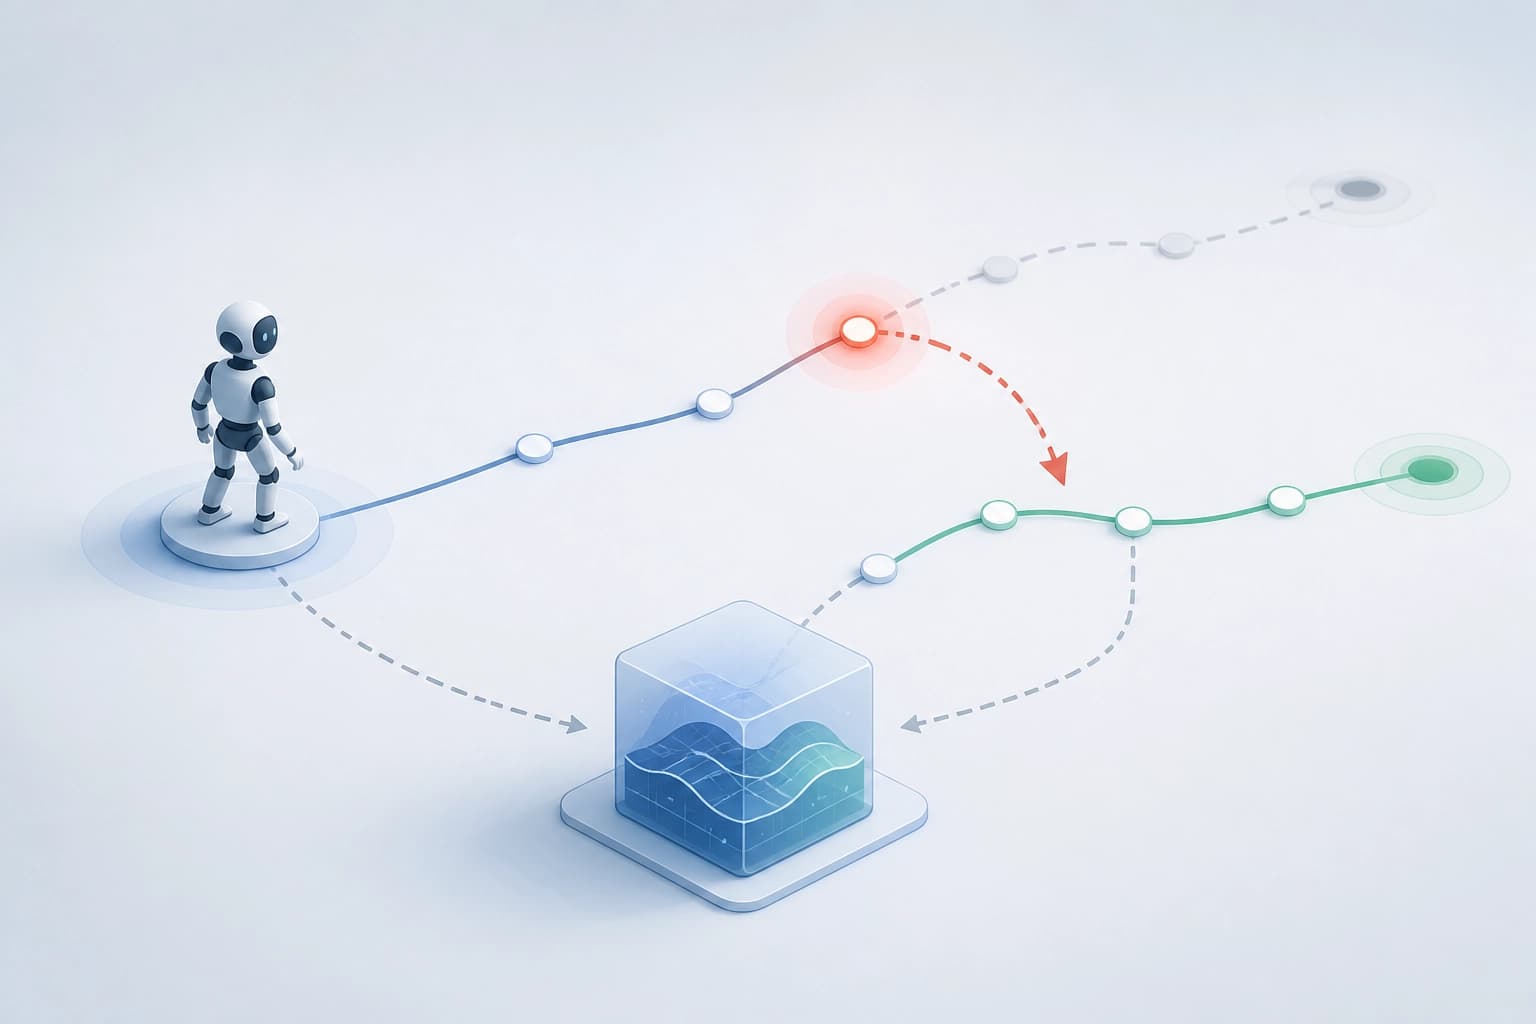
Critère pratique : le déclencheur de la correction doit s’appuyer sur un piège potentiel et une prévision d’échec imminent.
Entraînement du modèle en deux étapes
Les auteurs entraînent Pitfall Anticipation World Model (PAWM) en deux étapes.
- Supervised Fine-Tuning (SFT) sur des données synthétiques. Ces données synthétiques contiennent des annotations de pièges pour les agents.
- Co-entraînement GRPO avec un LLM de type « boîte noire ». Cette étape optimise le modèle dans l’environnement cible.
Critère pratique : vérifier les deux étapes — l’annotation des pièges et le co-entraînement dans l’environnement cible.
Évaluation : où observer les gains
La méthode améliore les résultats de Claude Sonnet 4.5 de 24,3 % dans ScienceWorld et de 7,7 % dans WebArena-Lite.
| Environnement | Gain pour Claude Sonnet 4.5 |
|---|---|
| ScienceWorld | 24,3 % |
| WebArena-Lite | 7,7 % |
Les auteurs indiquent également que le modèle surpasse plusieurs méthodes de référence. Critère pratique : examiner les gains dans l’environnement cible et les comparer aux méthodes de référence. Le transfert des résultats d’un environnement à un autre doit être vérifié séparément.
Foire aux questions
Matériaux connexes
Tous matériaux
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026
Une couche de classification au-dessus de SpeechLLM : là où elle surpasse la génération d’étiquettes pour la reconnaissance des émotions
À partir des corpus IEMOCAP et MELD, l’étude compare la génération d’étiquettes émotionnelles à un classificateur linéaire appliqué aux représentations latentes d’une SpeechLLM compacte. Le gain de performance apporté par le classificateur n’est pas universel : il dépend du corpus et de l’utilisation de transcriptions de référence ou de résultats ASR.
4 novembre 2026
Des évaluations individuelles aux ensembles admissibles : décodage global sous contraintes DDI
L’article compare une sélection globale exacte d’un ensemble compatible de médicaments, réalisée au moyen de la programmation linéaire en nombres entiers mixtes, à plusieurs méthodes locales de résolution des conflits DDI avec les scores FLAME fixés sur MIMIC-III. Sur l’échantillon de test, la méthode globale offre un gain faible mais constant en Jaccard, qui augmente lorsque les contraintes se durcissent et atteint +0.0064 par rapport à la meilleure méthode locale de référence.
4 novembre 2026