
SpecEvo : aligner des LLM légers et avancés pour réduire le coût de la recherche évolutionnaire
Le framework SpecEvo redistribue la recherche évolutionnaire : les candidats ordinaires affinent des modèles peu coûteux, tandis que les modèles les plus performants ne sont sollicités qu’à des points de contrôle stratégiques, en s’appuyant sur l’historique des réussites et des impasses. Lors d’expériences menées sur 176 tâches, cette approche a permis d’égaler, voire de dépasser, des solutions plus coûteuses, tout en réduisant de 80 % les frais d’API.
Objectif et usage
SpecEvo (Speculative Evolution) est un framework multi-LLM destiné aux découvertes scientifiques. Il coordonne des modèles légers et avancés afin de réduire le coût de la recherche de programmes candidats. L’article arXiv:2610.28706 a été soumis le 20 octobre 2026. Les auteurs sont Ha Minh Hieu, Tongyao Zhu, Do Xuan Long et Min-Yen Kan.
Caractéristiques clés :
- type : framework multi-LLM ;
- usage : découvertes scientifiques et recherche algorithmique ;
- principe : coordination de modèles légers et avancés ;
- article : arXiv:2610.28706, soumis le 20 octobre 2026 ;
- auteurs : Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, Min-Yen Kan.
Critère pratique : envisager ce framework pour les tâches où le coût des API est important et qui nécessitent une recherche de programmes candidats avec des étapes de contrôle peu fréquentes.
Architecture : rôles des modèles légers et avancés
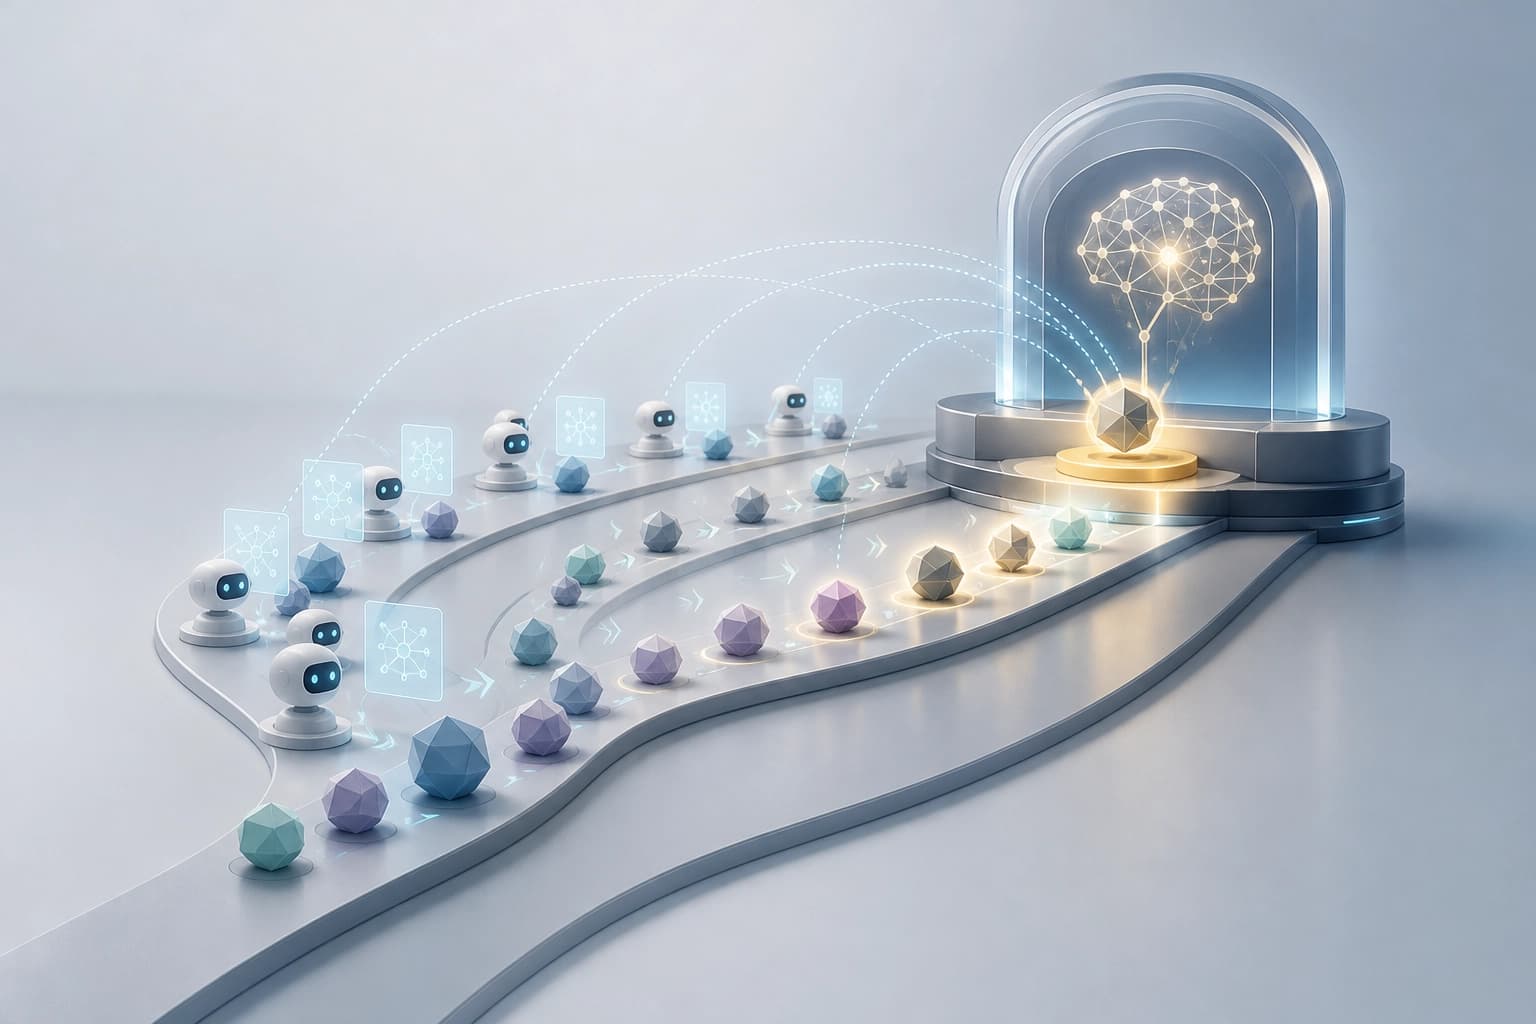
SpecEvo répartit le travail entre des modèles légers et avancés. Les modèles légers assurent en parallèle les fonctions de Speculators et d’Advisor. Un modèle avancé intervient comme Navigator lors d’étapes de contrôle peu fréquentes.
| Composant | Type de modèle | Fonction | Mode de fonctionnement | | Speculators | légers | génèrent et améliorent les programmes candidats | en parallèle | | Advisor | léger | synthétise les réussites, les échecs et les pistes saturées ; les transforme en recommandations permanentes | synthèse des informations accumulées | | Navigator | avancé | étudie la population en évolution ; intervient par synthèse, amélioration ciblée ou changement de cadre de recherche | rarement, lors des étapes de contrôle |
Critère pratique : confier la recherche courante et la synthèse des éléments de preuve à des modèles légers, et faire appel aux modèles avancés pour des interventions stratégiques.
Flux de travail « d’abord explorer, puis consolider »
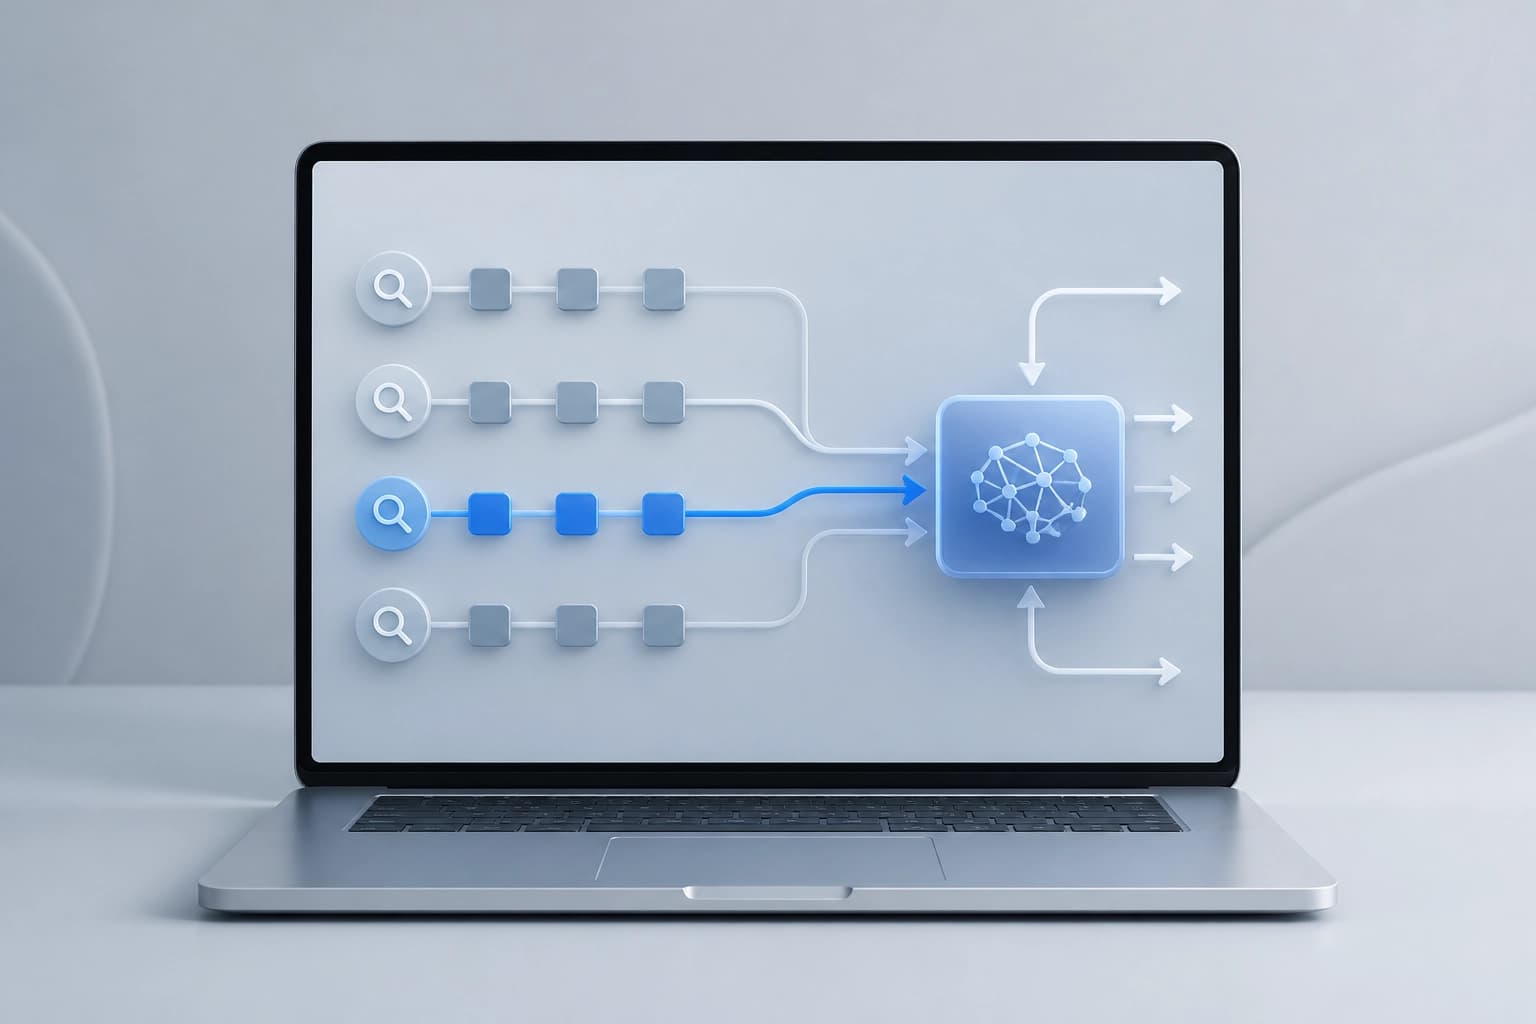
Dans SpecEvo, le processus repose sur la délégation de la recherche courante et de la synthèse des éléments de preuve à des modèles peu coûteux. Les modèles avancés interviennent pour des actions stratégiques. Leur utilité se répercute sur de nombreuses évaluations peu coûteuses ultérieures.
Étapes :
- Les modèles légers effectuent la recherche courante de programmes candidats.
- Advisor synthétise les informations accumulées sur les réussites, les échecs et les pistes saturées.
- Lors d’une étape de contrôle peu fréquente, Navigator étudie la population et choisit une intervention.
- L’intervention dépend de la stagnation de la recherche et peut prendre la forme d’une synthèse, d’une amélioration ciblée ou d’un changement de cadre.
- Les modèles peu coûteux poursuivent les évaluations en tenant compte des recommandations permanentes.
Critère pratique : cette approche convient si la recherche permet des points de contrôle peu fréquents et l’accumulation de recommandations entre ceux-ci.
Résultats et comparaison avec les méthodes de référence
Les auteurs ont évalué SpecEvo sur 176 tâches dans quatre domaines de découvertes scientifiques et algorithmiques. Le framework a obtenu des résultats égaux ou supérieurs à ceux des méthodes de référence reposant sur des modèles avancés. Dans le même temps, il a réduit les dépenses d’API jusqu’à 80 %. Pour la recherche d’équations, le framework a atteint une efficacité d’évaluation jusqu’à 1,5× supérieure à celle des méthodes de référence rentables. Le framework a surpassé la méthode de référence la plus performante, CO-Bench, de 3,8 %.
| Indicateur | Résultat | | Comparaison avec les méthodes de référence reposant sur des modèles avancés | égal ou supérieur | | Réduction des dépenses d’API | jusqu’à 80 % | | Efficacité d’évaluation pour la recherche d’équations | jusqu’à 1,5× supérieure à celle des méthodes de référence rentables | | Avance sur CO-Bench | 3,8 % |
Critère pratique de sélection : comparer la qualité de la recherche et les dépenses d’API aux méthodes de référence sur ses propres tâches. Les auteurs concluent que la coordination des modèles en fonction de la trajectoire de recherche constitue une approche efficace pour mener des découvertes scientifiques à moindre coût.
Foire aux questions
Matériaux connexes
Tous matériaux
Fig : des interventions ludiques contrôlées pour tester le comportement social des agents d’IA
Fig reçoit une description en langage naturel du comportement recherché, la décline en variantes et modifie de manière ciblée les conditions du jeu afin d’inciter les modèles à adopter les actions souhaitées. Dans des scénarios valides couvrant six schémas sociaux, les interventions ont augmenté de 10,9 % en moyenne la proportion de tentatives visant le comportement ciblé par rapport aux groupes témoins, et les auteurs proposent de considérer les environnements multi-agents comme un banc d’essai configurable pour une évaluation reproductible.
21 novembre 2026
Vérification des politiques d’agents sans dépendre du prompt : environnements d’exécution, jeux de tests et filtre entraînable
Ce travail propose un cadre qui transforme des environnements exécutables en ensembles de scénarios permettant de tester les politiques des agents et d’améliorer le composant de protection de manière itérative. Le filtre entraîné réduit de 40 à 44 % le taux de violations réussies par rapport à une approche reposant uniquement sur les instructions du prompt, et rejette moins souvent à tort les requêtes sûres.
20 novembre 2026
PerMIT : intégrité de la mémoire à long terme des agents LLM et confiance collective vérifiée par machine
Les auteurs proposent l’architecture PerMIT, qui limite la transmission de données non fiables provenant de l’environnement vers les actions sensibles de l’agent au moyen d’une interface mémoire finie ; deux théorèmes vérifiés dans Lean 4 et l’accumulation des verdicts de la communauté réduisent le risque d’empoisonnement sans accroître la charge des utilisateurs individuels. Dans les expériences menées sur Trojan Hippo et τ²-bench, le système n’a détecté aucune injection réussie avec des vérificateurs légers et a amélioré les résultats de nouveaux agents sur des tâches différées.
20 novembre 2026