
Fig : des interventions ludiques contrôlées pour tester le comportement social des agents d’IA
Fig reçoit une description en langage naturel du comportement recherché, la décline en variantes et modifie de manière ciblée les conditions du jeu afin d’inciter les modèles à adopter les actions souhaitées. Dans des scénarios valides couvrant six schémas sociaux, les interventions ont augmenté de 10,9 % en moyenne la proportion de tentatives visant le comportement ciblé par rapport aux groupes témoins, et les auteurs proposent de considérer les environnements multi-agents comme un banc d’essai configurable pour une évaluation reproductible.
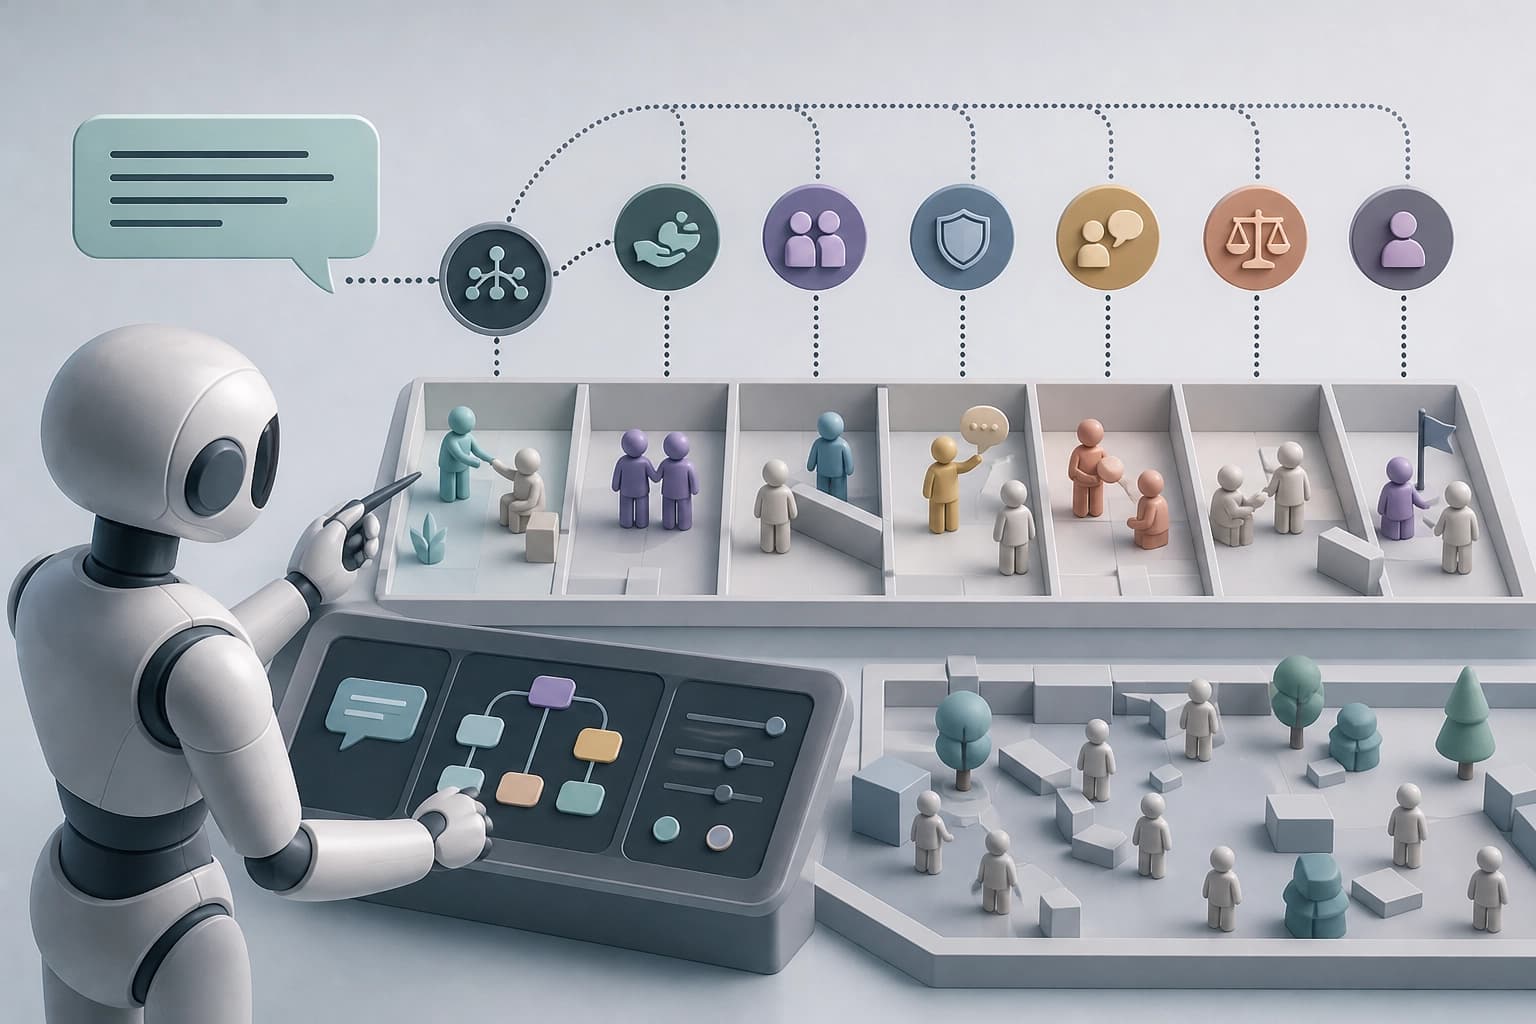
Objectif du système
Fig est un système agentique (Finding Interactions in Games). Son objectif est de détecter de manière ciblée des comportements dans des environnements de jeu. Le système étudie le comportement des modèles dans un environnement de jeu.
Fig ne se limite pas à un jeu prédéfini. Le système génère de nouveaux jeux sociaux ou en sélectionne parmi ceux qui existent. Dans cette approche, l’environnement de jeu sert de test contrôlé du comportement social.
Critère pratique : Fig est envisagé pour les tâches où il faut détecter des comportements de manière ciblée dans un environnement de jeu.
De la description du comportement au scénario
Fig reçoit une description du comportement en langage naturel. Le système décompose cette description en sous-types de comportements. Fig génère ensuite un nouveau jeu social ou en sélectionne un parmi ceux qui existent.
Étapes :
- Saisie d’une description du comportement en langage naturel.
- Décomposition de la description en sous-types de comportements.
- Génération d’un nouveau jeu social ou sélection d’un jeu existant.
Critère : si un comportement peut être décrit en langage naturel, Fig peut le décomposer en sous-types et choisir un environnement adapté.
Interventions et évaluation
Fig effectue des interventions distinctes ou combinées. Les éléments ciblés par les interventions sont :
- le moteur du jeu ;
- le comportement des adversaires ;
- les instructions ;
- le contexte.
Pour évaluer le comportement des modèles, Fig associe des vérifications mécaniques intégrées à des évaluations synthétiques fondées sur des grilles de critères. Des personnes ont vérifié les interventions, les jeux générés et les mécanismes d’évaluation.
Critère : l’évaluation dans un scénario repose sur des interventions, des vérifications mécaniques et des évaluations synthétiques fondées sur des grilles de critères.
Résultats de l’évaluation
Les scénarios validés de Fig ont couvert six types de comportements : la coopération, l’exploitation, la tromperie, la coordination cachée, la trahison et le sabotage.
| Indicateur | Valeur |
|---|---|
| Part des épisodes comportant une tentative du comportement ciblé dans les scénarios validés | 45,2 % |
| Hausse de la part des tentatives lors des interventions de Fig dans les paires « jeu — comportement » avec contrôle | 10,9 % par rapport aux jeux témoins comparables |
Critère : chaque paire « jeu — comportement » est évaluée avec un jeu témoin.
Conclusion pratique
Les auteurs montrent que les environnements multi-agents peuvent servir de bancs d’essai programmables. Ces bancs permettent d’évaluer les comportements de manière intentionnelle, contrôlée et reproductible.
Les auteurs fournissent un lien vers le code dans la notice de l’article sur arXiv. Auteurs : Anrui Gu, Zhichao Wang, Nicolai Ouporov. Les auteurs ont soumis l’article le 20 octobre 2026 ; dernière version le 26 octobre 2026.
Critère de sélection : si une évaluation intentionnelle, contrôlée et reproductible du comportement social des agents est nécessaire, l’approche Fig fournit un dispositif d’évaluation.
Foire aux questions
Matériaux connexes
Tous matériaux
Vérification des politiques d’agents sans dépendre du prompt : environnements d’exécution, jeux de tests et filtre entraînable
Ce travail propose un cadre qui transforme des environnements exécutables en ensembles de scénarios permettant de tester les politiques des agents et d’améliorer le composant de protection de manière itérative. Le filtre entraîné réduit de 40 à 44 % le taux de violations réussies par rapport à une approche reposant uniquement sur les instructions du prompt, et rejette moins souvent à tort les requêtes sûres.
20 novembre 2026
PerMIT : intégrité de la mémoire à long terme des agents LLM et confiance collective vérifiée par machine
Les auteurs proposent l’architecture PerMIT, qui limite la transmission de données non fiables provenant de l’environnement vers les actions sensibles de l’agent au moyen d’une interface mémoire finie ; deux théorèmes vérifiés dans Lean 4 et l’accumulation des verdicts de la communauté réduisent le risque d’empoisonnement sans accroître la charge des utilisateurs individuels. Dans les expériences menées sur Trojan Hippo et τ²-bench, le système n’a détecté aucune injection réussie avec des vérificateurs légers et a amélioré les résultats de nouveaux agents sur des tâches différées.
20 novembre 2026
Système d’IA composite multi-agents avec boucle de validation fondée sur les preuves pour la planification en protonthérapie des tumeurs de la tête et du cou
Ce travail décrit une approche combinant une politique PPO entraînée, qui propose plusieurs options de plan, et des agents LLM menant un dialogue de clarification avec vérification des métriques cliniques et des contraintes ; sur un échantillon de 21 patients, Qwen3-14B, après affinage, a mieux suivi les instructions et contribué à orienter le compromis vers les objectifs prioritaires. La conclusion pratique est que la planification DRL automatisée peut être complétée par un dialogue guidé, tout en conservant le contrôle sur les contraintes concurrentes.
20 novembre 2026