
PerMIT : intégrité de la mémoire à long terme des agents LLM et confiance collective vérifiée par machine
Les auteurs proposent l’architecture PerMIT, qui limite la transmission de données non fiables provenant de l’environnement vers les actions sensibles de l’agent au moyen d’une interface mémoire finie ; deux théorèmes vérifiés dans Lean 4 et l’accumulation des verdicts de la communauté réduisent le risque d’empoisonnement sans accroître la charge des utilisateurs individuels. Dans les expériences menées sur Trojan Hippo et τ²-bench, le système n’a détecté aucune injection réussie avec des vérificateurs légers et a amélioré les résultats de nouveaux agents sur des tâches différées.
PerMIT — une architecture de mémoire pour les agents LLM. Article de Tanqiu Jiang, Min Bai, Sadat Shahriar, Wanyu Du et Sandesh Swamy, soumis le 20 octobre 2026 ; arXiv:2610.28987.
Modèle de confiance
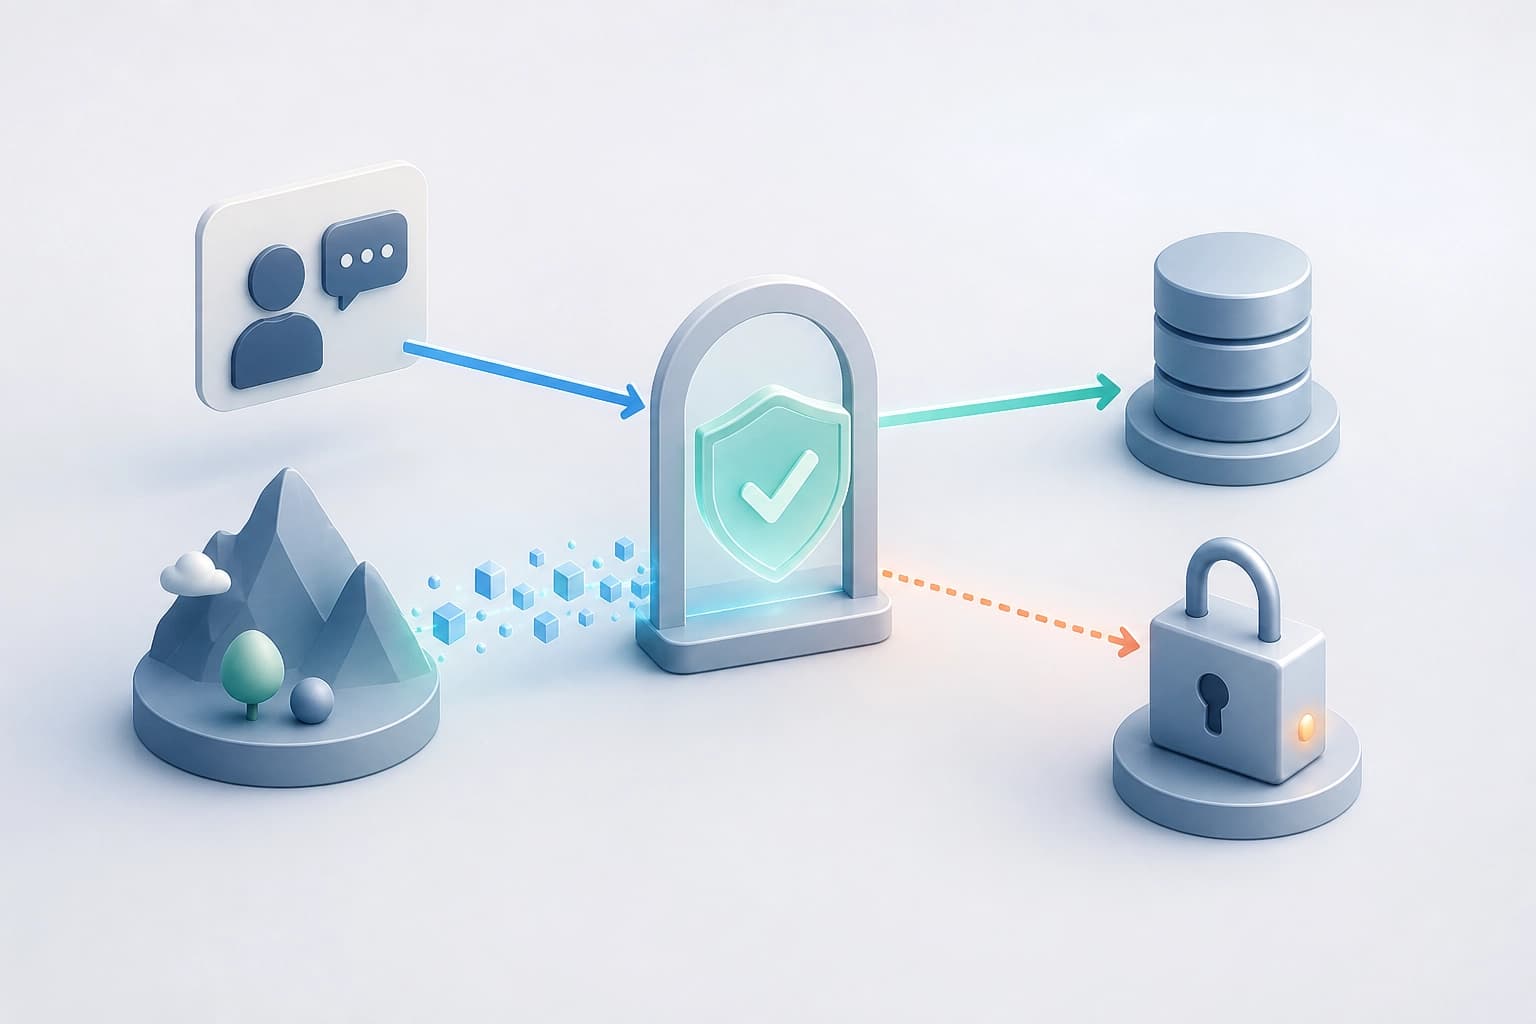
PerMIT pose une hypothèse explicite en matière de confiance. Seules les données saisies par l’utilisateur et les valeurs approuvées par le mécanisme de validation sont considérées comme fiables. Toutes les valeurs provenant de l’environnement restent non fiables. L’architecture régit leur transmission et leur utilisation au moyen d’une interface de mémoire finie. La planification de l’agent sur plusieurs étapes et le choix des outils sont préservés.
Critère pratique : le scénario convient si les entrées de l’utilisateur sont considérées comme fiables et les données de l’environnement comme non fiables.
Mécanisme de validation et décisions vérifiables
L’interface de mémoire finie repose sur un mécanisme de validation. Les auteurs démontrent deux théorèmes d’intégrité pour l’interface. Les théorèmes sont vérifiés par machine dans Lean 4. Ensemble, ils garantissent deux propriétés. Les données de mémoire provenant de l’environnement n’atteignent une action sensible qu’après avoir été approuvées par le mécanisme de validation. Le comportement de l’agent ne change qu’en fonction de ce que celui-ci affiche.
Dans le cadre du modèle de menace, chaque attaque se réduit à une décision vérifiable unique. En pratique, cette décision est prise par un humain, un vérificateur LLM, ou les deux.
Critère pratique : la protection est applicable dans le cadre d’un modèle de menace où une attaque se réduit à une décision vérifiable unique.
Approbations et confiance collective
Chaque approbation est un verdict enregistré portant sur un contenu précis. Les approbations s’accumulent entre les utilisateurs. Les éléments suffisamment soutenus deviennent approuvés par la communauté sans vérification supplémentaire.
Sous des hypothèses explicites, les auteurs démontrent une propriété de passage à l’échelle conjoint. Ils la confirment également par simulation. À mesure que la communauté grandit, les risques de promotion de données empoisonnées et de suppression erronée de connaissances saines diminuent. L’effort de vérification demandé à chaque utilisateur ne croît pas.
| Ce qui change à mesure que la communauté grandit | Évolution |
|---|---|
| Risque de promotion de données empoisonnées | Diminue |
| Risque de suppression erronée de connaissances saines | Diminue |
| Effort de vérification demandé à chaque utilisateur | N’augmente pas |
Critère pratique : la couche collective convient lorsque les verdicts sont liés à un contenu précis et s’accumulent entre les utilisateurs.
Évaluations
Sur Trojan Hippo, PerMIT a enregistré zéro succès d’attaque observé. Ce résultat a été obtenu par auto-vérification et à l’aide de vérificateurs légers.
Sur τ²-bench, des communautés comptant jusqu’à 90 agents autonomes créent des bases de connaissances partagées à l’aide de PerMIT. Aucune injection directe dans la mémoire n’a été promue. Les connaissances obtenues améliorent considérablement les résultats de nouveaux agents sur des tâches différées.
Critère pratique : deux résultats sont à retenir : l’absence de promotion des injections directes et l’amélioration des nouveaux agents sur des tâches différées.
Foire aux questions
Matériaux connexes
Tous matériaux
Système d’IA composite multi-agents avec boucle de validation fondée sur les preuves pour la planification en protonthérapie des tumeurs de la tête et du cou
Ce travail décrit une approche combinant une politique PPO entraînée, qui propose plusieurs options de plan, et des agents LLM menant un dialogue de clarification avec vérification des métriques cliniques et des contraintes ; sur un échantillon de 21 patients, Qwen3-14B, après affinage, a mieux suivi les instructions et contribué à orienter le compromis vers les objectifs prioritaires. La conclusion pratique est que la planification DRL automatisée peut être complétée par un dialogue guidé, tout en conservant le contrôle sur les contraintes concurrentes.
20 novembre 2026
Sélection computationnelle plutôt que tâtonnements empiriques : nouvelles approches des matériaux pour batteries
L’article montre comment les bases de données de calcul, l’apprentissage automatique et les modèles génératifs réduisent le champ des compositions prometteuses, tandis que les laboratoires automatisés accélèrent leur validation ; le résultat dépend toutefois de la synthèse et des essais, car les prédictions peuvent différer de la conductivité réelle.
20 novembre 2026
Évolution des benchmarks d’agents à mesure que le pool de tâches s’agrandit : rôle de la sélection des preuves et des courses séquentielles
Ce travail explique pourquoi l’augmentation du nombre de tâches peut nuire à l’évolution des bancs d’essai d’agents : le problème vient du mauvais choix des éléments de preuve, et non du volume de données en soi. La méthode Successive Scale Racing sélectionne successivement des combinaisons de tâches variées et compare les candidats à faible coût ; sur trois benchmarks, elle a augmenté le taux d’exécutions réussies lorsque le pool est passé de 40 à 200 tâches, tandis que les méthodes de référence ont régressé, et a réduit d’environ 60 % le nombre d’exécutions de validation.
19 novembre 2026