Pourquoi la trajectoire est une mauvaise unité de mesure
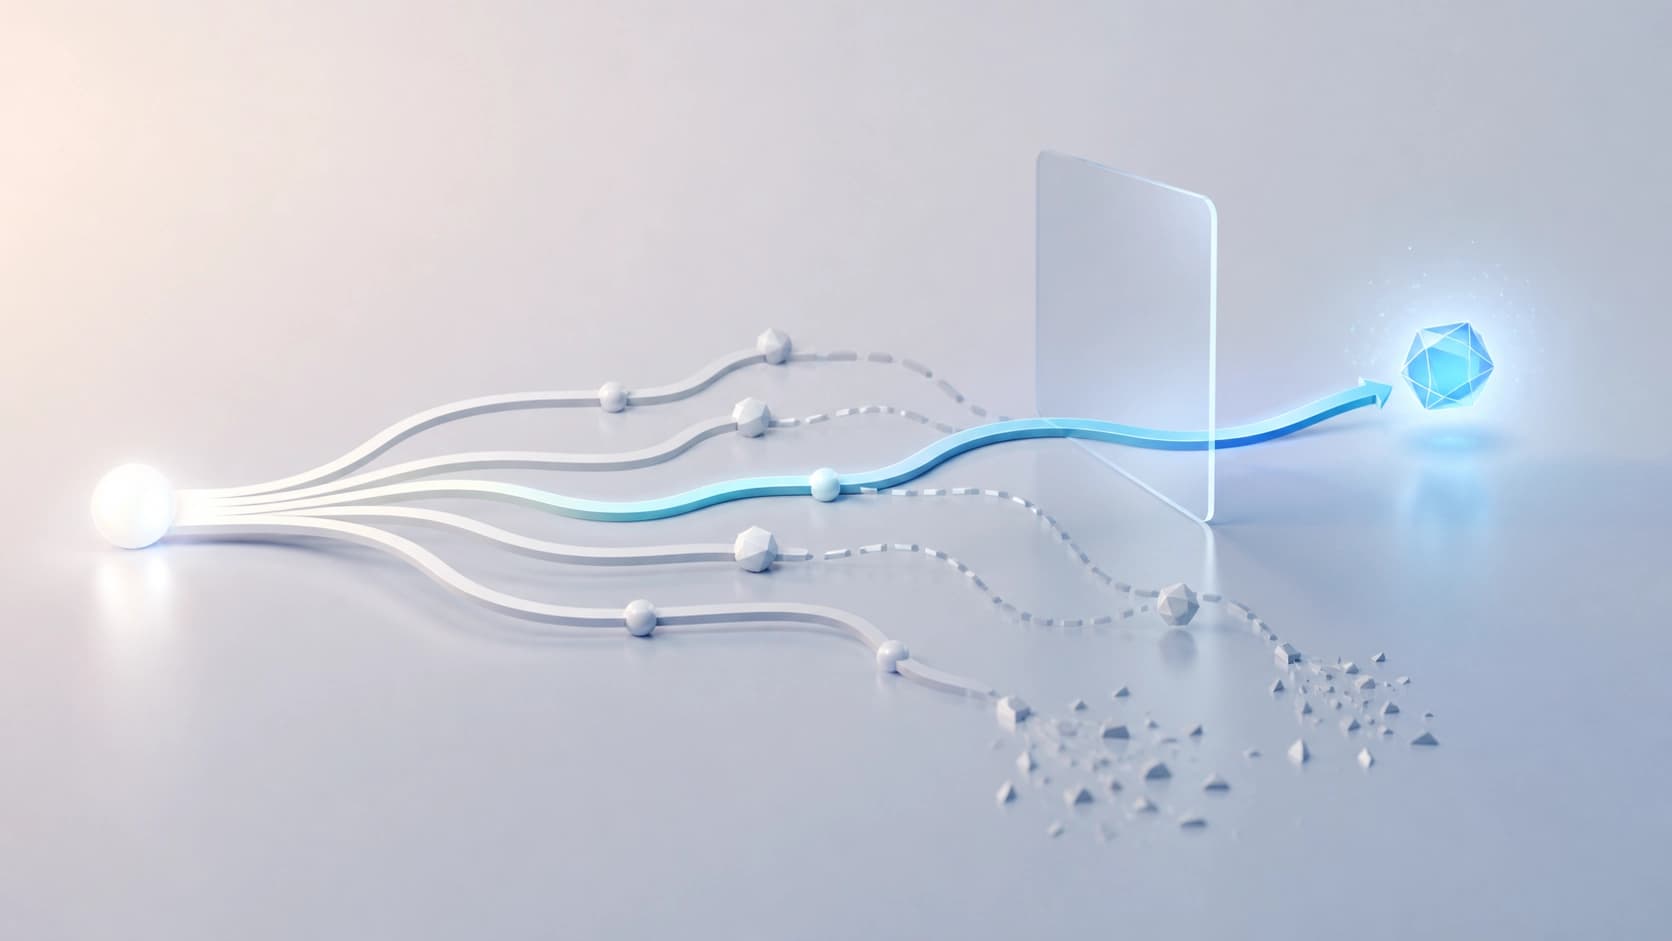
Les méthodes de raisonnement modernes lors de l'inférence fonctionnent toutes selon le même schéma : le modèle ne produit pas une seule réponse, mais tout un ensemble de chaînes candidates, après quoi une reward-model externe sélectionne la meilleure. La logique est simple — plus il y a de variantes, plus le risque que l'une d'elles soit réussie est élevé.
Le point faible se situe ailleurs. Chaque candidat est considéré comme un tout indivisible : on l'accepte entièrement, ou on le jette entièrement à la poubelle. Or un long raisonnement est rarement homogène. Le tableau typique — un départ assuré et correct, une formulation soignée du problème, une méthode bien choisie, puis une rupture : erreur arithmétique, bouclage, substitution de condition. Formellement, toute la chaîne est marquée comme un échec, alors que sa première moitié était tout à fait exploitable.
Le résultat — des calculs gaspillés. Nous payons la génération de tokens qui étaient corrects, puis nous les jetons avec la queue corrompue. C'est précisément sur cette inefficacité que les auteurs du travail Selective Regenerative Decoding attirent l'attention, publié sous la référence arXiv:2608.24338 (cs.AI) le 25 août 2026.
SRD : trois branches au lieu de deux
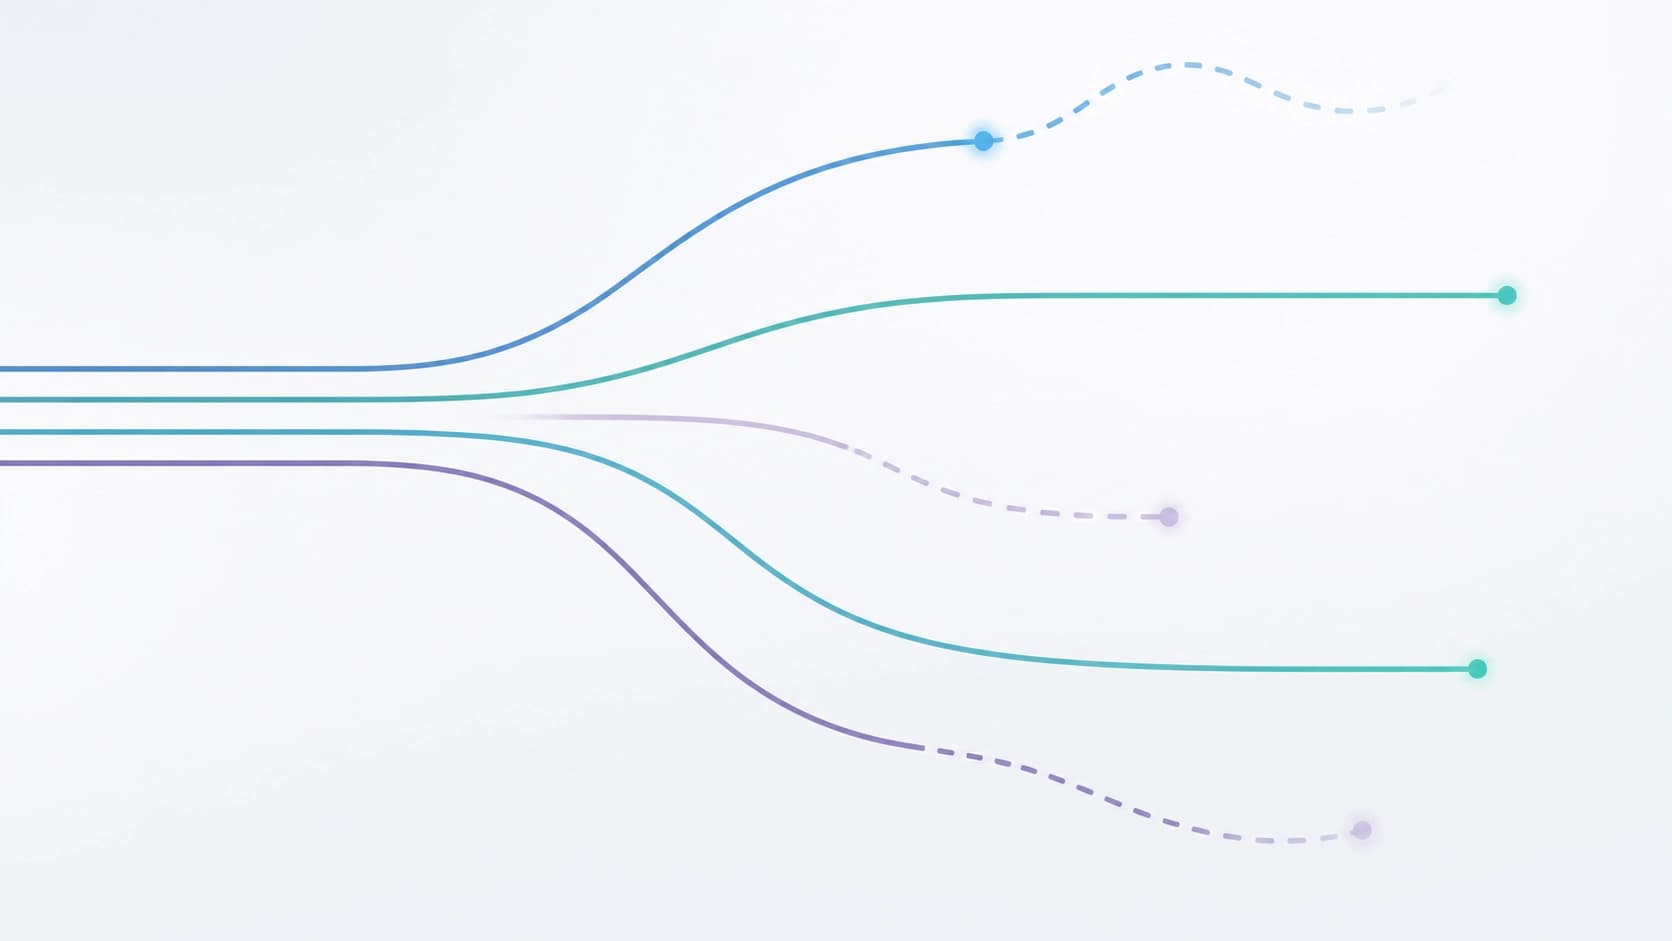
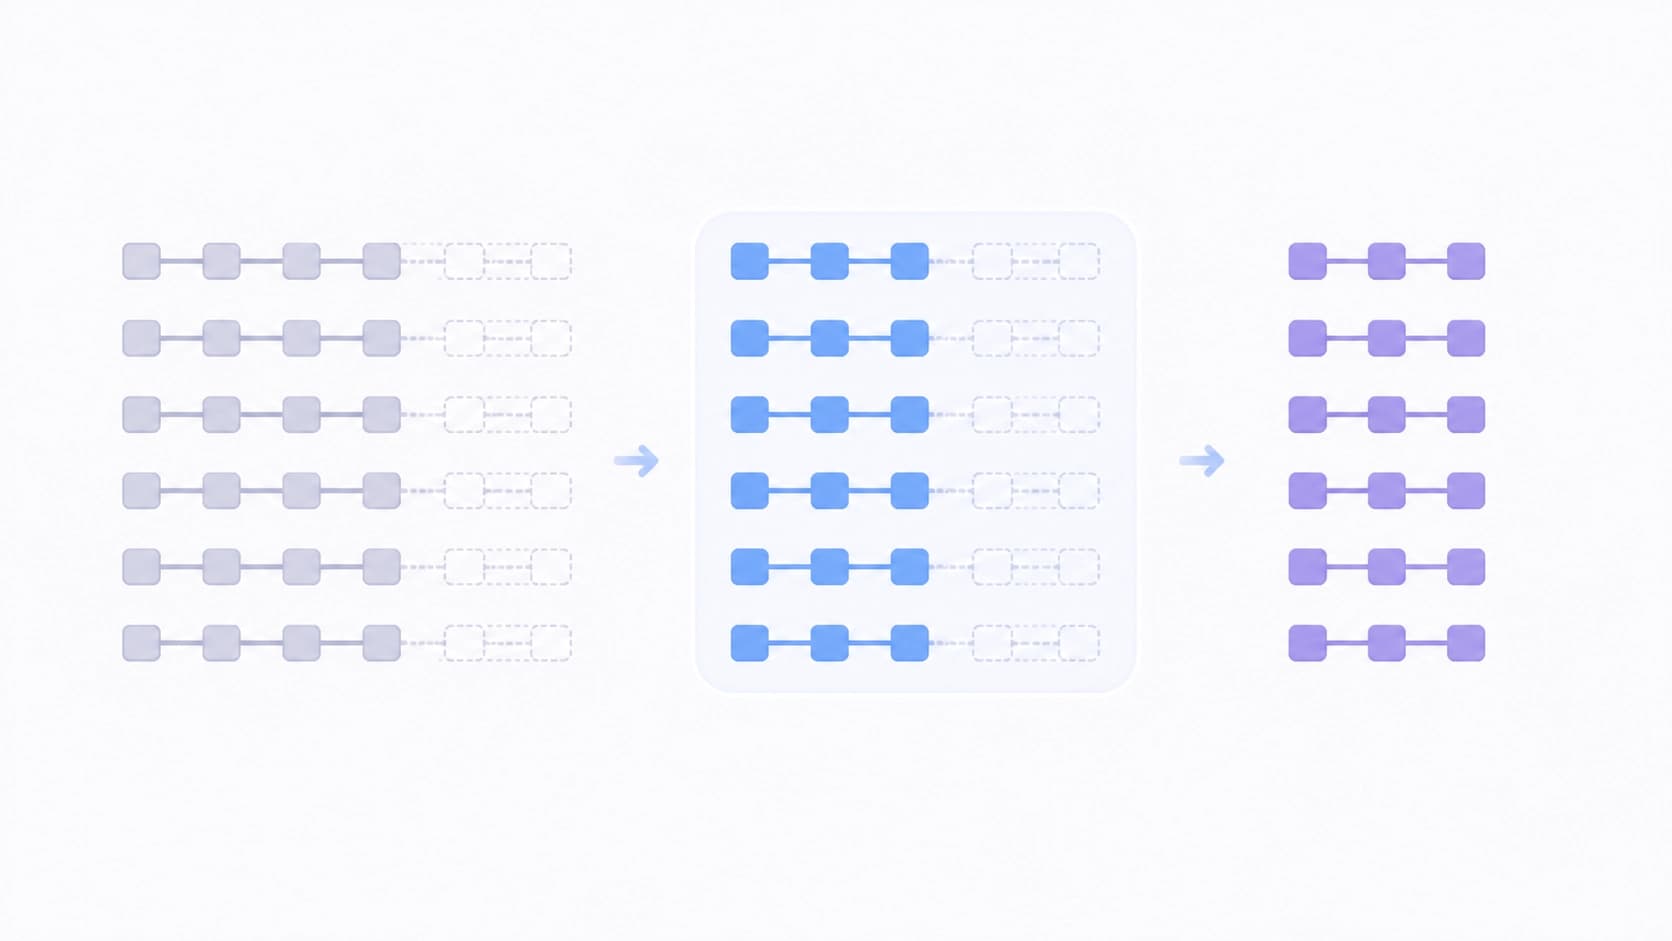
Selective Regenerative Decoding (SRD) propose de renoncer au choix binaire. Au lieu d'« accepter ou rejeter », chaque candidat est dirigé vers l'une des trois branches :
- rejeter — si la chaîne est inutile du début à la fin ;
- conserver — si elle passe la vérification dans son intégralité ;
- retravailler — si une partie utile existe, mais que le suffixe s'est manifestement dégradé.
Dans le troisième cas, le système ne réécrit pas le raisonnement à partir de zéro, mais conserve le préfixe de qualité et ne régénère que la portion corrompue. Cela ressemble davantage à la révision d'un brouillon qu'à la rédaction d'un nouveau texte : vous ne jetez pas une bonne introduction à cause d'une fin ratée, vous corrigez ce qui est cassé.
Les auteurs soulignent en particulier qu'une telle intervention ne nécessite pas de modèle donneur plus grand. Aucun « professeur intelligent » qui tirerait un élève faible vers le haut — tout le travail se fait dans le cadre des ressources de calcul déjà disponibles. C'est précisément ce qui rend la méthode applicable, et non un exercice théorique.
D'où vient le gain
Le plus intéressant dans ce travail n'est pas l'heuristique, mais sa justification. Sous des hypothèses souples, SRD offre une croissance démontrable de l'efficacité d'échantillonnage de 1,28 à 1,36 fois par rapport au rejection sampling classique, et la qualité attendue de la trajectoire finale s'avère strictement supérieure, et non simplement « pas pire ».
L'intuition ici est claire sans formules. Un candidat ayant subi une régénération de suffixe contient déjà en lui des calculs payés — ces tokens du préfixe qu'il n'est pas nécessaire de générer à nouveau. Plus on parvient à sauver de tels candidats limites, plus la part de texte généré qui part à la corbeille diminue. Et comme l'augmentation de l'ensemble de candidats accroît aussi le nombre de chaînes « presque réussies », le gain ne reste pas constant — il évolue à l'échelle du budget de génération.
Où cela a été testé
La partie empirique couvre quatre types de charge différents : MATH500 (problèmes mathématiques), GPQA Diamond (questions de niveau scientifique), HotpotQA (questions à plusieurs étapes sur des documents) et AlpacaEval (suivi d'instructions et évaluation des préférences). Les tests ont été menés sur plusieurs combinaisons « générateur + reward-model », afin que le résultat ne dépende pas d'une seule paire réussie.
Les résultats annoncés : SRD atteint la précision que l'on obtient habituellement avec le mode Best-of-N, mais consomme nettement moins de tokens générés. Et dans les scénarios à calculs limités, la méthode dépasse le speculative rejection — c'est-à-dire qu'elle gagne précisément là où chaque token superflu coûte cher.
Ce que cela change sur le fond
Le principal déplacement que les auteurs constatent est méthodologique. Auparavant, le choix s'opérait au niveau de la trajectoire entière : la reward-model attribuait une note et décidait du sort de tout le raisonnement. SRD transfère l'intervention à l'intérieur de la trajectoire, au niveau des segments, et ouvre de ce fait un domaine de compromis entre précision et calculs qui, jusqu'ici, n'avait presque pas été étudié.
Conclusion pratique pour ceux qui construisent des pipelines d'inférence : la qualité du raisonnement et le coût de son obtention ne sont pas nécessairement des grandeurs rigidement liées. Une partie des calculs « superflus » peut être récupérée si l'on cesse de considérer le brouillon du modèle comme un monolithe.
Ce qui reste dans l'ombre
Les questions ouvertes ne manquent pas. La principale — comment est précisément déterminée la frontière entre un préfixe sain et un suffixe dégradé : de ce critère dépend combien de candidats entreront en fin de compte dans la troisième branche. Ensuite — le coût de la régénération elle-même (elle n'est pas gratuite), la sensibilité au choix de la reward-model et la transférabilité des conclusions au-delà des quatre benchmarks utilisés.
Le travail compte 20 pages et a été soumis à ARR, c'est-à-dire qu'il s'agit pour l'instant d'un préprint de première version, et non d'un résultat évalué par les pairs. Mais la direction semble prometteuse : au lieu de générer davantage et de sélectionner plus durement, on peut gérer plus finement ce que le modèle a déjà conçu.