
Pourquoi décomposer les erreurs du pipeline
Évaluer un système RAG avec un seul chiffre est pratique, mais presque inutile. Une métrique de bout en bout répond à la question « la réponse correspond-elle à l'attente », pas à la question « pourquoi y correspond-elle ou non ». Or le RAG n'est pas un bloc monolithique, mais une chaîne : d'abord quelque chose est trouvé dans la base, puis le système décide si ce qui a été trouvé suffit, et seulement ensuite le générateur rédige le texte. Une défaillance à n'importe quel maillon produit une réponse tout aussi « incorrecte » en sortie, alors que les causes de deux tels échecs peuvent être diamétralement opposées.
C'est précisément ce problème que prend en charge le travail The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753, section cs.CL, soumis le 25 août 2026). Les auteurs — Pius von Däniken, Felix Matthias Saaro, Mark Cieliebak et Jan Deriu — proposent de ne pas mesurer le pipeline dans son ensemble, mais de le décrire comme un modèle probabiliste où chaque étape est une variable aléatoire distincte avec ses propres relations. L'évaluation du système devient alors une tâche d'inférence : quelles valeurs des variables latentes expliquent le plus probablement les réponses observées et l'annotation.
Ce que modélise précisément le cadre bayésien
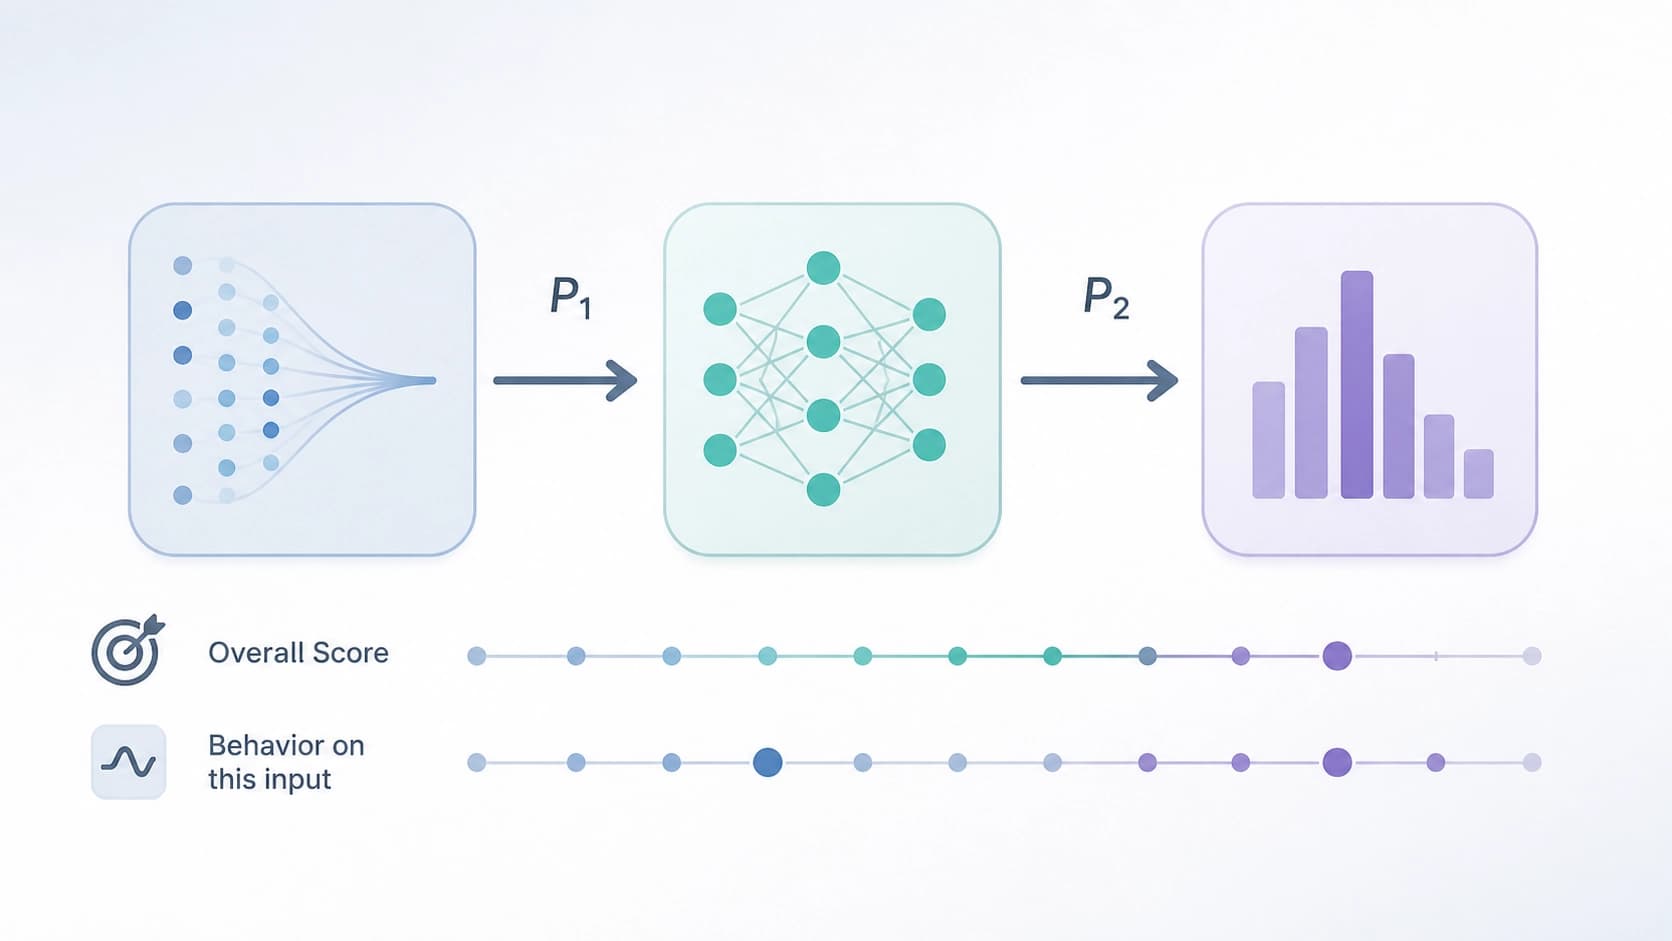
L'idée clé est la factorisation selon le flux d'information. Les variables ne sont pas introduites « par composants du pipeline » de manière mécanique, mais dans l'ordre dans lequel l'information circule réellement dans le système : le succès de la recherche influence la manière dont le générateur doit se comporter, et le comportement du générateur, conjointement avec l'issue de la recherche, détermine l'exactitude finale de la réponse. Une telle structure rend les dépendances explicites, plutôt que cachées à l'intérieur d'une évaluation agrégée.
Ainsi, le modèle The RAT obtient trois couches significatives, qui habituellement se fondent en un seul indicateur.
Task success et generator success — ce sont des questions différentes
La première couche est le task success : l'utilisateur a-t-il finalement obtenu la bonne réponse. La deuxième est le generator success : le générateur s'est-il comporté de manière appropriée compte tenu de ce qu'il a reçu en entrée. Formellement, la seconde est une qualité conditionnelle : dans quelle mesure le comportement du modèle est adéquat pour cette issue de recherche donnée, et non en général.
La différence est fondamentale. Le système peut produire une réponse correcte malgré une mauvaise recherche — le générateur a deviné à partir de sa mémoire paramétrique. Formellement, c'est un succès de la tâche, mais le comportement était incorrect : le système a répondu sans s'appuyer sur les sources, et sur une autre requête cette habitude se transformera en hallucination. Et inversement : la recherche a trouvé tout ce qu'il fallait, le générateur a répondu soigneusement — et le résultat est tout de même incorrect, parce que la question a été mal comprise. La métrique de bout en bout ne distingue pas ces deux cas, la métrique conditionnelle les distingue.
L'abstention — non pas une défaillance, mais une décision
Le troisième élément du modèle est l'abstention behavior, le comportement d'abstention. Dans un contexte RAG, refuser de répondre est parfois la seule réaction correcte : si rien de pertinent ne se trouve dans la base, un honnête « je ne sais pas » vaut mieux qu'une invention assurée. Mais ce même refus devient une erreur lorsque le document nécessaire a été trouvé et que le système ne l'a pas utilisé.
C'est pourquoi l'abstention ne peut être évaluée indépendamment de l'issue de la recherche — seulement de manière conditionnelle. Le modèle The RAT en tient compte directement : il examine si le fait de refuser ou de répondre est cohérent avec ce qui se trouvait réellement dans le contexte. Ce point de vue est également utile pour les décisions produit : si le système s'abstient massivement alors que la recherche est réussie, le problème ne vient pas du générateur, mais de la manière dont le contexte lui est transmis.
Pourquoi les métriques marginales trompent
Les auteurs ont appliqué le cadre à 27 configurations — trois jeux de données, trois retriever et trois générateurs, combinés dans toutes les associations possibles. L'énumération exhaustive n'est pas ici une fin en soi : elle montre comment se comporte la décomposition lorsque exactement un maillon change et que les autres restent en place.
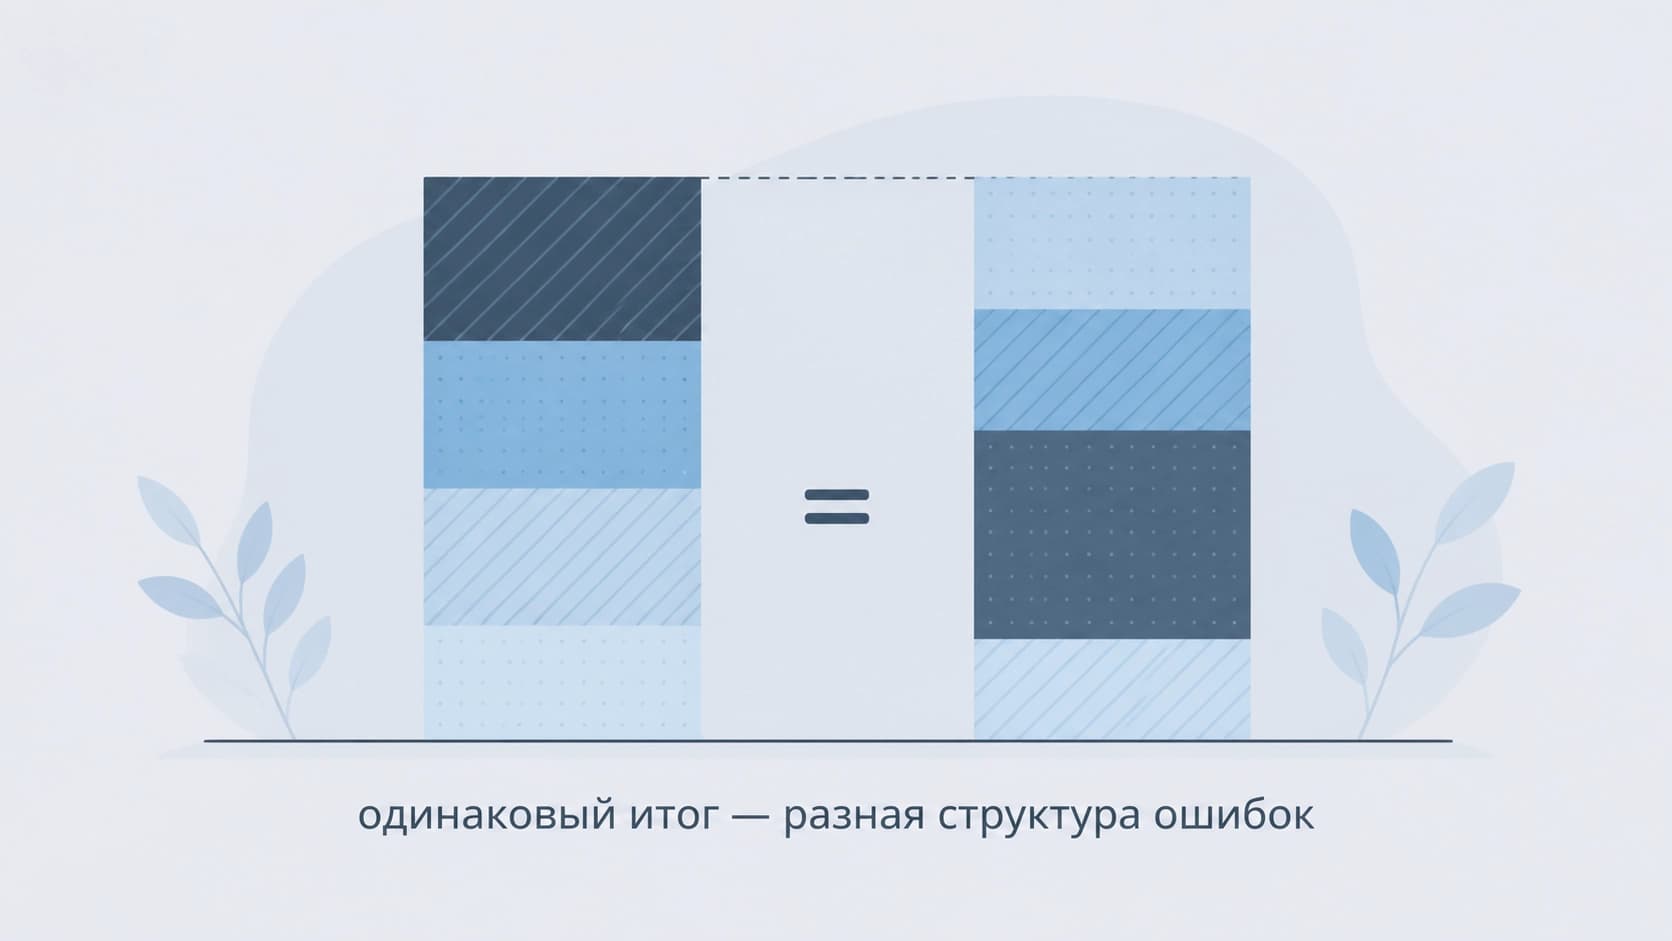
Le résultat pour lequel tout a été entrepris : la décomposition conditionnelle révèle des différences comportementales notables entre des systèmes qui paraissent équivalents selon les métriques marginales. Deux pipelines peuvent afficher la même proportion de réponses correctes et diverger néanmoins de plusieurs dizaines de pourcents sur les cas où ils se trompent précisément — sur la recherche, sur la politique d'abstention ou sur la génération. Pour celui qui choisit une configuration pour un produit, ce sont des systèmes différents ; pour celui qui regarde un seul chiffre dans un tableau, ce sont les mêmes.
Où mettre le budget d'annotation
Une partie distincte du travail est consacrée à la répartition des annotations. L'annotation coûte cher, et il est logique de se demander : si l'on ne peut poser aux personnes qu'une seule question par exemple, quelle question choisir ?
La réponse des auteurs : les annotations sur le succès de la recherche sont plus informatives que les annotations sur le succès de la tâche, si l'objectif est de juger du respect de la politique du système (policy adherence). La raison n'est pas la commodité, mais la structure du modèle : l'annotation de la recherche porte sur une variable située au début de la chaîne causale, c'est pourquoi elle « éclaire » aussi les couches sous-jacentes. L'annotation du succès final porte sur une variable en sortie, et elle en dit bien moins sur ce qui se passait à l'intérieur. Les auteurs donnent à cet effet asymétrique une explication informationnelle.
La conclusion pratique est simple : si le budget est limité, il faut demander aux annotateurs non pas « la réponse est-elle correcte », mais « a-t-on trouvé ce qu'il fallait ». La première sonne mieux dans un rapport, la seconde est plus utile pour le diagnostic.
Le juge LLM comme observation bruitée
La troisième partie est l'extension du modèle aux évaluations automatiques. Le schéma The RAT permet de connecter les verdicts de LLM-as-a-judge non pas comme un substitut à l'humain, mais comme des observations bruitées calibrées : le juge a sa propre probabilité de se tromper, et celle-ci est estimée dans le cadre du même modèle probabiliste.
Cela supprime l'opposition artificielle entre « annotation humaine coûteuse contre évaluation automatique bon marché ». Dans un même modèle, on peut conserver un petit corpus de jugements d'experts, qui fixent l'échelle et la calibration, et un grand flux d'évaluations automatiques, qui affinent les paramètres. Le juge cesse d'être un oracle et devient une source de signal parmi d'autres — avec une erreur connue et, ce qui importe, mesurable.
Ce qu'il faut retenir pour sa propre pratique
- Ne considérez pas le pipeline comme un seul nœud. Dès qu'apparaît dans le rapport une métrique distincte pour la recherche, une autre pour le comportement du générateur et une autre pour l'abstention, les débats « qu'est-ce qui a cassé » se transforment en diagnostic, et non en énumération d'hypothèses.
- Évaluez le comportement de manière conditionnelle. L'exactitude de la réponse et la pertinence du comportement pour un contexte donné sont des questions différentes, et un bon résultat ne justifie pas un mauvais processus.
- Construisez le rapport par segments, et non par moyenne. Deux systèmes ayant la même qualité de bout en bout peuvent exiger des améliorations totalement différentes.
- Choisissez ce qu'il faut annoter. Si la ressource humaine est limitée, l'annotation des étapes précoces donne plus d'informations sur le système dans son ensemble.
- Tenez les évaluations automatiques en laisse. Le juge LLM est utile comme observation assortie d'un modèle d'erreur, et non comme vérité en dernier ressort.
Le point de vue bayésien est précieux ici non par les mathématiques en tant que telles, mais par la discipline de pensée : il oblige à nommer à l'avance quelles grandeurs sont latentes, lesquelles sont observables et comment l'une est liée à l'autre. Après cela, n'importe quel tableau de résultats cesse d'être un ensemble de chiffres et devient la description de la manière dont le système prend ses décisions.


