
En bref : ce qui a été publié
Fin août 2026, l'équipe de LAION a publié LAION-BVD — un corpus vidéo ouvert, décrit dans un préprint comme un jeu de données d'une échelle sans précédent pour l'apprentissage multimodal. Les travaux sont parus sur arXiv le 25 août 2026, dans les rubriques vision par ordinateur, intelligence artificielle et apprentissage automatique.
Les chiffres bruts donnent ceci :
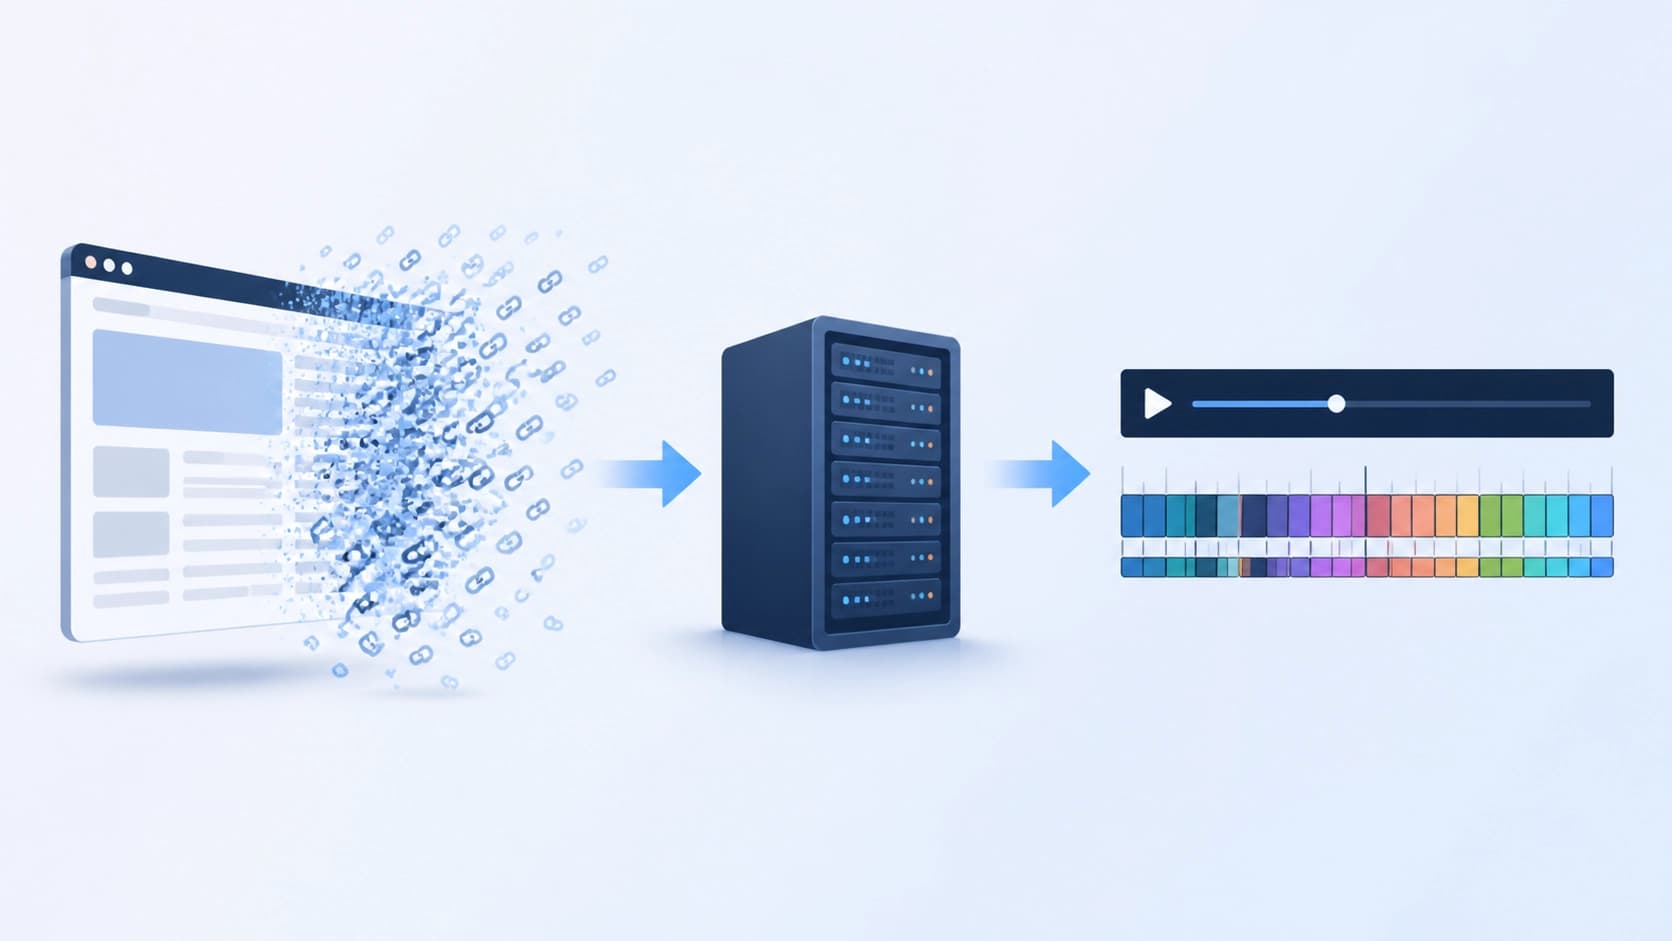
- 1,3 milliard de liens vers des vidéos — point de départ de la collecte, les liens sont extraits du crawl web CommonCrawl et rattachés à des plateformes précises ;
- 80 millions de clips réellement téléchargés via ces liens — tout ce qui figurait dans l'index n'a pas survécu au téléchargement ;
- 10 millions d'heures de durée cumulée.
Ce dernier chiffre est difficile à concevoir : c'est plus de mille ans de visionnage continu. C'est précisément pour cela que cette publication est qualifiée de bascule dans ce qui est réellement accessible aux chercheurs sans budget d'entreprise — auparavant, des corpus vidéo d'un volume comparable restaient enfermés dans des laboratoires privés.
Comment c'est constitué
Des liens aux clips prêts à l'emploi
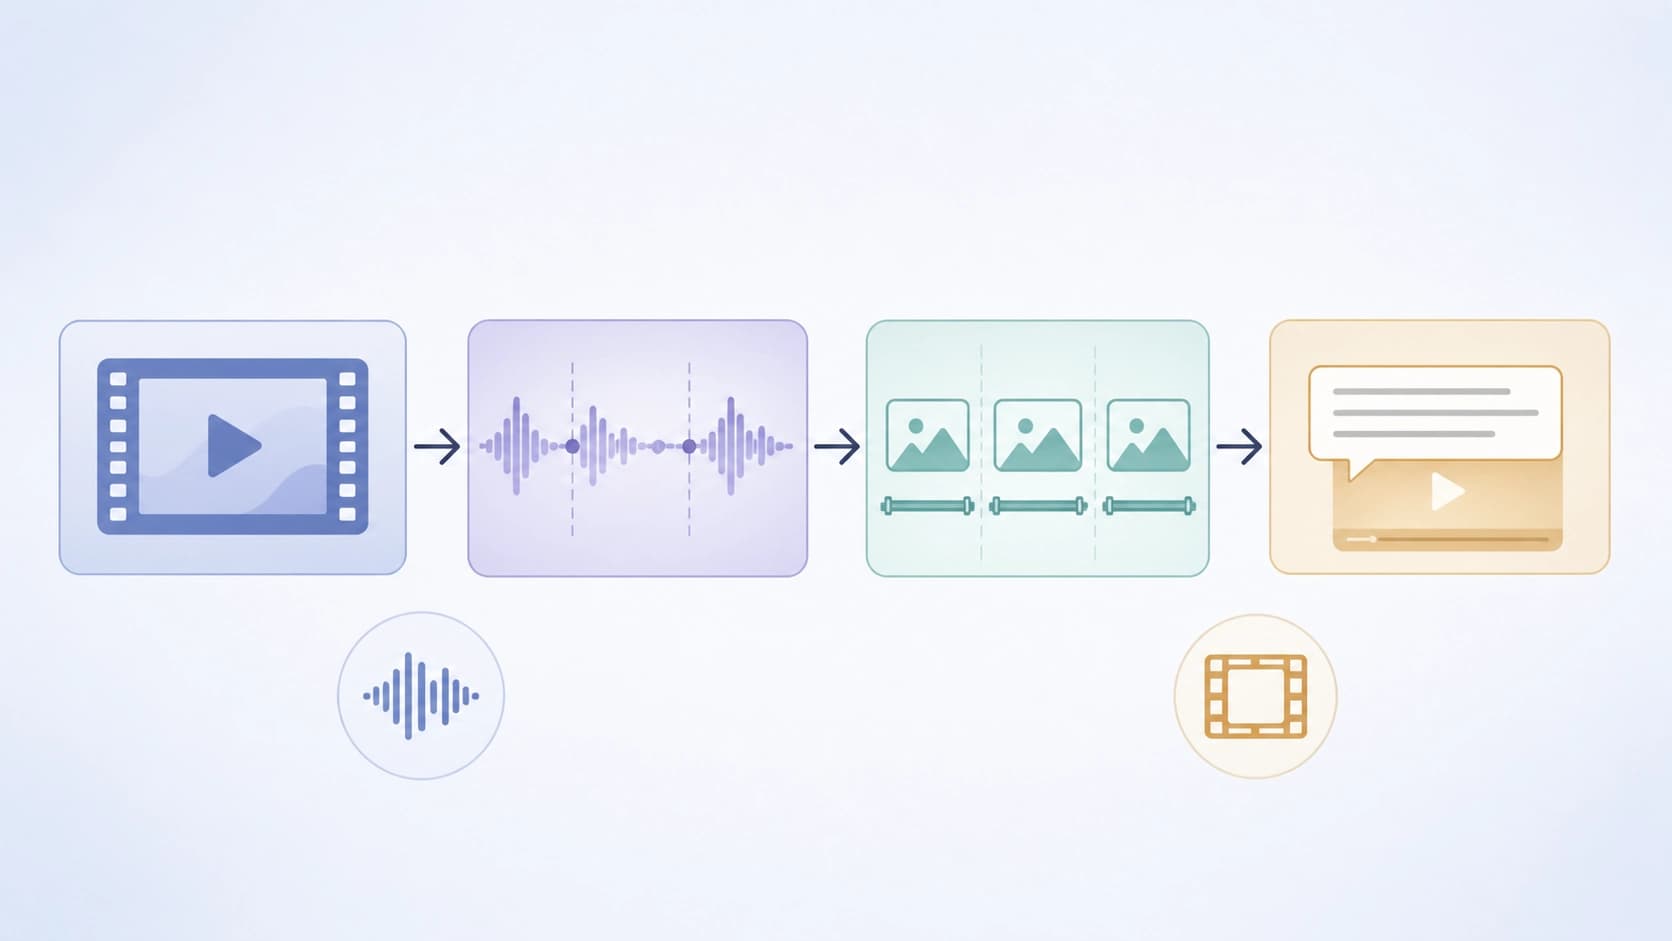
Le pipeline comporte plusieurs étapes, et chacune compte à sa manière. D'abord, les liens sont sélectionnés et normalisés. Ensuite commence le téléchargement massif. Puis entre en jeu une détection de scènes sensible au contenu de l'image : une longue vidéo n'est pas découpée selon un timecode fixe, mais selon les véritables points de montage.
Vient ensuite le plus intéressant. Pour les clips obtenus, les légendes sont générées de manière synthétique, automatique et simultanément dans deux modalités : une paire textuelle associée à l'image et une autre, distincte, associée à la piste audio. Autrement dit, l'audio n'est pas ici un sous-produit, mais un signal d'apprentissage à part entière.
La construction finale est conçue pour le pré-entraînement sur trois types de données à la fois : vidéo, audio et images.
Les images comme ressource à part
Les auteurs ne se sont pas limités aux clips. Des images correspondant au moment du changement de scène sont extraites et fournies comme source autonome de paires « image — texte ». La logique est simple : le flux vidéo offre un autre échantillon du monde visuel que les habituelles collections d'images du web — avec une autre distribution des sujets, des angles de vue et des détails du quotidien. Pour les tâches de recherche d'images, ce décalage de distribution peut s'avérer plus utile qu'un million de photos supplémentaires issues des mêmes sources qu'auparavant.
Ce que montrent les expériences
Vidéo et son
Les modèles entraînés sur le nouveau corpus atteignent un niveau compétitif dans les benchmarks standards sur le couple « vidéo — texte » et « audio — texte ». Plus important encore : lorsque le volume de données ou la taille du modèle augmente, la qualité progresse de façon constante. C'est précisément le signe qui distingue un jeu de données « simplement volumineux » d'un jeu de données qu'il vaut la peine de faire monter en échelle.
Images
Une ligne d'expériences distincte porte sur l'entraînement à partir des images extraites. Là aussi, le résultat est positif : de bonnes performances en recherche d'images. Et cela alors même que la distribution des images diffère nettement des corpus web habituels — autrement dit, le gain ne vient pas du volume en soi, mais de la nature différente des données visuelles.
Ce qu'il faut garder en tête
- Les légendes sont synthétiques : elles économisent des milliers d'heures de travail humain, mais introduisent du bruit et des erreurs systématiques. La qualité du filtrage compte ici davantage que la taille du corpus.
- La collecte part de liens web, ce qui soulève les questions habituelles pour ce type de projet : pérennité des liens, conditions d'utilisation des sources, attribution. Une licence ouverte du jeu de données ne dispense pas de s'interroger sur les sources d'origine.
- Le corpus est annoncé comme une publication de recherche — en pratique, cela signifie que le seuil d'entrée est plus bas que celui des ensembles internes d'entreprise, mais que la reproductibilité des résultats d'autrui devra malgré tout être vérifiée par soi-même.
Pourquoi c'est important
Jusqu'à présent, la vidéo multimodale ouverte à une telle échelle relevait davantage de la promesse que de la réalité : les ensembles académiques se comptaient en milliers d'heures, et tout ce qui se comptait en millions appartenait à des entreprises et ne sortait pas. LAION-BVD change cette arithmétique — et avec elle, le niveau d'exigence pour ceux qui construisent leurs propres modèles.
Les conséquences pratiques sont multiples. Premièrement, une base pour des comparaisons honnêtes apparaît : si tout le monde s'entraîne sur le même corpus ouvert, les débats sur la supériorité d'un résultat deviennent plus substantiels. Deuxièmement, les petites équipes et les universités disposent d'une alternative à la location d'embeddings tiers — elles peuvent entraîner les leurs. Troisièmement, l'audio cesse d'être un appendice de la vidéo et obtient sa propre ligne d'apprentissage.
La question principale n'est désormais plus de savoir si les données suffisent, mais qui apprendra le premier à les nettoyer. Les légendes synthétiques, des dizaines de millions de clips et les déchets inévitables dans l'échantillon font du filtrage et de l'évaluation de la qualité le goulot d'étranglement de toute l'entreprise. Le jeu de données est ouvert — la suite dépend de la communauté.


