
Ce qu’est SEATauBench
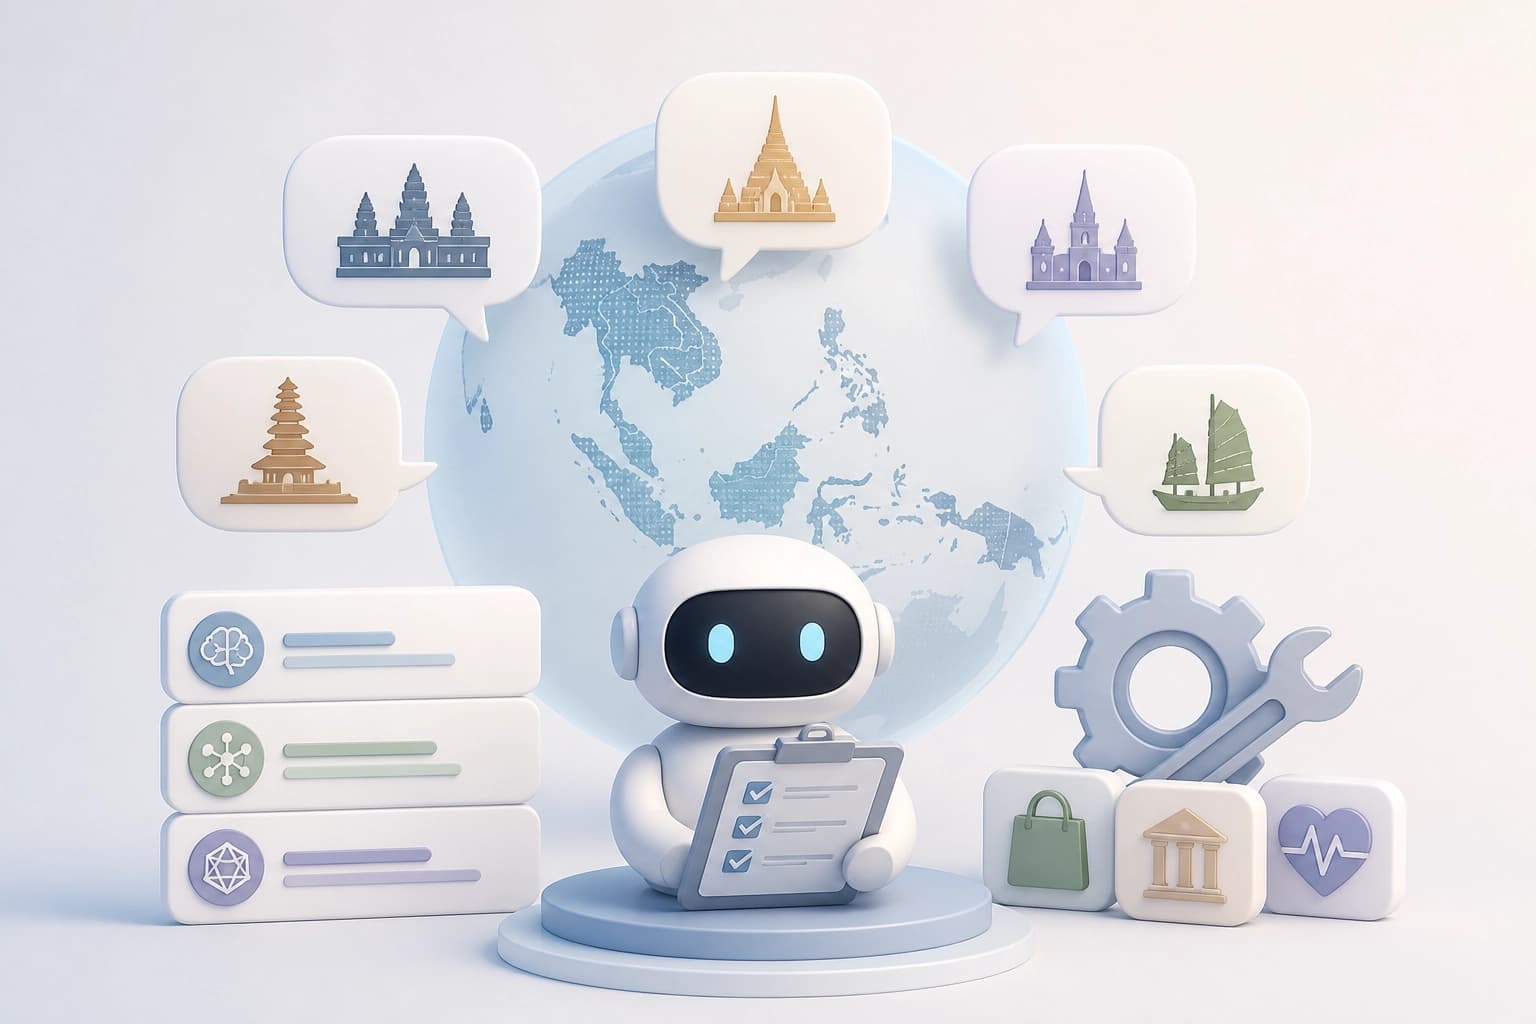
SEATauBench est le premier système d’évaluation axé sur les agents pour l’IA souveraine en Asie du Sud-Est. Il adapte Tau2-Bench à cinq langues : le chinois (mandarin), le vietnamien, le thaï, l’indonésien et le philippin.
Ce benchmark est conçu pour évaluer les agents dans les contextes linguistiques et thématiques de la région. Le critère pratique pour déterminer s’il convient est la correspondance entre les langues évaluées et le public cible.
Quelles conditions changent lors de l’évaluation
Les chercheurs localisent progressivement le contexte de travail de l’agent. Ils modifient trois éléments :
- la langue d’interaction entre l’utilisateur et l’agent ;
- les spécifications des outils ;
- les domaines thématiques des tâches.
Cette conception permet de tester non seulement le changement de langue du dialogue. Elle couvre également les changements d’outils et de thèmes des tâches.
Ce que montrent les résultats
L’étude a évalué trois modèles. Les auteurs ont comparé l’évolution des capacités des agents selon différents niveaux de localisation.
| Conditions d’évaluation | Résultat |
|---|---|
| Seule la langue du dialogue change | Les capacités en anglais sont assez bien transférées |
| Un contexte supplémentaire est localisé | La qualité et la robustesse diminuent fortement |
| Le domaine thématique est entièrement adapté | Les pertes les plus importantes sont observées |
Les auteurs soulignent qu’une évaluation menée uniquement en anglais ne prédit que dans une mesure limitée les capacités des agents dans les langues d’Asie du Sud-Est. Les résultats des tests en anglais ne remplacent donc pas une évaluation dans des conditions localisées.
À quoi sert le benchmark
SEATauBench est présenté comme un benchmark diagnostique et un pipeline d’adaptation réutilisable. Il est conçu pour créer des agents multilingues fiables.
Lors du choix d’une évaluation, l’étendue de la localisation est importante : langue du dialogue, spécifications des outils et domaines thématiques. Tester uniquement le changement de langue ne reflète pas les résultats d’une adaptation complète du contexte.
Publication et versions
L’article a été publié dans EMNLP Findings 2026. La version v1 a été soumise le 27 juin 2026, et la dernière révision, v2, a été publiée le 5 septembre 2026.
Identifiant de l’article : arXiv:2606.28715.


