
Comment les spikes modifient le traitement des poids
Dans l’article «Spike-Aware INT8 Execution for Spiking Language Models on Commodity CPUs» Ting Liu décrit le décodage d’un modèle de langage impulsionnel sur CPU.
- Les activations impulsionnelles binaires permettent de ne lire que les colonnes de poids actives.
- Les multiplications sont remplacées par des sommes de poids.
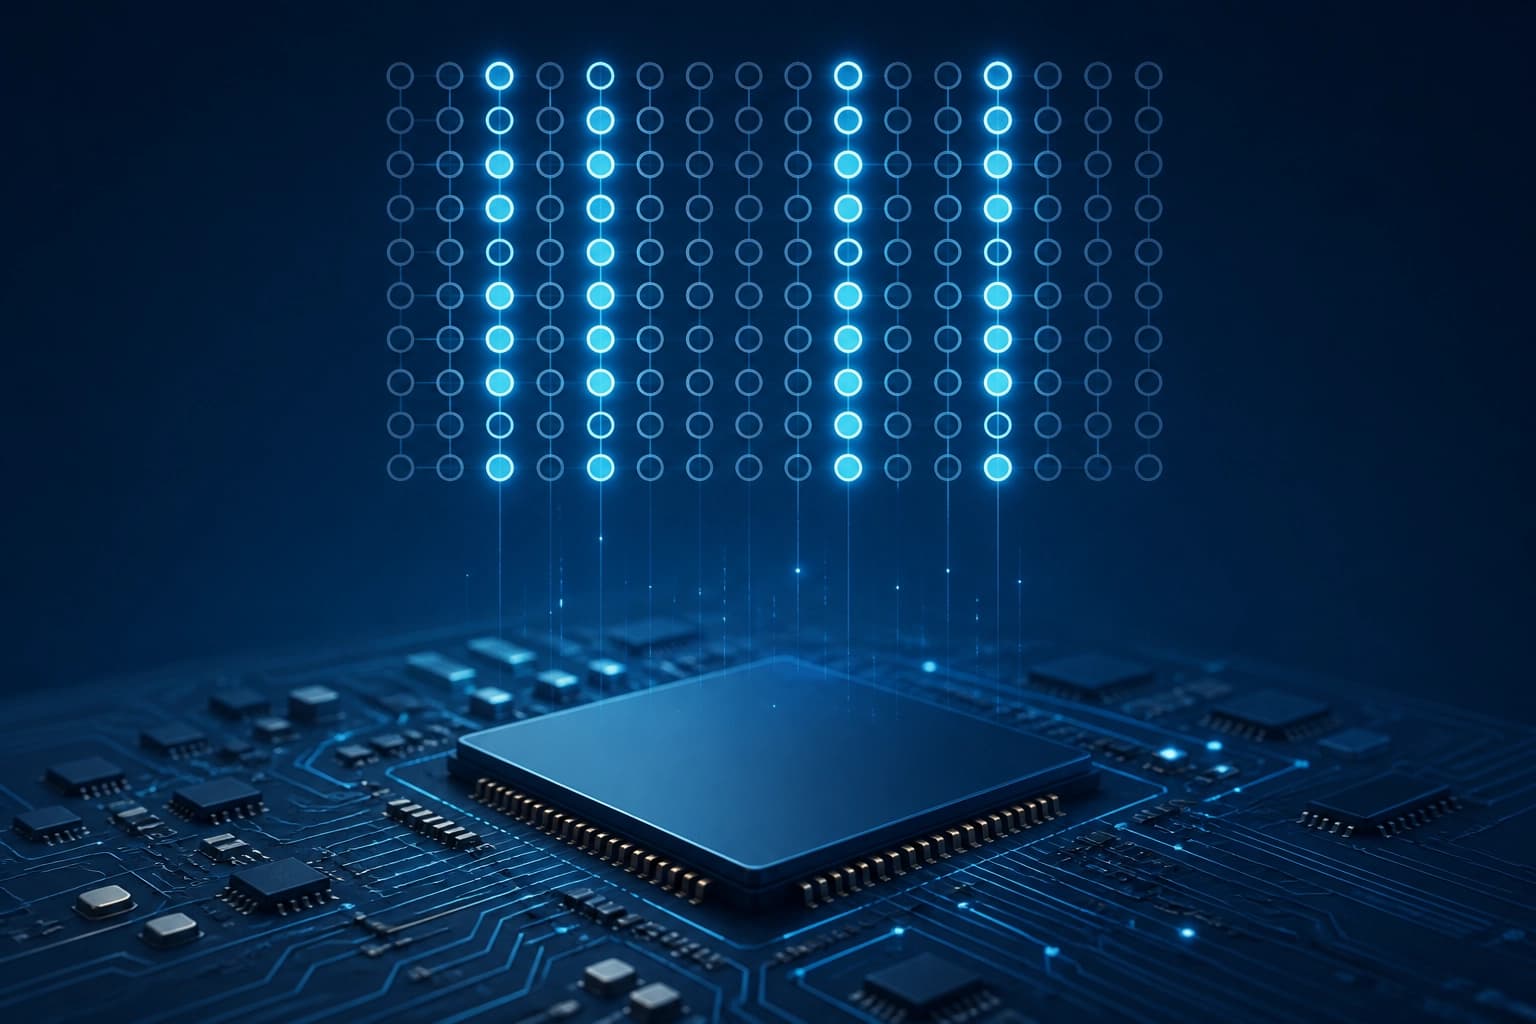
En pratique, cette approche consiste à ne pas traiter les colonnes qui ne se sont pas activées. Le gain dépend de la parcimonie des activations, et pas seulement du format des poids.
Comment fonctionne le chemin INT8
L’implémentation en C++ a été testée sur un modèle de langage à porte impulsionnelle de 874M paramètres. Elle utilise différents modes pour les projections parcimonieuses et denses.
- Dans les projections parcimonieuses, les poids INT8 sont stockés au format column-major.
- L’accumulation s’effectue en nombres entiers, et l’échelle est appliquée une seule fois pour chaque canal de sortie.
- Dans les projections denses, l’accès row-major et les activations FP32 sont conservés.
Il s’agit d’un schéma mixte, et non d’une conversion de toutes les opérations du modèle en INT8. Le critère de choix consiste à déterminer s’il est acceptable de conserver le format FP32 pour les projections denses afin de bénéficier du chemin INT8 parcimonieux.
Quels résultats de vitesse et de stockage sont rapportés
Un checkpoint préliminaire a été comparé sur un seul thread. Dans ce test, INT8 a affiché un débit de décodage supérieur et un volume de stockage des poids inférieur.
| Checkpoint préliminaire, un thread | Vitesse de décodage | Stockage des poids |
|---|---|---|
| FP32 | 9.82 tokens/s | 3355.2 MiB |
| INT8 | 23.31 tokens/s | 1087.4 MiB |
Des résultats distincts sont indiqués pour le checkpoint final sur AMD Ryzen 7 5800X. Les conditions diffèrent de celles de la comparaison du checkpoint préliminaire.
| Mode INT8 du checkpoint final | Mesure |
|---|---|
| Décodage, un thread | 22.63 tokens/s |
| Décodage, quatre threads | 47.90 tokens/s |
| Préremplissage d’une séquence de 512 tokens, huit threads | 94.68 tokens/s |
Ces mesures ne peuvent pas être regroupées directement dans un même tableau comparatif : elles concernent des checkpoints et des modes différents. Pour évaluer le débit, la version du checkpoint et le nombre de threads sont tous deux importants.
Ce que change la variante INT4
La variante INT4 pour les projections denses réduit le volume de stockage de 17.4 % supplémentaires. Le débit de décodage diminue toutefois de 46.6 %.
La version corrigée de l’article retire les résultats invalides pour le mode INT4 pur. Le compromis indiqué concerne donc INT4 dans les projections denses, et non un modèle entièrement en INT4.
Le critère de choix consiste à privilégier le stockage au détriment de la vitesse de décodage. Les résultats du mode INT4 pur ne peuvent pas servir de preuve de performance.
Ce que l’on sait de la consommation d’énergie
Dans une étude distincte de la tête de sortie sur ARM, les mesures ont révélé des niveaux de consommation d’énergie plus élevés pour deux configurations de vérification des candidats, sur une fenêtre de décodage tronquée.
La version corrigée de l’article ajoute également une validation numérique et une étude de la consommation d’énergie mesurée à la prise sur ARM. Les données des tests de vitesse sur CPU ne suffisent pas pour conclure à des économies d’énergie.


