
Architecture de l’assistance à partir de millions de dialogues : séparer la recherche, les actions et la génération
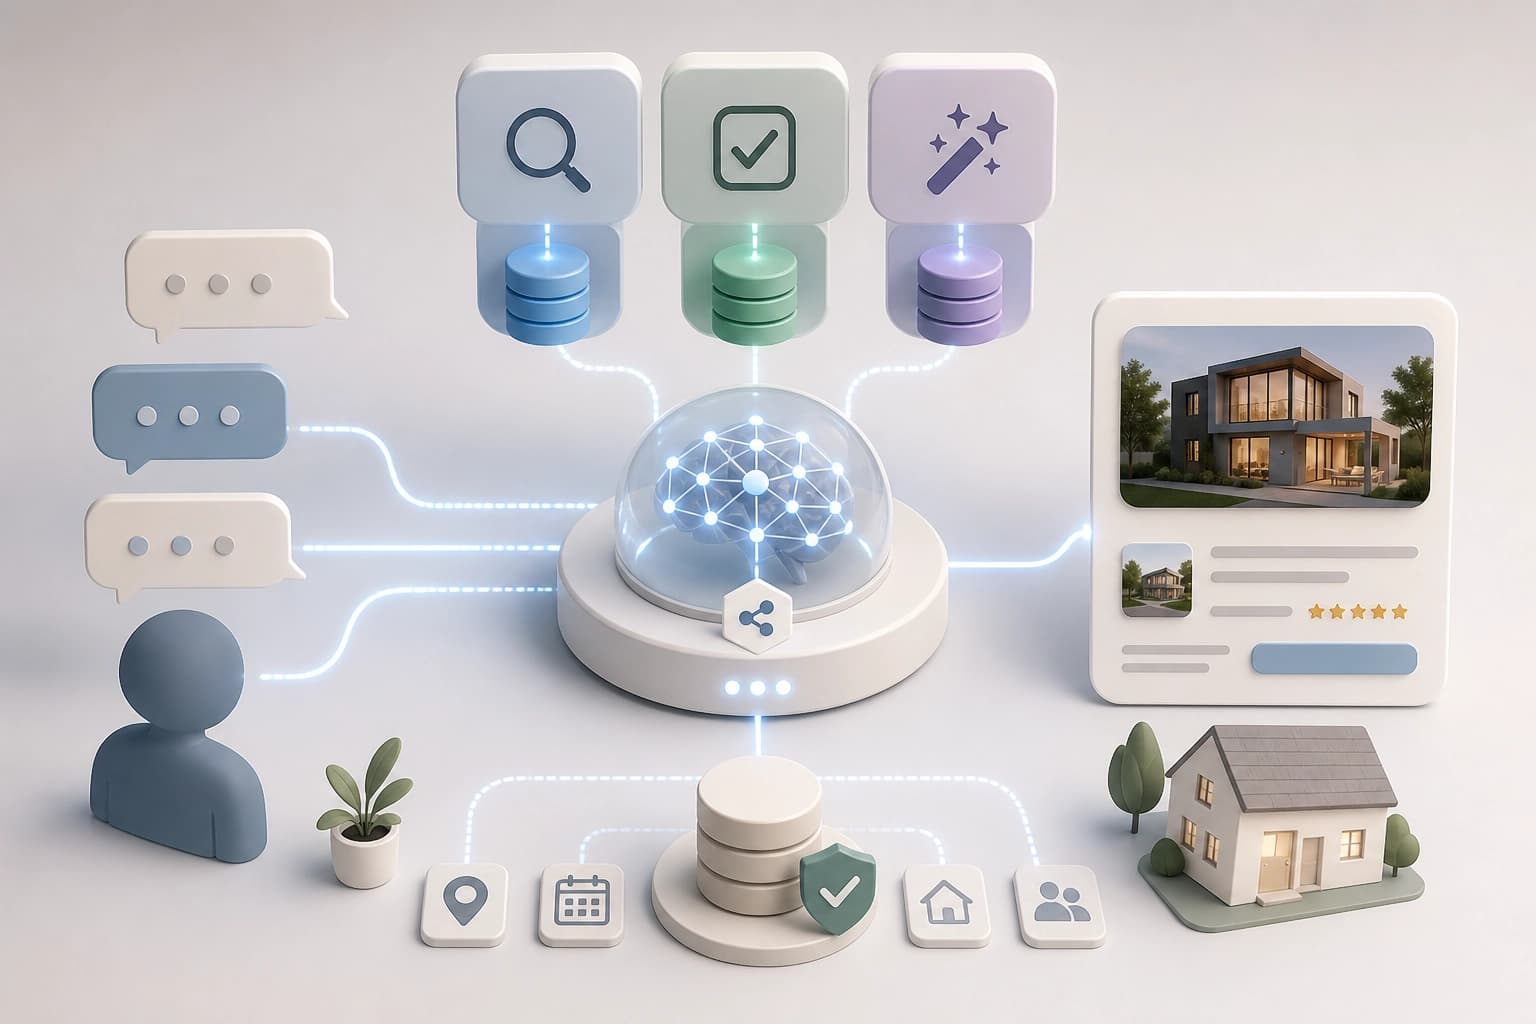
À partir de l’exemple d’un service de réservation de logements, les auteurs analysent le passage d’un modèle unique à un orchestrateur limité d’opérations typées et à un générateur s’appuyant sur un contexte vérifié ; les effets de l’architecture sont évalués séparément des changements connexes. Dans les dialogues rejoués, la précision du choix de réservation a augmenté, les erreurs dans les actions structurées ont disparu et les escalades ont diminué ; l’optimisation a également réduit la latence et les coûts d’utilisation du modèle, tandis que le volume de transferts de dialogues aux opérateurs en production n’a pas sensiblement changé.
Échelle et limites de l’évaluation
Le système d’assistance d’une grande marketplace de logements traite des millions de dialogues par mois. Il fonctionne dans 11 langues, et le P90 indiqué est de 10 secondes. Ces chiffres décrivent l’échelle du système, mais ne montrent pas l’effet d’une décision architecturale particulière.
| Paramètre | Valeur |
|---|---|
| Volume | Des millions de dialogues par mois |
| Langues | 11 |
| P90 | 10 secondes |
La migration a également entraîné des changements au niveau des prompts, de l’alignement et du serving. Les auteurs n’attribuent donc à l’architecture que les effets mesurés sur des dialogues reproduits à l’identique.
Critère d’évaluation : comparer les architectures sur des dialogues d’entrée identiques, plutôt que de leur attribuer tous les changements survenus après la migration.
Comment la recherche, les actions et la génération sont séparées
Dynamic Response (DR) remplace le système de réponse hybride Qwen3-235B-A22B par un orchestrateur ReAct à périmètre limité, doté d’outils typés et d’un générateur plus petit. Le générateur construit la réponse à partir d’un contrat de contexte validé par le système backend.
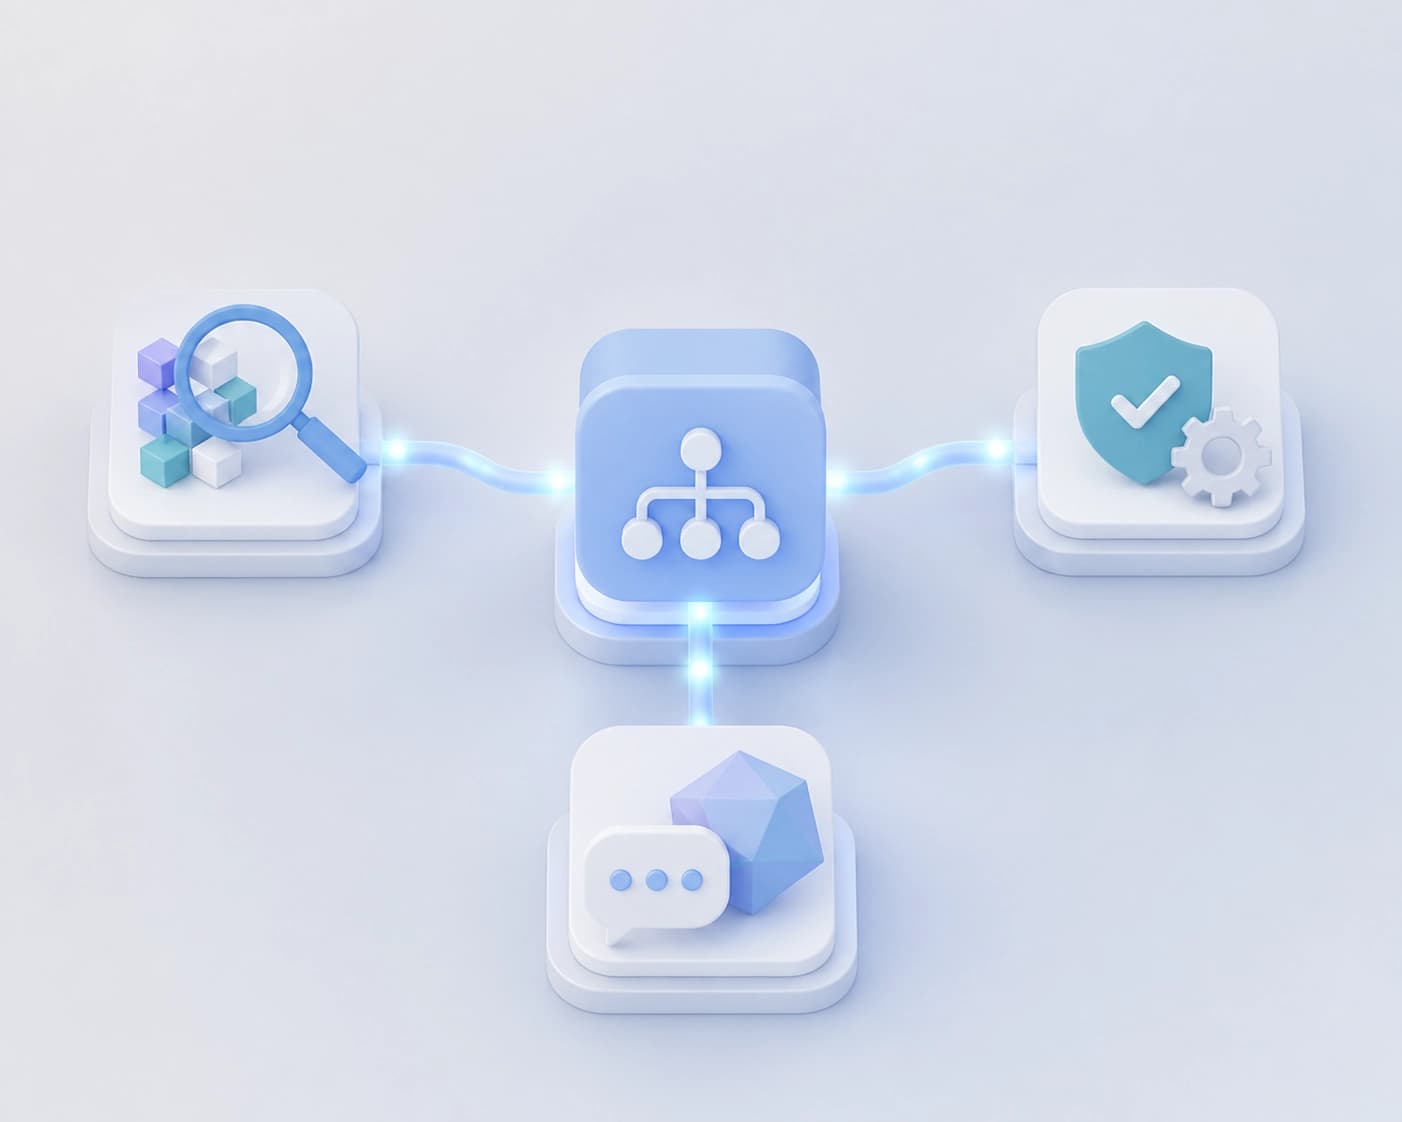
| Partie du système | Rôle |
|---|---|
| Recherche | Sélection typée de l’entité, y compris la sélection d’une réservation |
| Actions | Identifiants d’action typés et vérification de leur appartenance |
| Génération | Réponse fondée sur un contrat de contexte validé par le système backend |
| Orchestration | Orchestrateur ReAct à périmètre limité, s’appuyant sur des outils typés |
Cette séparation distingue la sélection de l’entité et des actions de la formulation de la réponse. Critère de choix : cette architecture convient lorsque le système doit effectuer des opérations vérifiables, et pas seulement générer une réponse unique.
Ce qui a changé dans la sélection des entités et des actions
La sélection typée des entités a fait évoluer le sélecteur de réservation vers une priorité donnée à la précision. La précision a augmenté, tandis que le rappel a diminué. La vérification de l’appartenance des identifiants typés a éliminé les erreurs observées dans les actions structurées.
| Métrique | Avant | Après |
|---|---|---|
| Précision de la sélection des réservations | 8,3 % | 89,1 % |
| Rappel de la sélection des réservations | 75,2 % | 67,3 % |
| Hallucinations observées dans les actions structurées | 2,14 % | 0,0 % |
Les résultats montrent un compromis entre la précision et le rappel de la sélection. Critère de choix : ce mode est adapté lorsqu’il est plus important d’éviter une sélection erronée que de préserver le niveau de rappel précédent.
Comment évaluer les escalades et le libre-service
Un test A/B de bas niveau a reproduit lors du replay la baisse des escalades. Dans le même temps, le volume des transferts vers des agents en production est resté globalement stable.
| Indicateur | Avant | Après |
|---|---|---|
| Réponses avec escalade ferme | 5,60 % | 3,08 % |
| Réponses avec escalade souple | 9,56 % | 2,49 % |
| Résolution autonome | — | Tendance à la hausse : +5,1 points de pourcentage ; IC à 95 % : de −2 à +12 |
La baisse des escalades ne s’est pas accompagnée d’une diminution comparable du volume des transferts vers des agents. Les auteurs décrivent la résolution autonome comme une tendance, et non comme une hausse clairement établie.
Critère d’évaluation : suivre séparément les réponses avec escalade, les transferts effectifs vers des agents et la résolution autonome.
Résultats de l’optimisation du serving
Les optimisations du serving ont réduit le P90 de latence de l’orchestrateur de 3,87 à 2,24 secondes. Dans le même temps, l’empreinte GPU a diminué d’environ un tiers.
| Indicateur | Évolution |
|---|---|
| P90 de latence de l’orchestrateur | 3,87 → 2,24 secondes |
| Empreinte GPU | Baisse d’environ un tiers |
| Coût annuel estimé du serving des modèles en auto-hébergement | Baisse de plus d’un ordre de grandeur |
Ces indicateurs concernent le serving, et non la qualité de la sélection des entités ou des actions. Critère d’évaluation : examiner séparément la latence, l’empreinte de calcul et le coût du serving des métriques de réponse.
Foire aux questions
Matériaux connexes
Tous matériaux
Vérification des hallucinations des LLM via une vue SQL des sources, sans réentraînement
Ce travail évalue si un LLM peut mobiliser une compétence symbolique élémentaire — la création d’une base SQL à partir des documents sources — afin d’ancrer les réponses dans leurs sources sans supervision pour détecter les hallucinations. Sur RAGTruth et DiaHalu, ce pipeline neuro-symbolique se révèle plus précis que la prédiction directe et comparable aux méthodes de pointe, sans nécessiter de réglage fin spécifique au domaine.
9 novembre 2026
MathAdv : ce que cache la précision finale des preuves automatiques
Un ensemble de tâches diagnostiques couvrant 13 domaines des mathématiques universitaires et de troisième cycle évalue les systèmes de démonstration automatique dans Lean 4 non seulement sur le résultat final, mais aussi sur leur maîtrise des sujets, la qualité de leurs raisonnements informels et leur robustesse face aux reformulations des énoncés. L’analyse par composante montre que la formalisation des problèmes reste le principal obstacle et que la réussite dépend fortement du domaine mathématique et de la manière dont le problème est formulé.
9 novembre 2026
AffordanceWAM : les affordances comme intermédiaire entre la prédiction de scène et le contrôle du manipulateur
Ce travail présente un modèle génératif qui prédit simultanément les futures observations RGB, les champs scalaires, les cartes thermiques d’affordances et les commandes continues du robot, en s’appuyant sur des vidéos humaines pour diversifier les interactions sans annotations d’actions ni retargeting. Sur RoboCasa, CALVIN ABC→D et des tâches réelles, cette approche offre des gains constants par rapport aux modèles de référence entraînés uniquement sur des données RGB ou robotiques.
9 novembre 2026