Problème : du code qui s'exécute, mais qui fait autre chose
Les agents basés sur de grands modèles de langage savent déjà prendre un article scientifique et en produire un dépôt fonctionnel. Le problème, c'est que « fonctionnel » et « reproductible » ne sont pas synonymes. Un script peut passer tous les tests avec succès, entraîner un modèle et afficher une belle métrique, alors qu'à l'intérieur, l'ordre des étapes a été discrètement inversé, un facteur a disparu de la fonction de perte ou un substitut a été mis à la place d'une étape non triviale.
C'est précisément ce mode de défaillance que les auteurs d'un nouveau travail appellent dérive sémantique (semantic drift) : le code généré s'écarte silencieusement de ce qui est décrit dans la spécification de l'article. L'erreur ne saute pas aux yeux — elle vit dans les détails que personne ne vérifie automatiquement. Résultat : une reproduction qui a formellement eu lieu, mais qui ne confirme rien sur le plan scientifique.
Ce qu'est SA-Bench
Pour mesurer la dérive, il faut d'abord la rendre observable. C'est le rôle de SemanticAlign-Bench, abrégé SA-Bench — un benchmark diagnostique décrit dans l'article arXiv:2608.24252 (accepté dans les Findings of EMNLP 2026, auteurs — Xue Hu, Zewei Pan, Zeli Su, Zhou Liu et Wentao Zhang).
Le matériel couvre 30 travaux issus des conférences ICLR, ICML et NeurIPS 2025 et se répartit sur cinq domaines de l'apprentissage automatique. Ce ne sont pas les « impressions » laissées par le code qui sont évaluées, mais un ensemble d'affirmations vérifiables. Au total, le benchmark rassemble 1 491 affirmations de ce type.
Semantic Alignment Units : les atomes de la spécification
L'idée méthodologique clé consiste à décomposer la description de l'article en éléments les plus fins possibles, vérifiables manuellement à partir du dépôt. Ces éléments sont appelés Semantic Alignment Units (SAU). Chaque unité est une affirmation distincte sur l'implémentation : un hyperparamètre précis, une formule, un ordre d'opérations, une condition d'arrêt, un schéma de découpage des données.
Cette approche granulaire est importante, car elle prive l'évaluation de sa binarité « réussi / échoué ». Au lieu d'une seule case à cocher par article, on obtient une centaine de petites questions, et l'on voit précisément où l'implémentation a flanché.
Quatre dimensions de la dérive
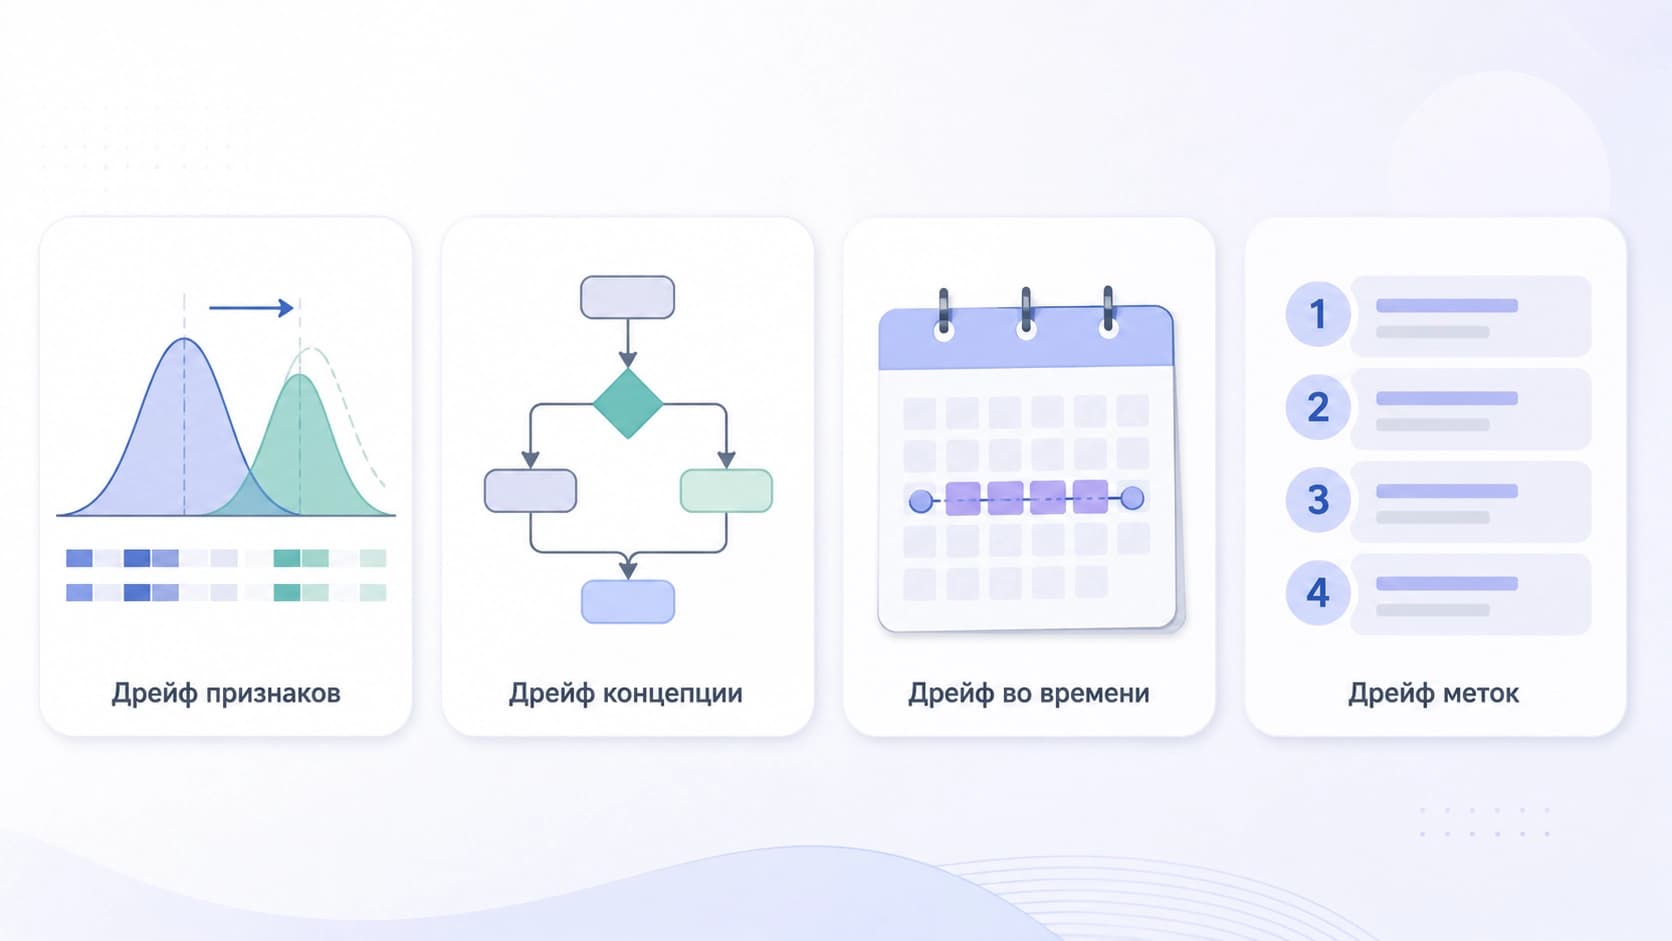
Chaque dépôt est évalué selon quatre axes diagnostiques :
- dérive numérique — les valeurs des coefficients, des dimensions, des seuils et d'autres grandeurs ne correspondent pas à la spécification ;
- dérive méthodologique — la procédure d'entraînement ou de calcul elle-même est structurée autrement que prévu dans le travail ;
- dérive protocolaire — le schéma expérimental est enfreint : découpage de l'échantillon, conditions de comparaison, protocole d'évaluation ;
- dérive d'ordre — les étapes sont exécutées dans un ordre incorrect, ce qui change le résultat.
Cette séparation des axes a un intérêt pratique : le développeur ne voit pas un « qualité faible » abstrait, mais un type précis de défaillance.
Résultats : 0,301 comme plafond
Les auteurs ont testé 12 configurations de générateurs — quatre modèles combinés à trois échafaudages. Chaque évaluation était mesurée en fractions de l'unité.
Les chiffres se sont révélés sobres. Le meilleur résultat a été obtenu par l'association Claude et PaperCoder — en moyenne 0,301 point SAU sur 1,0 possible. La moyenne générale sur les 360 évaluations est de 0,221.
Autrement dit, même la configuration la plus performante n'exécute correctement que moins d'un tiers de ce qu'exige la spécification. Pourtant, les modèles n'ignorent pas les exigences : la taxonomie des défaillances montre que les agents tentent généralement de couvrir la plupart des points, mais les implémentent incorrectement. L'essentiel des affirmations mises à zéro provient de deux scénarios — l'inadéquation entre l'implémentation et l'intention (implementation mismatch) et les substituts (stubs), c'est-à-dire les endroits où une formalité vide remplace la véritable logique.
Ce profil d'erreurs révèle quelque chose d'important : le problème n'est ni la paresse de l'agent, ni le fait qu'il n'aurait pas « lu jusqu'au bout » l'article. Le problème, c'est qu'il reproduit avec assurance une version plausible, mais erronée.
L'exécutabilité n'équivaut pas à la fidélité scientifique
Une conclusion distincte du travail concerne la structure des échafaudages actuels. Ceux qui sont optimisés pour l'exécutabilité — pour que le code s'exécute simplement sans planter — n'apportent qu'un gain limité pour la reproduction scientifique. C'est logique : un lancement réussi vérifie la syntaxe et la présence des dépendances, mais ne dit rien sur la concordance entre la logique et l'intention des auteurs.
Pour réduire l'écart, il faut des échafaudages d'un autre type — ceux qui placent au premier plan la vérification des spécifications sémantiques. Autrement dit, l'agent ne doit pas simplement écrire et exécuter du code, mais confronter chaque étape à une affirmation de l'article et être capable de prouver qu'il y a bien concordance.
Ce que cela change en pratique
SA-Bench n'est pas une compétition entre modèles, mais un outil diagnostique. Sa valeur réside dans le fait qu'il déplace la discussion sur la reproductibilité du plan « ça marche / ça ne marche pas » vers celui de « à quel point cela correspond précisément ». Le benchmark, les annotations et le pipeline d'évaluation sont en accès libre, de sorte que la méthodologie peut aussi s'appliquer à ses propres tâches — par exemple, pour vérifier des pipelines internes de génération de code à partir de cahiers des charges, et pas seulement à partir d'articles scientifiques.
Pour ceux qui construisent des agents, la conclusion est la suivante : accroître l'« intelligence » du générateur sans couche de vérification distincte se heurte à un plafond. La dérive sémantique n'est pas un bug propre à un modèle donné, mais une propriété de l'approche dans laquelle personne ne vérifie la correspondance sémantique. Et tant qu'une telle couche n'existera pas, la reproduction de code de recherche restera une tâche où l'humain doit encore lire chaque ligne.