Un produit ne se réduit pas à un point dans l'espace
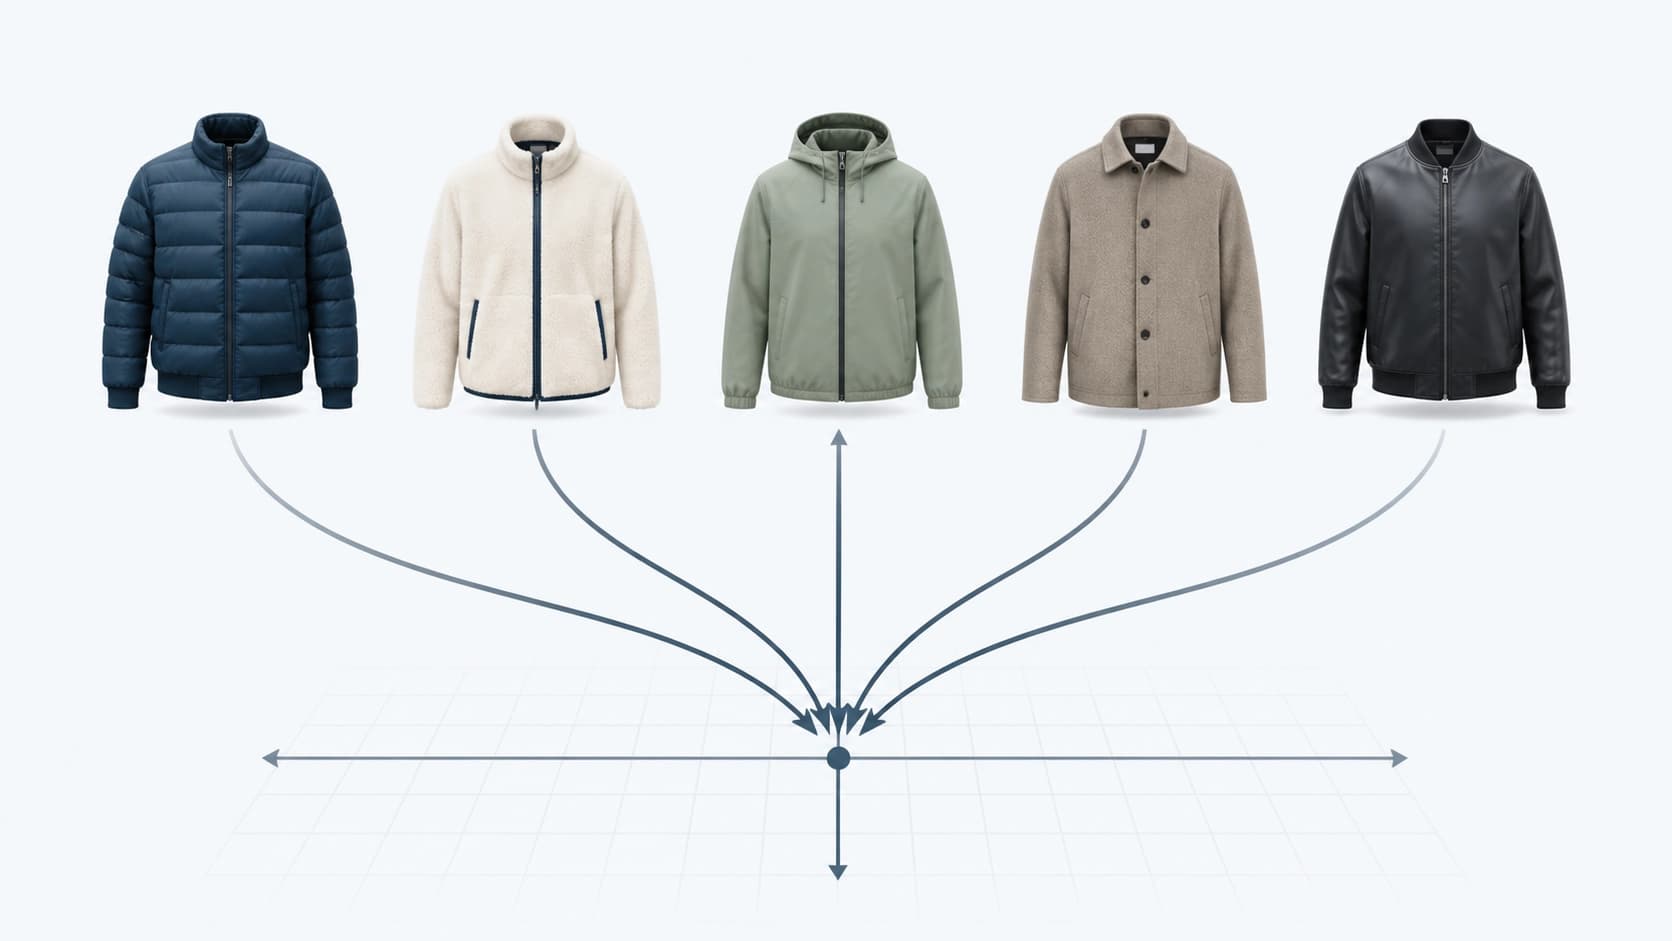
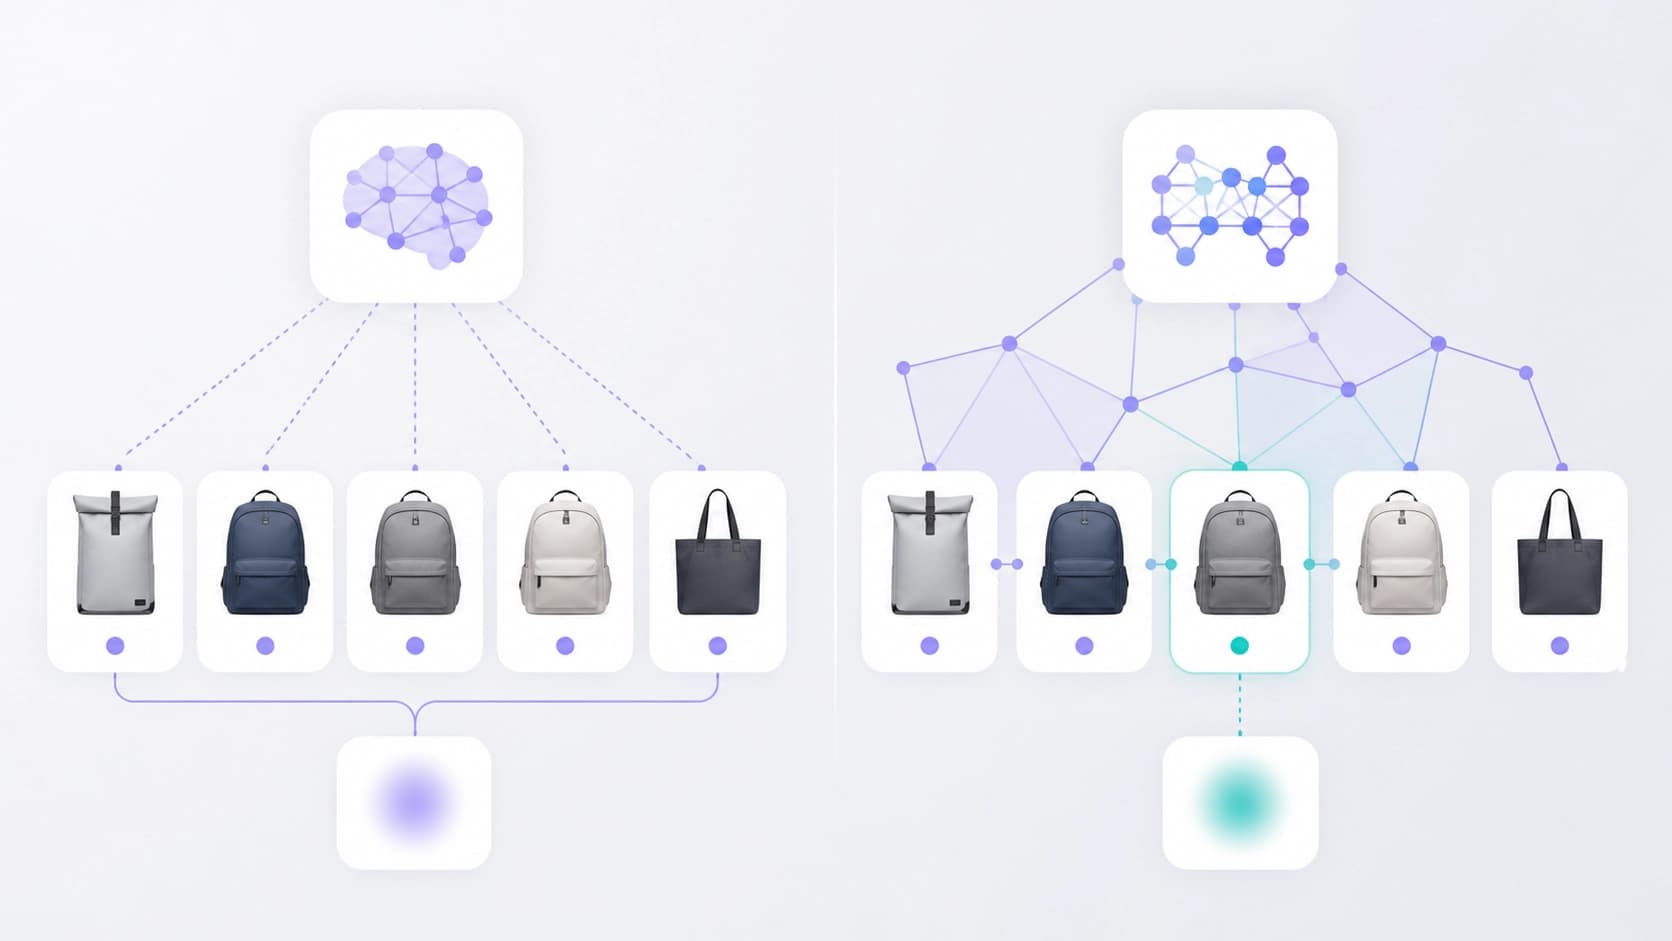
Les grands modèles de langage multimodaux sont parvenus à plutôt bien « comprendre » les fiches produits : ils relient la photographie, le nom et la description en un champ sémantique unifié. Mais ce schéma comporte un coût caché. L'information sur le produit est compressée en un seul embedding global — un vecteur moyenné où les détails se dissolvent. Plus le modèle s'efforce de tout englober d'un coup, moins il reste de spécificité dans le vecteur final.
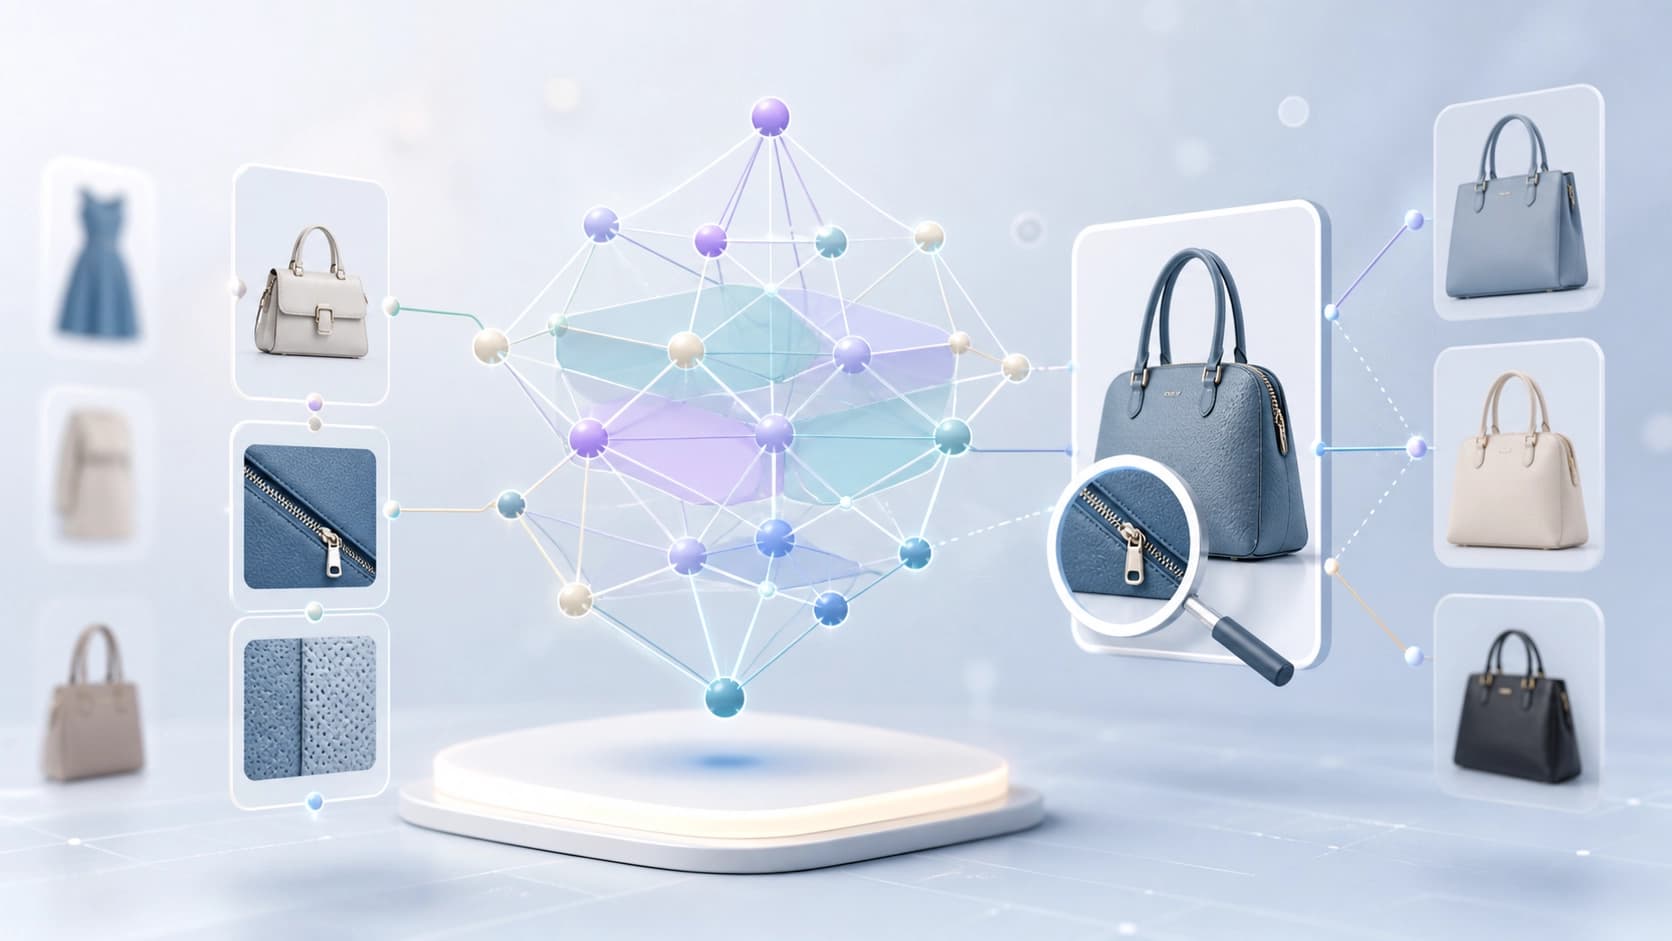
Le prix de cette compacité se voit sur les tâches où ce sont justement les détails qui comptent. Deux vestes de matériaux différents, deux mugs à la glaçure presque identique, deux câbles aux connecteurs différents — visuellement, ce sont presque des jumeaux, et dans l'espace des embeddings, ils se retrouvent presque au même point. Or l'utilisateur ne cherche pas « quelque chose de similaire », mais un matériau précis, une compatibilité ou une caractéristique. C'est précisément sur ce type de requêtes que la moyennisation commence à gêner : le modèle ne distingue pas les attributs, et donc le classement reste approximatif.
L'article arXiv:2608.24467 (Qiuyu Zhu, Yi Gao, Zhichao Wan, Mingyang Ma, août 2026) pose le diagnostic sans détour : les embeddings globaux encodent implicitement le produit dans son ensemble, ce qui limite la capture d'attributs à granularité fine. Cela se soigne-t-il par un simple « faisons un vecteur plus grand » ? À en juger par la logique du travail — non, le problème n'est pas dans la dimensionnalité, mais dans le mode de représentation.
Un hypergraphe au lieu d'une liste plate d'embeddings
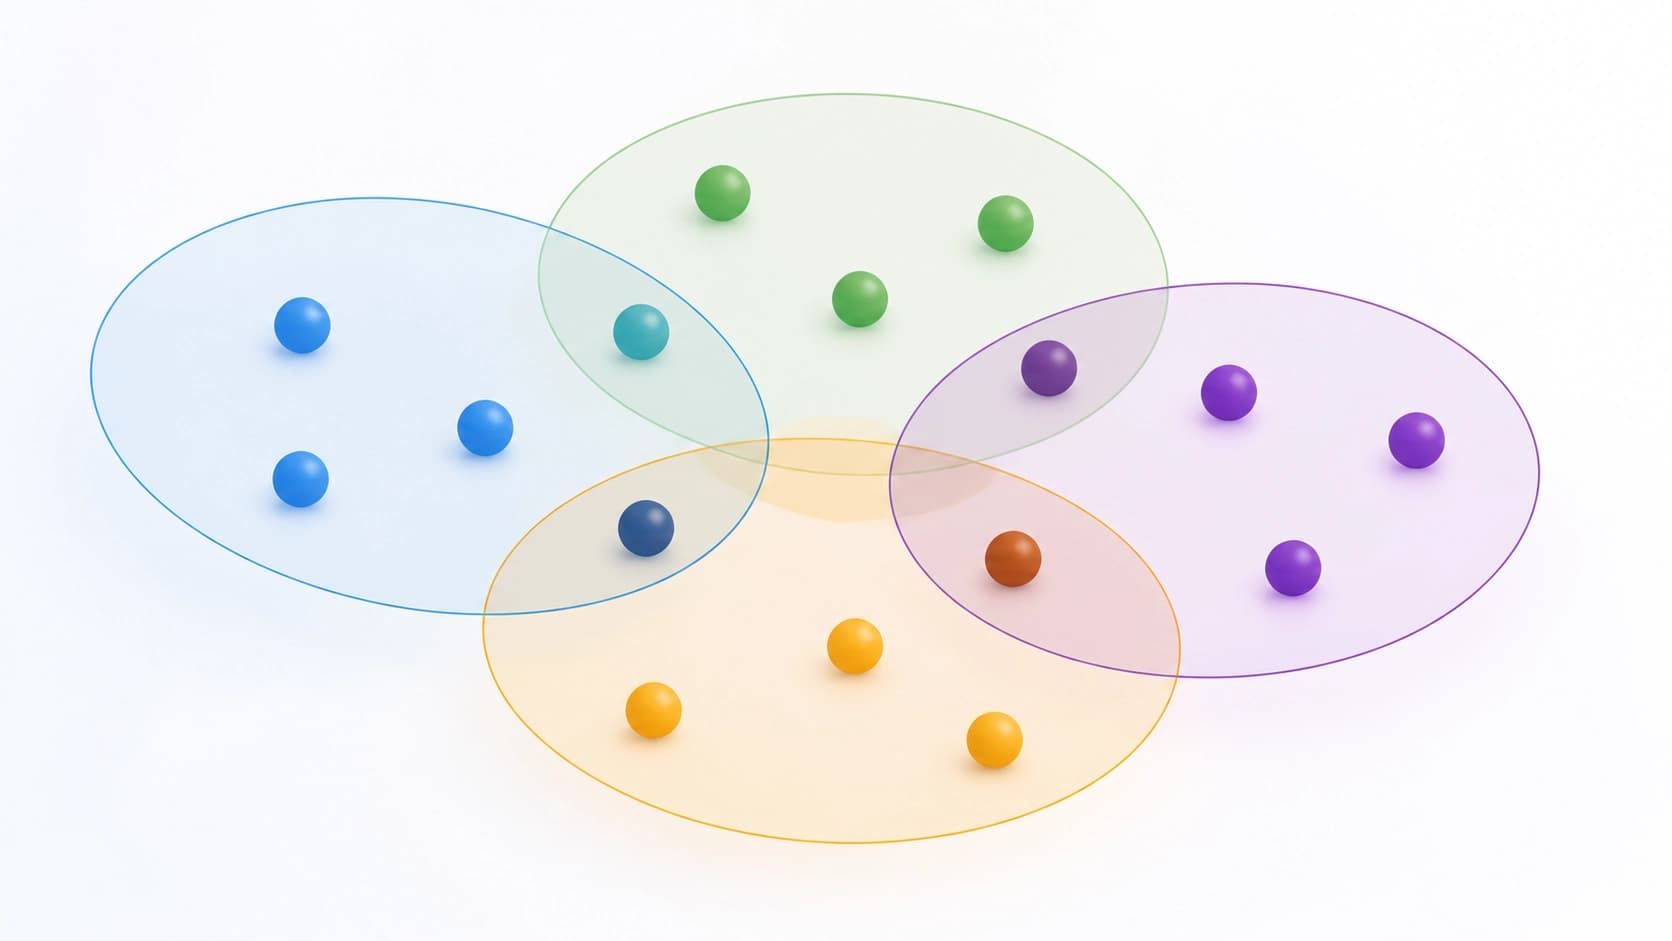
Les auteurs proposent HMGCLIP — un framework d'embeddings multimodaux fondé sur un hypergraphe hétérogène. La différence avec un graphe habituel est fondamentale. Une arête ordinaire relie deux objets ; une hyperarête relie d'un coup un groupe — par exemple, tous les produits d'une même catégorie réunis par un attribut commun. Cette construction permet de décrire des relations qui ne se décomposent pas en paires : « ces sept références forment une même gamme de matériaux », « ces quatre-là sont des équivalents interchangeables ».
Ensuite, la topologie de l'hypergraphe opère dans deux directions. Premièrement, on en extrait des négatifs complexes structurellement conscients — ces exemples similaires mais incorrects sur lesquels le modèle apprend à distinguer. C'est un point important : les négatifs complexes ne sont pas choisis au hasard dans le corpus, c'est la structure même des liens qui les suggère. Deuxièmement, via l'hypergraphe, on met en cohérence une sémantique multi-granulaire — à la fois au niveau des relations et au niveau des hyperarêtes. Autrement dit, le modèle aligne entre eux non seulement des produits isolés, mais aussi des groupes sémantiques entiers.
Pourquoi un mécanisme d'inférence à double granularité est nécessaire
Un détail à part — le dual-granularity inference. En sortie, le système combine dynamiquement les preuves attributives de manière à fonctionner avec la même assurance sur des tâches à granularité fine comme à granularité large. L'intérêt pratique : une requête a besoin d'un niveau général (« montre-moi des baskets »), une autre d'un niveau extrêmement précis (« des baskets avec membrane et un type de semelle particulier »). Un modèle taillé uniquement pour le détail perd en ampleur ; taillé uniquement pour le général, il perd en précision. Ici, on suppose que le système décide lui-même à quel niveau regarder.
Jeu de données et validation
Les auteurs ne se sont pas limités à l'architecture : ils ont publié un jeu de données e-commerce complet à granularité fine, afin que la tâche dispose d'un benchmark reproductible pour de futures comparaisons. C'est sans doute une partie tout aussi précieuse du travail — sans ensemble de données public, débattre de la distinction à granularité fine n'a pas de sens, chacun mesure sur le sien.
Les expériences ont été menées sur le nouveau jeu de données et sur le benchmark public MAVE. Le résultat est annoncé sans ambiguïté : l'approche dépasse les encodeurs multimodaux performants, les LLM multimodaux et les solutions de base pour l'e-commerce. Les chiffres précis et les tableaux se trouvent dans le travail lui-même ; ici, l'important est la conclusion : une approche structurelle de la représentation procure un gain qu'on ne parvient pas à atteindre par la simple complexification du modèle.
Où cela sera utile en pratique
Le premier usage, le plus évident — la recherche et la sélection d'équivalents. Quand un acheteur cherche un remplacement pour un objet hors d'usage, il a besoin d'une compatibilité par attributs, pas d'une ressemblance globale d'image. Le deuxième — les recommandations : elles gagnent à savoir distinguer une variante dans un autre matériau du même produit dans une autre configuration. Le troisième — la propreté du catalogue : les doublons et quasi-doublons, aujourd'hui fusionnés au hasard par l'automatisation, se séparent plus judicieusement avec une représentation à granularité fine.
Il existe aussi une couche moins évidente — l'explicabilité. Les hyperarêtes forment une structure qui montre pourquoi des produits se sont retrouvés côte à côte. Pour les équipes qui analysent les erreurs de classement, c'est plus utile qu'un vecteur à la nature obscure.
Ce qui reste encore ouvert
Tout travail sur une structure de graphe se heurte au coût : l'hypergraphe doit être construit, et lors de la mise à jour du catalogue, maintenu à jour. Dans quelle mesure cela reste peu coûteux sur des millions de fiches et à quelle fréquence il faudra le reconstruire, les auteurs ne le dévoilent pas dans l'annotation.
Deuxième question — la transférabilité. Le jeu de données a été constitué dans un seul domaine, et l'on ignore dans quelle mesure le schéma de comportement des hyperarêtes se conservera lors du passage, disons, de l'habillement à l'électronique, où les attributs sont structurés tout autrement. Troisième — comment une telle approche cohabite avec les pipelines de production déjà en place : remplacer le mode de représentation signifie généralement réindexer tout l'index de recherche.
Quoi qu'il en soit, la direction est clairement tracée. Le débat ne porte pas sur le modèle le plus grand, mais sur la bonne manière de stocker le sens d'un produit : dans un seul point moyenné ou dans un réseau de liens où les détails ne se dissolvent pas.