Le produit scalaire comme goulot d'étranglement
Presque toutes les architectures d'attention modernes sont conçues de la même manière : la requête et la clé sont mises en correspondance via un produit scalaire (ou sa version normalisée), le résultat est transformé en poids, et la sortie est assemblée comme une somme pondérée des valeurs. Le procédé est universel, mais il a un coût — la géométrie de l'espace des caractéristiques dans un tel schéma est fixée de manière rigide : la similarité est mesurée « en ligne droite », sans tenir compte du fait que différentes directions dans l'espace peuvent avoir une importance et une échelle différentes.
C'est précisément sur cette limitation que se concentre le travail arXiv:2608.24462 « Mahalanobis-Based Multi-Head Attention for Complex State Propagation » (auteur — Xiaohe Li ; section cs.AI). Au lieu du produit habituel, il utilise un noyau RBF construit sur la distance de Mahalanobis. En termes simples, la similarité entre les éléments d'une séquence n'est pas calculée « frontalement », mais en tenant compte de la structure de covariance des données — comme si l'espace était légèrement étiré et pivoté avant la comparaison, afin que les directions corrélées ne soient pas considérées comme indépendantes.
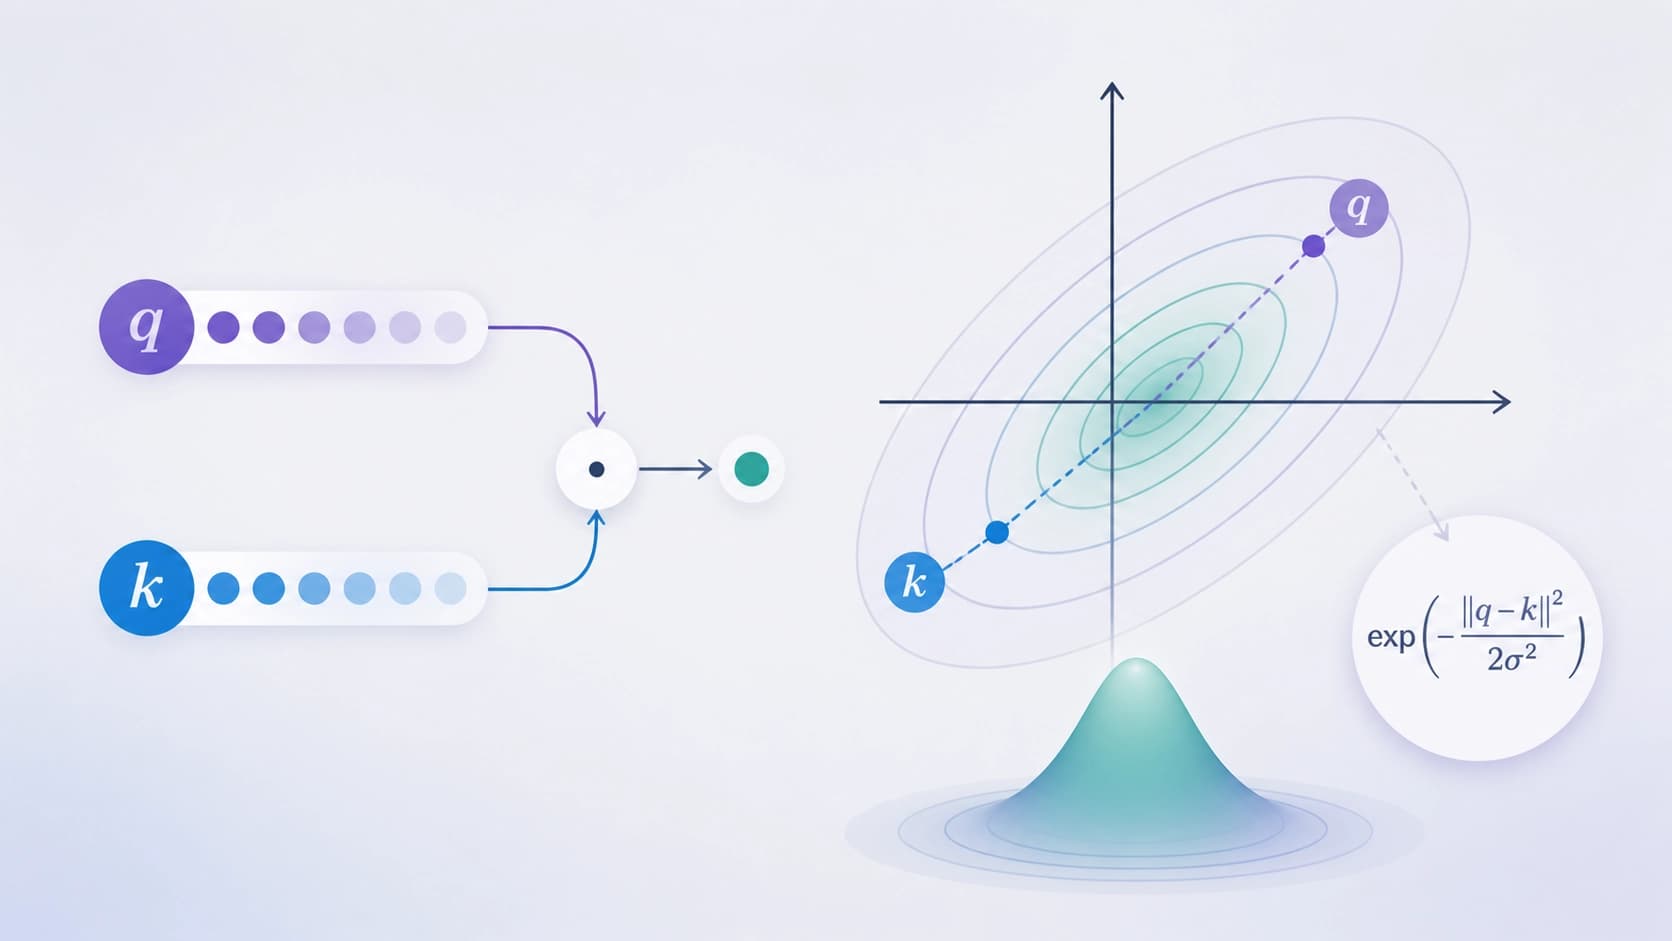
Ce qu'apporte la distance de Mahalanobis
Une attention dans un espace de dimension infinie sans croissance des paramètres
L'affirmation clé de l'auteur : le noyau RBF sur la distance de Mahalanobis permet de calculer l'attention comme si elle vivait dans un espace de caractéristiques de dimension infinie, tout en gardant le nombre de paramètres entraînables constant. Ce n'est pas de la magie, mais une conséquence du fait que le noyau définit déjà en lui-même une application non linéaire — aucune couche séparée pour déplier les caractéristiques n'est nécessaire. En pratique, cela signifie des exigences plus modestes en matière de mémoire et d'optimisation, ce qui, à l'ère des modèles géants, semble presque provocateur.
Définie positive et Tree Attention
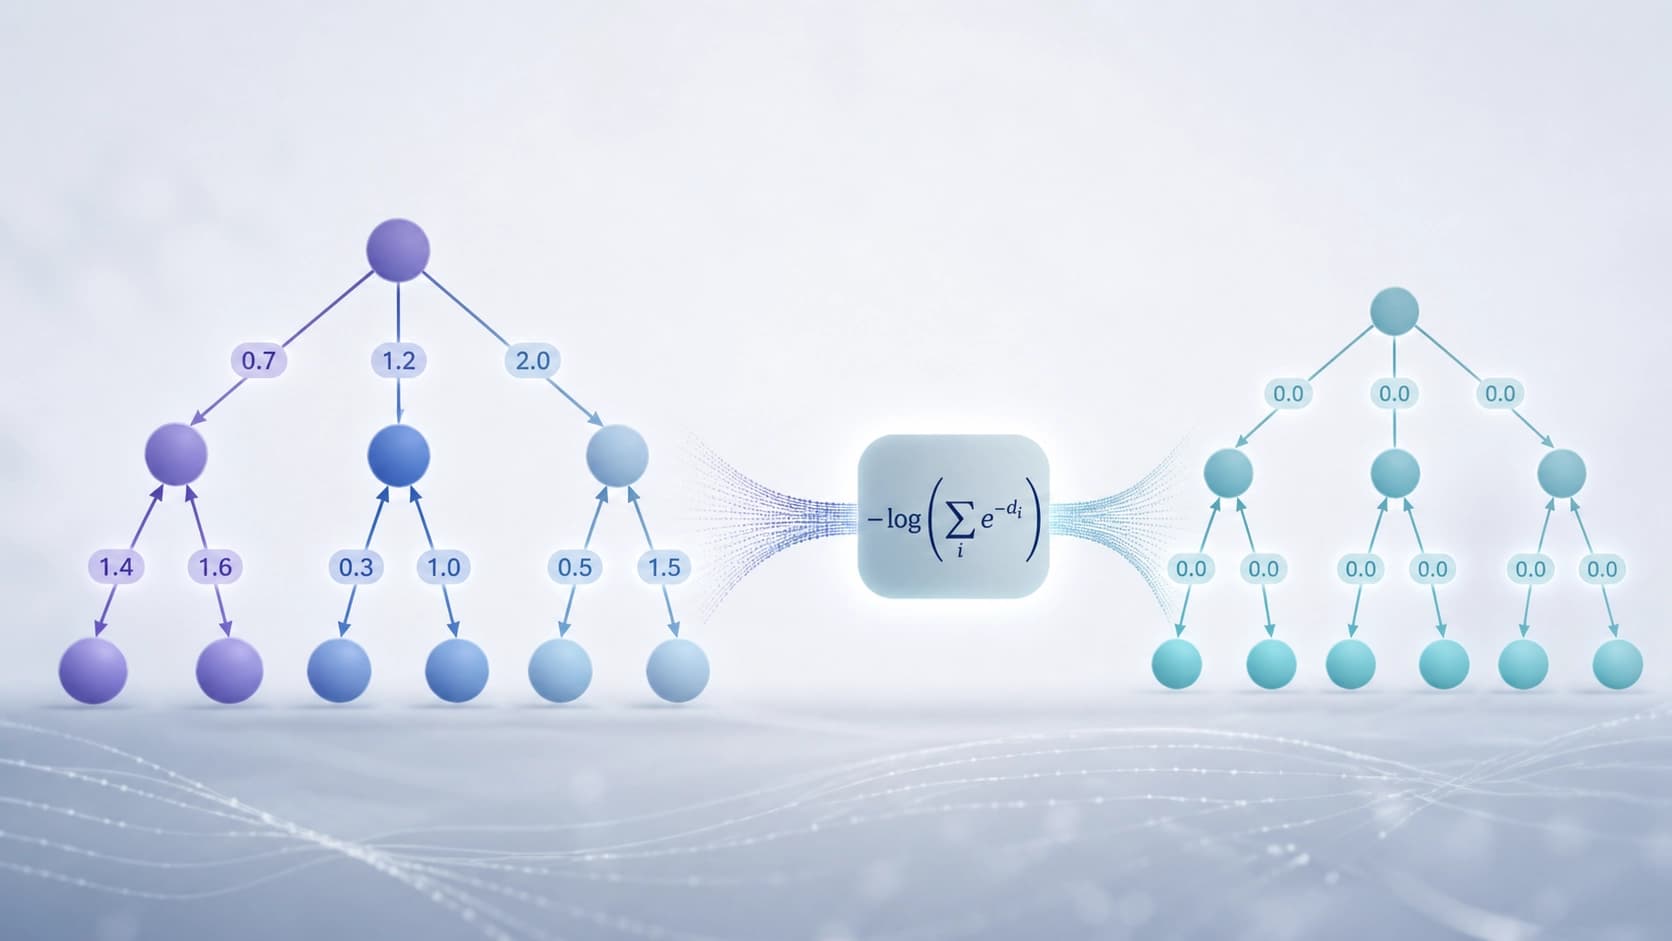
Le deuxième volet de l'idée s'appuie sur une propriété mathématique de la distance de Mahalanobis : elle est définie positive. On peut en tirer directement ce que l'article appelle Tree Attention — les scores d'attention sont construits non pas à partir de similarités « brutes », mais à partir de distances accumulées le long d'un arbre. Pour que ces accumulations ne divergent pas numériquement, une correction via LogSumExp est appliquée : le logarithme de la somme des exponentielles sur les arêtes est soustrait de la distance. En substance, c'est un moyen de concilier les contributions des différents chemins dans l'arbre sans perdre leur poids relatif.
Pour un lecteur peu familier avec les détails, une analogie utile est la suivante : au lieu d'additionner les « similarités » n'importe comment, le modèle les normalise soigneusement au fur et à mesure qu'il s'enfonce dans la structure. Cela relève plus de la comptabilité que de l'intuition — mais c'est précisément cette rigueur qui permet au raisonnement de rester stable sur de longues chaînes de dépendances.
Attention meshing : les têtes se mettent à dialoguer entre elles
Habituellement, l'attention multi-têtes est conçue comme un ensemble d'experts presque indépendants : chaque tête calcule la sienne, et le mélange n'intervient qu'en sortie, par une projection linéaire. Dans MHA-CSP, les matrices de distance de Mahalanobis sont réutilisées — c'est sur leur base qu'est construit le mécanisme d'« attention meshing », qui fait interagir directement les noyaux de différentes têtes. L'auteur revendique un double bénéfice : une précision accrue et un entraînement plus efficace, puisque le même travail de calcul n'est pas dupliqué.
Expériences : 119K paramètres contre de grands modèles de référence
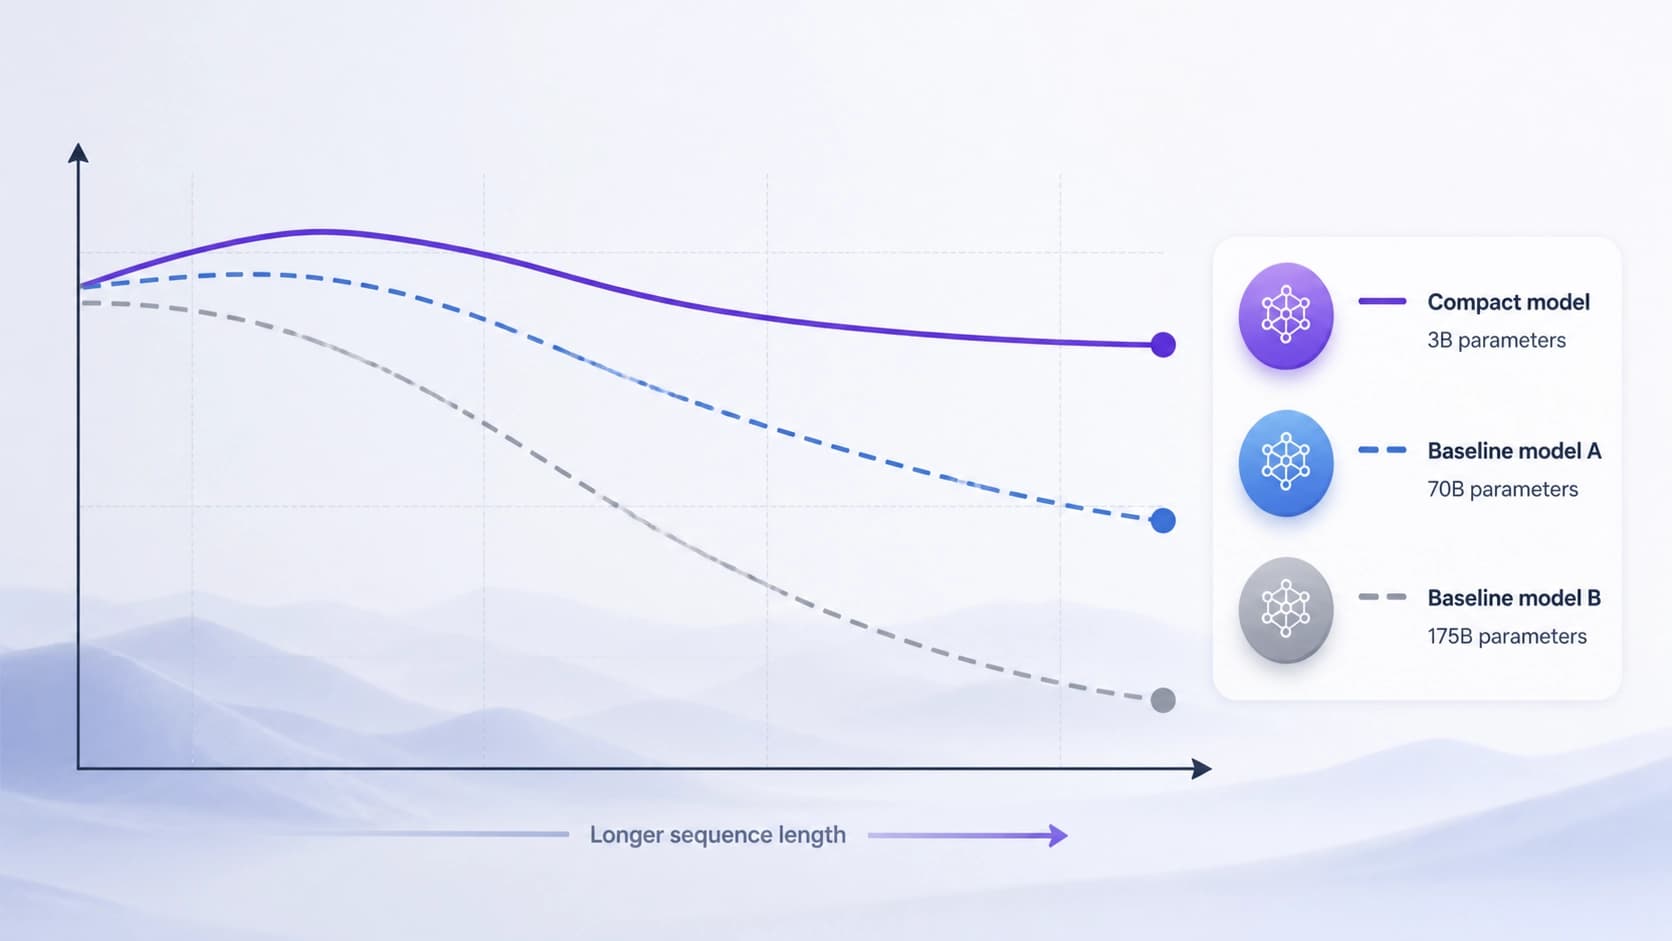
La partie la plus retentissante du travail — la comparaison. MHA-CSP, avec seulement 119 mille paramètres, est comparé à des transformeurs de référence et à des réseaux convolutifs de graphes entraînés de zéro dans des conditions identiques. La tâche — le suivi d'états sur de longues séquences. De plus, le teacher forcing n'a été appliqué qu'exclusivement sur l'état caché final, c'est-à-dire que le modèle ne recevait pas d'indices à chaque étape, comme on le fait souvent pour un entraînement plus instructif.
Selon l'auteur, MHA-CSP surpasse systématiquement ses concurrents. Les modèles de référence s'appuient quant à eux soit sur une attention dense (transformeur), soit sur la propagation d'information le long d'un graphe (GCN), tandis que MHA-CSP parvient à un raisonnement structuré grâce à une correction synthétique des distances et à un parcours économe de l'information, hérité du backbone CSP.
Il convient de souligner : il ne s'agit pas de dire qu'un petit modèle « rattrape » les grands sur tout. Il s'agit d'une classe de tâches précise — de longues séquences à structure symbolique interne, où l'important n'est pas simplement de mémoriser le contexte, mais d'en maintenir l'état. C'est précisément là que la géométrie des distances et la normalisation arborescente commencent à fonctionner.
Ce que cela change en pratique
La conclusion principale du travail se formule ainsi : la propagation d'états à valeurs complexes (complex-valued state propagation), combinée à une correction multi-têtes conjointe, s'avère un outil opérationnel pour saisir les structures symboliques. Et elle définit un nouveau compromis entre efficacité et qualité pour les tâches de raisonnement structuré.
Si l'on regarde plus largement, on discerne ici une tendance des dernières années : au lieu d'augmenter les paramètres, les chercheurs cherchent de meilleurs biais inductifs — c'est-à-dire qu'ils intègrent dans l'architecture les bonnes hypothèses sur la nature des données. Le produit scalaire était une hypothèse commode, mais assez grossière. Le remplacer par un noyau à métrique de covariance est une tentative de dire au modèle : « toutes les directions dans l'espace ne sont pas égales, tiens-en compte dès le départ ».
Un regard prudent de l'extérieur
Il y a des raisons de ne pas se précipiter pour réécrire les pipelines. Premièrement, les résultats ont été obtenus sur un ensemble précis de tâches de suivi d'états ; les transposer à la génération de texte, à la multimodalité ou à des scénarios dialogiques sans vérification séparée n'est pas raisonnable — de telles expériences ne figurent pas dans l'abstract. Deuxièmement, un auteur unique et une première version du preprint (v1, soumise le 25 août 2026) signifient que nous n'avons pas encore vu de réplication indépendante : le fichier de 377 Ko est disponible en PDF, HTML et sources TeX, mais la reproduction est une autre histoire.
Et pourtant, la direction semble productive. L'abandon du produit scalaire, le travail direct avec la géométrie des distances, la réutilisation des calculs entre les têtes — ce sont exactement les approches qui réduisent le coût du modèle sans sacrifier l'expressivité. Si les résultats se confirment sur d'autres domaines, les réseaux « petits mais bien conçus » auront un argument de poids supplémentaire.