
RLTLDR : l’agent tire lui-même les enseignements de son échec et en tient compte lors de sa tentative suivante
Après un échec, l’agent reçoit le signal du vérificateur et doit le résumer en un indice ; l’entraînement se fait sur des paires « tâche — indice », sans enseignant ni solution de référence. Sur des benchmarks difficiles de programmation et d’utilisation d’outils, la méthode fait passer le Pass@1 de 0–1 % pour GRPO à 12–31 %, et c’est précisément l’assimilation de ces paires qui apporte la contribution décisive.
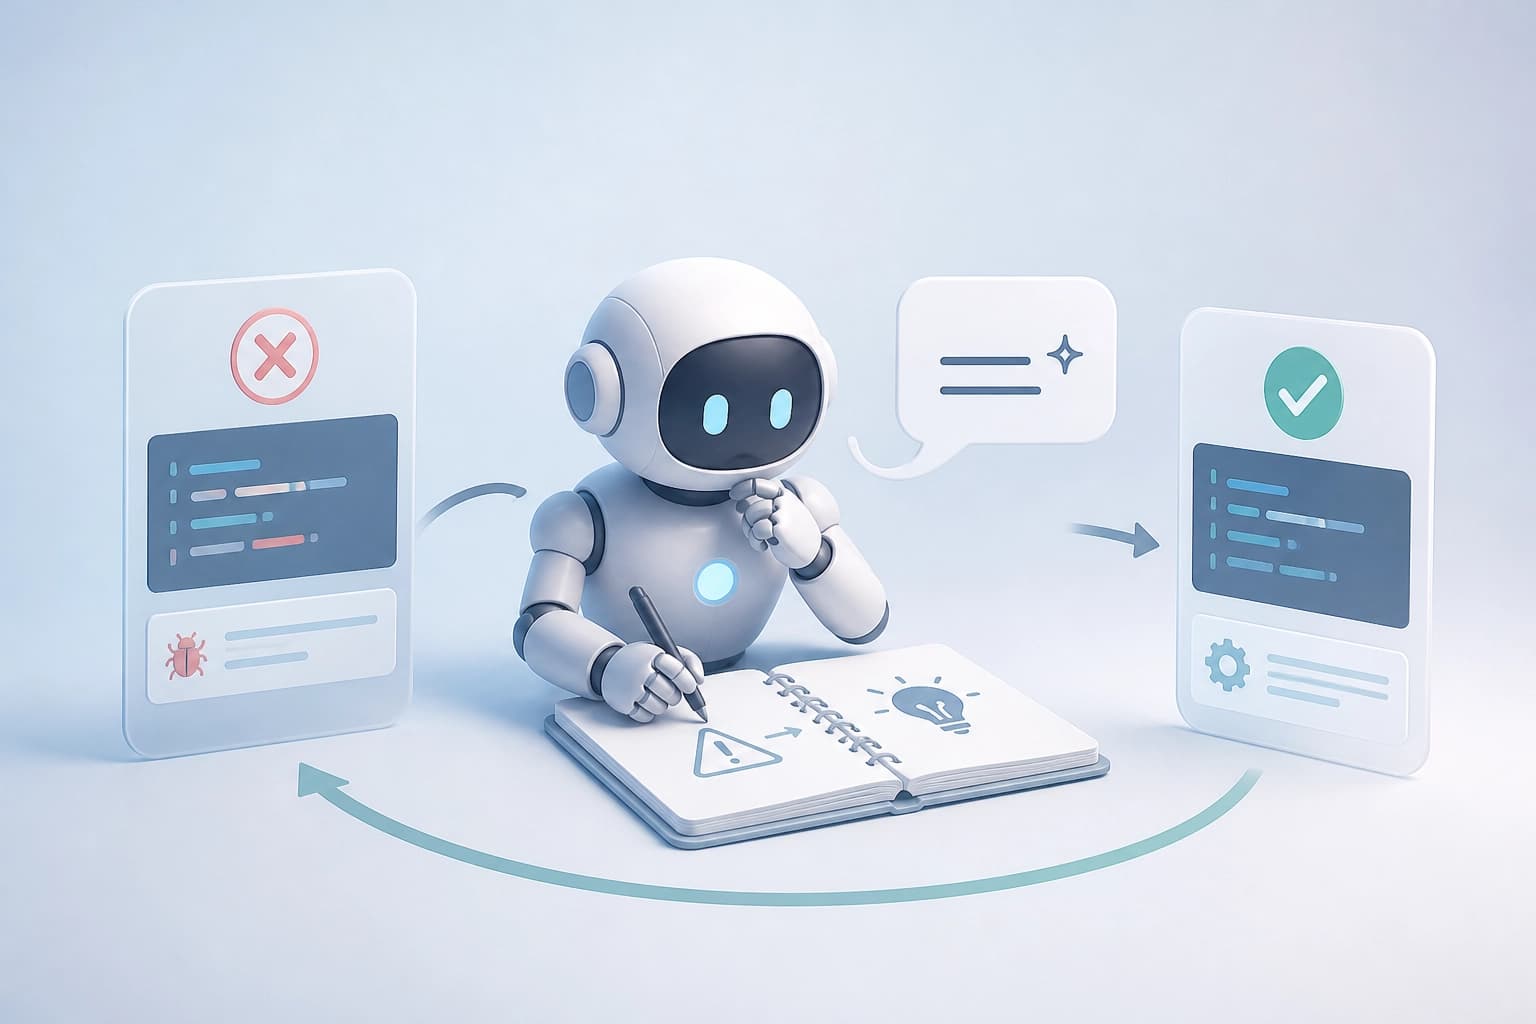
RLTLDR est une méthode d’auto-amélioration d’agent pour les tâches où il est difficile de réussir. Après une tentative infructueuse, l’agent voit la sortie du vérificateur et formule lui-même une conclusion concise — un enseignement TL;DR. La tentative suivante tient compte de toutes les conclusions précédentes. Les travaux de Michael Kirchhof, Eleonora Gualdoni, Andrew Szot et de leurs coauteurs décrivent cette approche. La première version a été soumise le 29 septembre 2026. La dernière révision date du 19 octobre 2026.
La tâche à laquelle répond RLTLDR
RLTLDR vise l’auto-amélioration des agents. Dans ce type de tâche, il est difficile pour un agent de réussir. Il n’existe ni modèles enseignants ni exemples de solutions à utiliser pour la distillation. L’échec et la sortie du vérificateur deviennent donc la source de retour d’information.
Conditions de la tâche :
- il n’y a pas de modèles enseignants ;
- il n’y a pas d’exemples de solutions à utiliser pour la distillation ;
- il est difficile pour l’agent de réussir ;
- la sortie du vérificateur est disponible après un échec.
Conclusion : RLTLDR est utile lorsqu’il n’existe ni solutions toutes prêtes ni enseignant, mais qu’un échec peut être vérifié. Le critère pratique est la présence d’un vérificateur dont la sortie peut être transmise à l’agent.
Fonctionnement du cycle
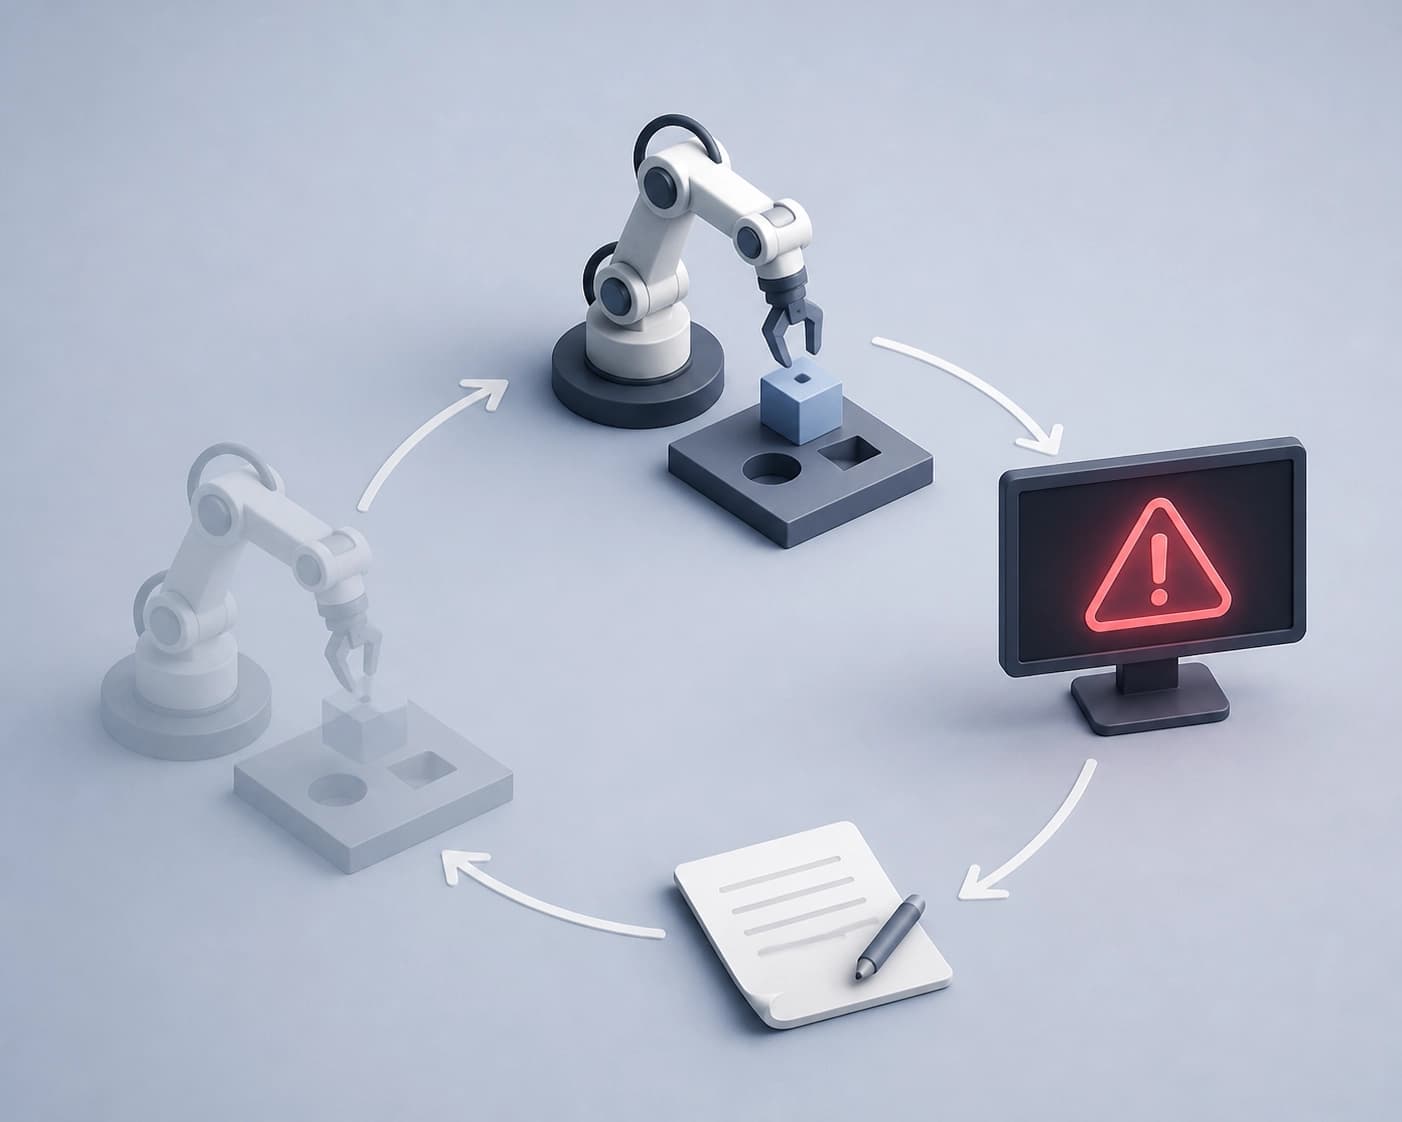
Le cycle RLTLDR s’articule autour de tentatives successives. Chaque échec fournit des éléments pour l’étape suivante.
Étapes :
- L’agent effectue un rollout et échoue.
- L’agent voit la sortie du vérificateur.
- L’agent formule son propre retour d’information : un enseignement TL;DR concis.
- Le rollout suivant tient compte de toutes les conclusions précédentes.
- Les rollouts se poursuivent jusqu’à ce qu’une solution soit trouvée.
- L’entraînement par rétropropagation sur les sorties présentes dans le contexte permet d’apprendre la correspondance « tâche → conclusion ».
Conclusion : l’intérêt du cycle ne tient pas seulement à l’indication fournie pour la tentative suivante. Le facteur clé est l’apprentissage de la relation entre la tâche et la conclusion.
Résultats sur des tâches difficiles
Les tests ont été réalisés sur des ensembles difficiles de tâches d’appel d’outils et de programmation. Les auteurs ont filtré les ensembles selon le critère Pass@128=0. La comparaison porte sur la politique Qwen 3.5 9B Thinking.
| Approche | Conditions d’évaluation | Pass@1 |
|---|---|---|
| Entraînement GRPO standard | Sans le cycle de conclusions décrit | 0–1% |
| RLTLDR | Conclusions dans le contexte pendant l’entraînement | 14–31% |
| RLTLDR | Aucune conclusion dans le contexte pendant l’évaluation | 12–13% |
L’entraînement GRPO standard reste à un niveau de Pass@1 compris entre 0% et 1%. RLTLDR atteint 14–31% lorsque les conclusions sont présentes dans le contexte pendant l’entraînement. Sans conclusions dans le contexte pendant l’évaluation, le résultat s’élève à 12–13%. Les auteurs mettent en avant l’apprentissage de la correspondance « tâche → conclusion » comme facteur clé.
Conclusion : le contexte contenant les conclusions améliore Pass@1. Pour vérifier l’apprentissage, il faut évaluer la méthode avec et sans ces conclusions.
SFTLDR : entraînement sur des paires « tâche — conclusion »
SFTLDR est une variante compacte de l’entraînement. Elle apprend uniquement à partir de paires (tâche, conclusion). Les rollouts et la rétropropagation sur ces derniers ne sont pas utilisés.
Ce que l’on sait de SFTLDR :
- l’entraînement se fait uniquement sur des paires (tâche, conclusion) ;
- SFTLDR ne montre pas les rollouts ;
- SFTLDR n’applique pas de rétropropagation sur les rollouts ;
- l’entraînement sur 4k paires de ce type rétablit presque toutes les performances de RLTLDR ;
- SFTLDR atteint presque les performances du SFT classique sur des rollouts complets ;
- les auteurs décrivent cette approche comme un paradigme compact : « pour les tâches de ce type, garde à l’esprit les éléments de ce type ».
Conclusion : SFTLDR est une option pour un entraînement compact. Le critère consiste à l’évaluer là où il est possible de constituer des paires « tâche — conclusion ».
Critères d’applicabilité
RLTLDR nécessite un retour d’information vérifiable et des tentatives successives. Sans ces conditions, le cycle ne peut pas être mis en place. Les critères ci-dessous aident à évaluer son applicabilité.
Critères :
- la tâche permet des tentatives infructueuses et des rollouts répétés ;
- il existe un vérificateur dont la sortie peut être montrée à l’agent ;
- l’agent est capable de formuler une conclusion concise ;
- la tentative suivante tient compte de toutes les conclusions précédentes ;
- l’évaluation inclut un mode sans conclusions dans le contexte, s’il est important de vérifier l’apprentissage.
Conclusion : RLTLDR est à privilégier pour les tâches qui disposent d’un vérificateur et où il est difficile de réussir. SFTLDR est à privilégier lorsqu’un mode compact sur des paires « tâche — conclusion » est nécessaire.
Foire aux questions
Matériaux connexes
Tous matériaux
FedSocket : des modèles échangeables dont l’exécution doit être possible chez le destinataire en contexte d’hétérogénéité multimodale
FedSocket est une approche selon laquelle le modèle échangé doit pouvoir être exécuté du côté du destinataire, tandis qu’une interface de prédiction commune Q relie des modèles privés hétérogènes. L’article décrit une agrégation tenant compte de l’appartenance, la transmission des seuls paramètres de Q accompagnés de compteurs, ainsi que des expériences menées sur six jeux de données, qui démontrent une amélioration de la précision en présence de modalités manquantes et la supériorité de l’inférence conjointe par rapport aux ensembles indépendants.
13 novembre 2026
Résistance des détecteurs face aux textes générés automatiquement puis paraphrasés : ce que les tests ont révélé
Cet article rassemble les résultats des tests d’outils qui réécrivent des fragments générés dans un style plus naturel. Après ce traitement, leur détectabilité diminue nettement, et les faux positifs persistants ne permettent pas de considérer le verdict du détecteur comme une preuve.
13 novembre 2026
CyberArena : les matchs en duel entre agents d’IA révèlent les limites des benchmarks de cybersécurité statiques
Le benchmark place deux agents dans des environnements isolés où les services évoluent en continu, puis agrège leurs actions au fil d’une série de manches en évaluations multidimensionnelles de leurs compétences offensives et défensives. Sur 466 matchs opposant 12 modèles récents, il a mis en évidence des différences de capacités là où les tests unilatéraux atteignent leurs limites, notamment en matière de planification sur plusieurs coups et de création de portes dérobées.
13 novembre 2026