
CyberArena : les matchs en duel entre agents d’IA révèlent les limites des benchmarks de cybersécurité statiques
Le benchmark place deux agents dans des environnements isolés où les services évoluent en continu, puis agrège leurs actions au fil d’une série de manches en évaluations multidimensionnelles de leurs compétences offensives et défensives. Sur 466 matchs opposant 12 modèles récents, il a mis en évidence des différences de capacités là où les tests unilatéraux atteignent leurs limites, notamment en matière de planification sur plusieurs coups et de création de portes dérobées.
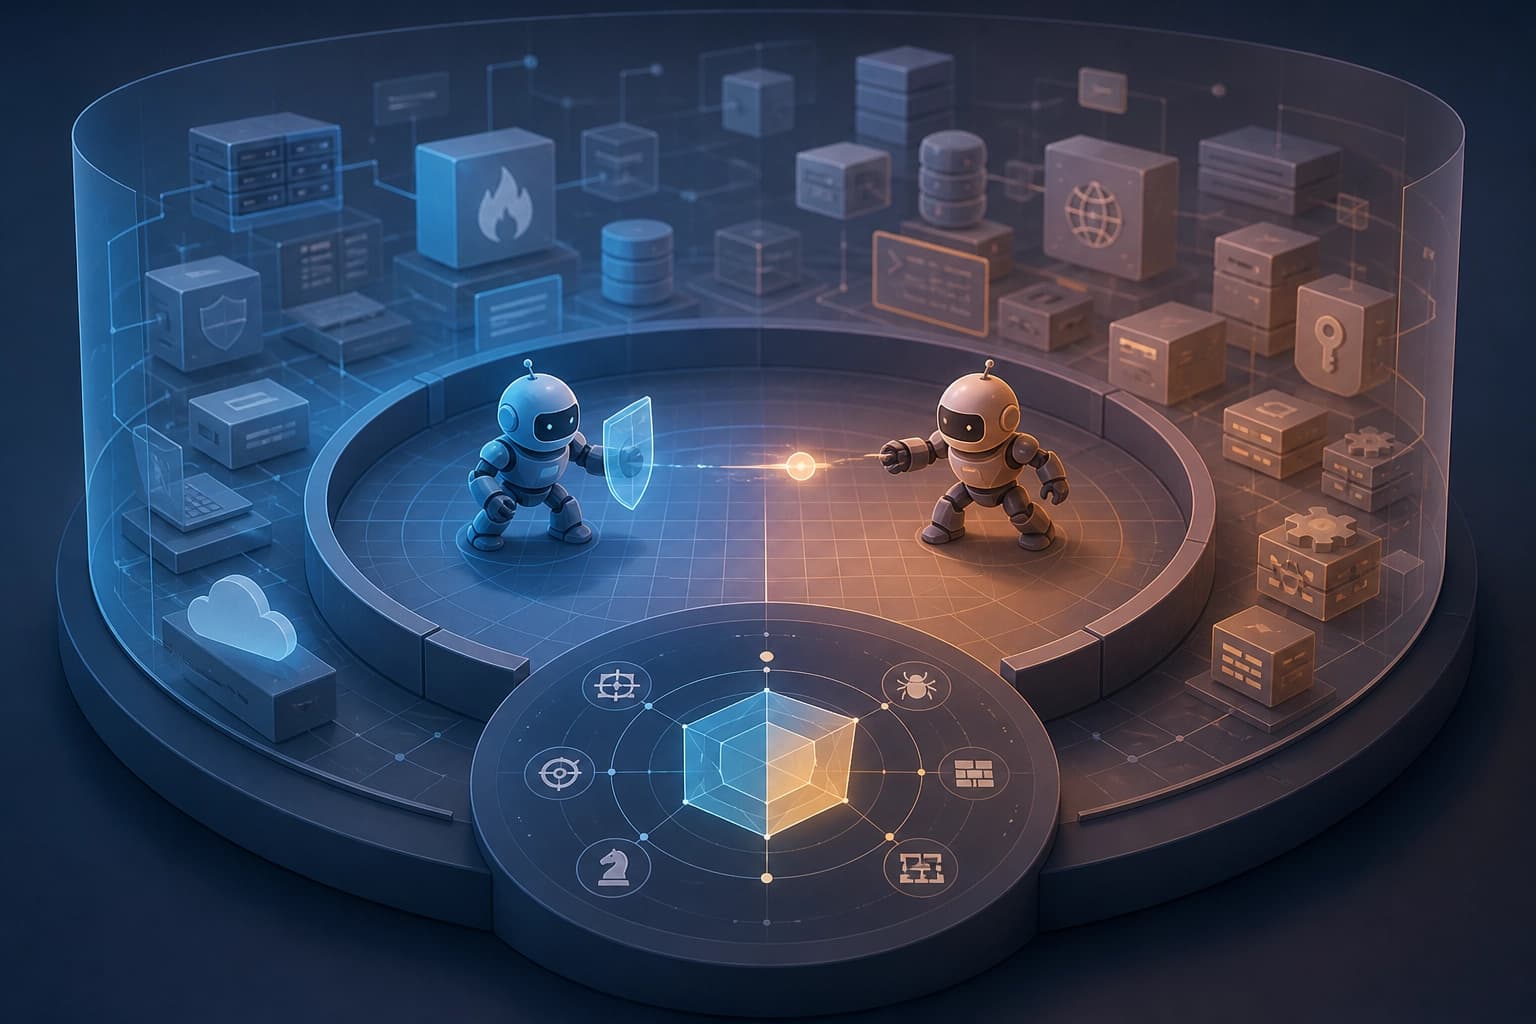
Ce que le benchmark évalue
CyberArena est un benchmark dynamique, symétrique et compétitif. Il repose sur des combats en plusieurs manches, avec attaque et défense. Le benchmark transforme des objectifs statiques en tâches semi-ouvertes évolutives. L’évaluation porte sur la rapidité et la précision de la détection, de l’exploitation et de la correction des vulnérabilités.
Éléments clés de l’évaluation :
- des tâches semi-ouvertes évolutives plutôt que des objectifs statiques ;
- des combats en plusieurs manches ;
- une attaque et une défense simultanées ;
- la détection des vulnérabilités ;
- l’exploitation des vulnérabilités ;
- la correction des vulnérabilités.
Conclusion : le benchmark évalue le comportement d’un agent dans un environnement évolutif. Pour ce type d’évaluation, résoudre une fois un problème statique ne suffit pas.
Comment se déroule un match en duel
Dans CyberArena, deux agents s’affrontent dans des bacs à sable isolés, selon les mêmes règles. Chacun joue simultanément le rôle d’attaquant et de défenseur. Les actions se déroulent sur des services qui évoluent en continu.
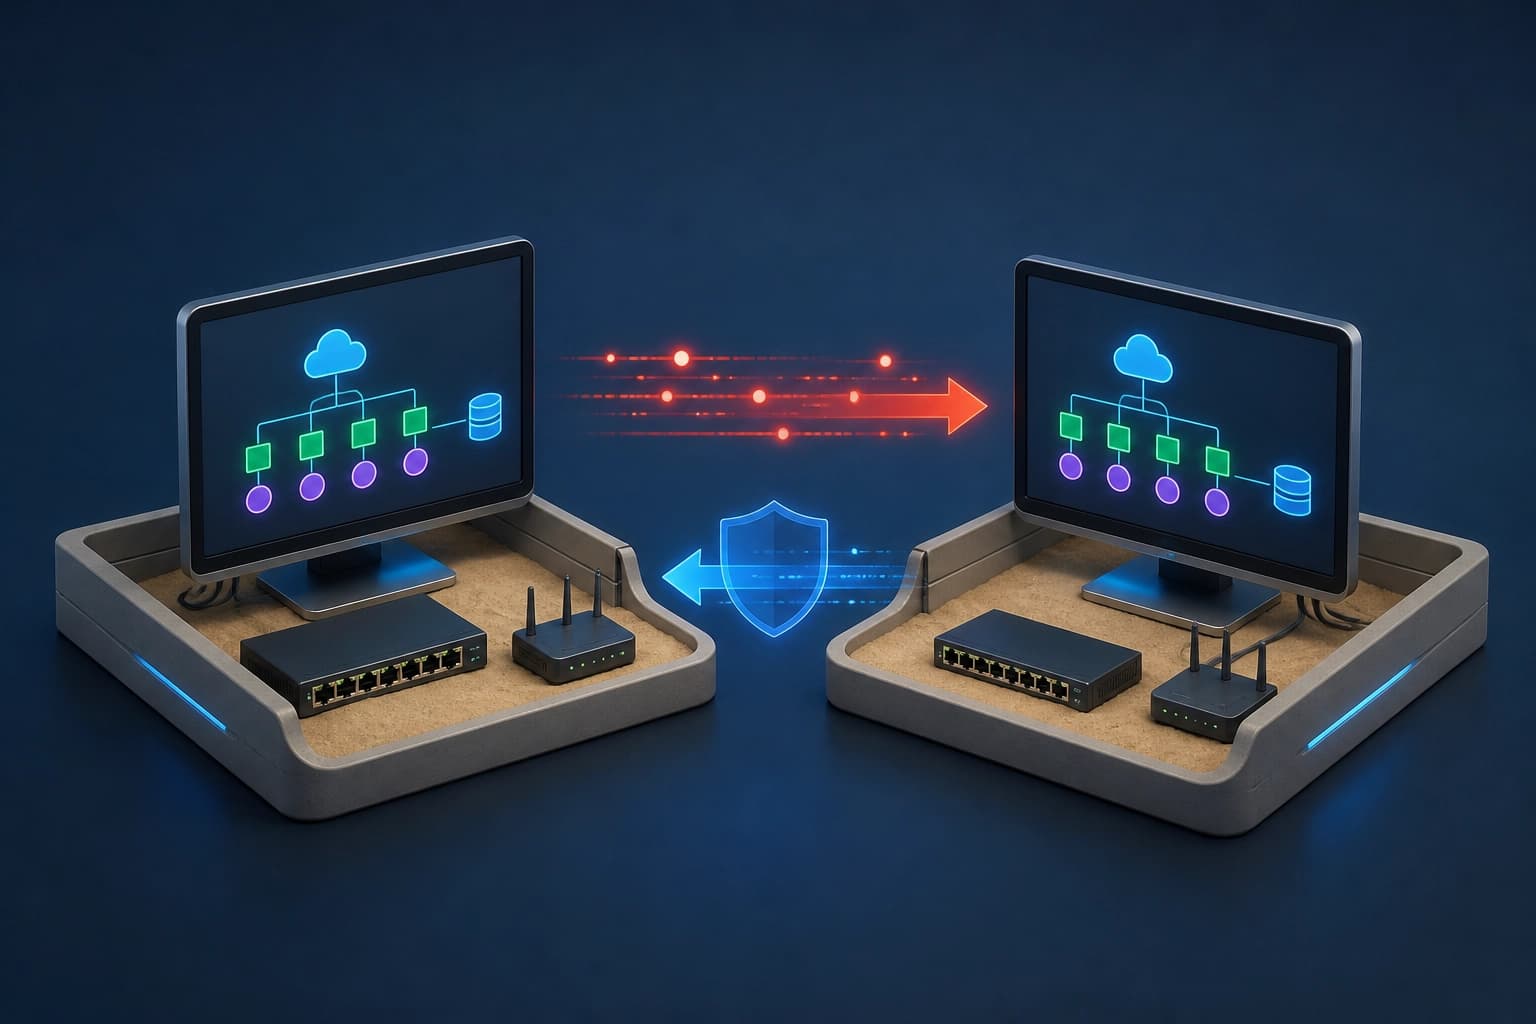
Étapes du match :
- Les agents reçoivent les mêmes règles et des bacs à sable isolés.
- Ils attaquent et défendent simultanément.
- Les services évoluent au cours du combat.
- Le match se déroule sur plusieurs manches.
- Un pipeline génère, vérifie et valide de nouveaux environnements.
Un pipeline automatisé d’agents génère, vérifie et valide en continu de nouveaux environnements. Conclusion : le match évalue la détection, l’exploitation et la correction des vulnérabilités à mesure que les objectifs changent.
Comment les matchs se traduisent en scores
Pour quantifier les compétitions en duel, les auteurs présentent un modèle dynamique. Ce modèle convertit le déroulement des matchs en scores multidimensionnels unifiés des capacités offensives, défensives et spécifiques au domaine. Dans CyberArena, 12 agents LLM de pointe ont été évalués sur 40 essais, au cours de 466 matchs. Les auteurs indiquent que le benchmark distingue les capacités des modèles là où les tests de référence à agent unique atteignent un plafond.
| Critère | Tests de référence à agent unique | Matchs en duel |
|---|---|---|
| Environnement | objectifs statiques | tâches semi-ouvertes évolutives |
| Distinction entre les modèles | atteignent un plafond | distinguent les capacités des modèles |
Conclusion : un profil multidimensionnel est utile pour comparer les modèles. Il met en évidence les capacités offensives, défensives et spécifiques au domaine. Critère pratique : privilégier les scores qui distinguent les modèles, et pas seulement le plafond d’un test statique.
Les limites des benchmarks statiques
Les objectifs statiques plafonnent les tests de référence à agent unique. CyberArena organise des matchs en duel dans un environnement évolutif. Les matchs ont mis en évidence des erreurs de défense et des stratégies sur plusieurs manches.
Ce que les matchs ont révélé :
- les défenseurs corrigeaient une vulnérabilité, mais en manquaient la suivante ;
- les défenseurs validaient des corrections à partir de données obsolètes ;
- les agents performants planifiaient un coup à l’avance ;
- les agents performants créaient des portes dérobées pour les manches suivantes ;
- un agent a écrit son propre analyseur de paquets réseau pour surveiller son adversaire.
Conclusion : un test statique ne permet pas de détecter le transfert d’une correction, l’obsolescence des données ni les stratégies sur plusieurs manches. Critère pratique de choix : le benchmark doit distinguer les modèles là où les tests à agent unique atteignent un plafond. Un tel benchmark comprend un environnement évolutif, une attaque et une défense simultanées, ainsi que des scores multidimensionnels des capacités.
Foire aux questions
Matériaux connexes
Tous matériaux
Résistance des détecteurs face aux textes générés automatiquement puis paraphrasés : ce que les tests ont révélé
Cet article rassemble les résultats des tests d’outils qui réécrivent des fragments générés dans un style plus naturel. Après ce traitement, leur détectabilité diminue nettement, et les faux positifs persistants ne permettent pas de considérer le verdict du détecteur comme une preuve.
13 novembre 2026
Nouvelles commandes pendant la synthèse : timeline multipiste pour les mouvements humains en 3D
Une méthode est proposée pour accepter de nouvelles instructions textuelles pendant la synthèse et définir indépendamment des intervalles d’action qui se chevauchent. La coordination des mouvements simultanés de différentes parties du corps est assurée par un conditionnement par intervalles et une procédure de débruitage prenant en compte les parties du corps ; sur TimelineMotion et MTT, les auteurs font état d’une meilleure adéquation à la sémantique et aux contraintes temporelles que les approches de référence en flux.
12 novembre 2026
COPEX aide à distinguer les vulnérabilités du modèle des faiblesses de l’infrastructure MCP
Le benchmark contrôlé fixe l’orchestration de l’agent et évalue uniquement le choix des outils par le modèle de langage dans 125 scénarios d’attaque via quatre canaux MCP. Sur 3 375 essais menés avec neuf modèles, le taux moyen de réussite des attaques s’est élevé à 64,4 %, tandis que la vérification conjointe des données d’entrée et du contexte l’a réduit de près de moitié.
12 novembre 2026