
Résistance des détecteurs face aux textes générés automatiquement puis paraphrasés : ce que les tests ont révélé
Cet article rassemble les résultats des tests d’outils qui réécrivent des fragments générés dans un style plus naturel. Après ce traitement, leur détectabilité diminue nettement, et les faux positifs persistants ne permettent pas de considérer le verdict du détecteur comme une preuve.
Comment la paraphrase modifie le texte et les signaux des détecteurs
Un contenu généré par l’IA et humanisé est un texte produit par une machine, puis paraphrasé pour paraître plus naturel. Les outils modifient le choix des mots, la longueur des phrases et le ton. Certains ajoutent un rythme irrégulier ou réécrivent le texte plusieurs fois. Ces changements modifient les signaux sur lesquels s’appuient les détecteurs : la prévisibilité des mots et la variation de la longueur des phrases.
- le choix des mots ;
- la longueur des phrases ;
- le ton ;
- un rythme irrégulier ;
- des réécritures répétées.
Conclusion : la paraphrase modifie précisément les caractéristiques qui permettent aux détecteurs de distinguer les textes générés par une machine.
Ce que les tests ont révélé sur les textes paraphrasés
Les tests visaient à vérifier si les détecteurs restaient fiables après une paraphrase. Une étude de 2025 a porté sur 19 outils d’humanisation et de paraphrase.
| Test | Résultat |
|---|---|
| Étude de 2025, 19 outils | De nombreux détecteurs ne reconnaissent pas les textes humanisés. |
| Google Research | Un modèle de paraphrase préserve le sens et échappe en grande partie à la détection. |
| Paraphrase de ChatGPT avec QuillBot | La précision du détecteur sur les textes de ChatGPT est tombée à 49 %. |
| Autre test | La paraphrase de ChatGPT a contourné chaque détecteur dans au moins la moitié des cas. |
| Stanford, style littéraire | La détection des textes générés par l’IA est passée de 100 % à 13 % lorsque l’on a demandé à ChatGPT d’adopter un style plus littéraire. |
Conclusion : les détecteurs résistent peu aux textes générés par une machine et paraphrasés.
Ce que les détecteurs repèrent dans les textes
Les détecteurs s’appuient sur des caractéristiques qui ne sont pas toujours liées à l’origine générée par une machine. Des chercheurs de Carnegie Mellon ont établi que les textes de modèles de base semblaient souvent écrits par des humains aux yeux de GPTZero et de Pangram. Ce n’était pas le cas des textes produits par des modèles affinés pour suivre des instructions. L’équipe estime que les détecteurs repèrent plutôt des traces de l’entraînement des modèles qu’un signe fiable de rédaction par une machine.
- modèles de base : les textes semblent souvent écrits par des humains aux yeux de GPTZero et de Pangram ;
- modèles affinés pour suivre des instructions : les textes ne donnent pas cette impression ;
- conclusion de l’équipe : les détecteurs repèrent des traces de l’entraînement.
Stanford a évalué sept détecteurs sur 91 dissertations d’auteurs dont l’anglais n’est pas la langue maternelle. Le taux moyen de faux positifs s’élevait à 61,3 %. Au moins un outil a signalé plus de 91 % des dissertations. Les dissertations d’auteurs dont l’anglais est la langue maternelle ont obtenu des taux proches de zéro. Les chercheurs attribuent cet écart à un choix de mots simple et prévisible, que les détecteurs prennent pour un signe de texte généré par une machine.
Conclusion : un signal de détection ne prouve pas qu’un texte a été généré par une machine ; son évaluation doit donc tenir compte du contexte.
Précision annoncée et limites réelles
Les tests indépendants et ceux menés par les créateurs des outils donnent des estimations différentes de leur précision. Les conditions de vérification influent sur les résultats.
- Revue de tests indépendants : la précision de Turnitin, de GPTZero et d’Originality.ai se situe entre 70 % et 85 %. Ces outils restent confrontés au problème des faux positifs.
- Turnitin annonce une précision de 98 % et un taux de faux positifs inférieur à 1 %. Cette affirmation ne vaut que pour les documents dont plus de 20 % du texte a été généré par l’IA.
- OpenAI a fermé son propre classificateur en juillet 2023. Celui-ci ne détectait que 26 % des textes générés par l’IA.
- Les auteurs de l’étude de 2025 ont entraîné un modèle sur des échantillons humanisés. Le modèle détectait les textes humanisés avec un faible taux de faux positifs. Il restait efficace malgré les tentatives de le tromper. Ces résultats proviennent des auteurs du modèle ; des tests indépendants sont nécessaires.
Conclusion : la précision annoncée dépend des conditions, et les tests indépendants révèlent les limites de la détection.
Évaluer concrètement un détecteur
Les experts recommandent de considérer le score d’un détecteur comme un indice, et non comme une preuve. Pour vérifier un travail, on peut consulter l’historique des brouillons, poser de brèves questions à l’oral et le comparer aux travaux réalisés en classe. Les experts conseillent aux auteurs et aux éditeurs de demander les sources, des entretiens et des données originales.
- l’historique des brouillons ;
- de brèves questions à l’oral ;
- la comparaison avec des travaux réalisés en classe ;
- des sources, des entretiens et des données originales pour les auteurs et les éditeurs.
Critère pratique : un détecteur est un signal invitant à effectuer des vérifications supplémentaires, et non le seul fondement d’une conclusion.
Foire aux questions
Matériaux connexes
Tous matériaux
FedSocket : des modèles échangeables dont l’exécution doit être possible chez le destinataire en contexte d’hétérogénéité multimodale
FedSocket est une approche selon laquelle le modèle échangé doit pouvoir être exécuté du côté du destinataire, tandis qu’une interface de prédiction commune Q relie des modèles privés hétérogènes. L’article décrit une agrégation tenant compte de l’appartenance, la transmission des seuls paramètres de Q accompagnés de compteurs, ainsi que des expériences menées sur six jeux de données, qui démontrent une amélioration de la précision en présence de modalités manquantes et la supériorité de l’inférence conjointe par rapport aux ensembles indépendants.
13 novembre 2026
CyberArena : les matchs en duel entre agents d’IA révèlent les limites des benchmarks de cybersécurité statiques
Le benchmark place deux agents dans des environnements isolés où les services évoluent en continu, puis agrège leurs actions au fil d’une série de manches en évaluations multidimensionnelles de leurs compétences offensives et défensives. Sur 466 matchs opposant 12 modèles récents, il a mis en évidence des différences de capacités là où les tests unilatéraux atteignent leurs limites, notamment en matière de planification sur plusieurs coups et de création de portes dérobées.
13 novembre 2026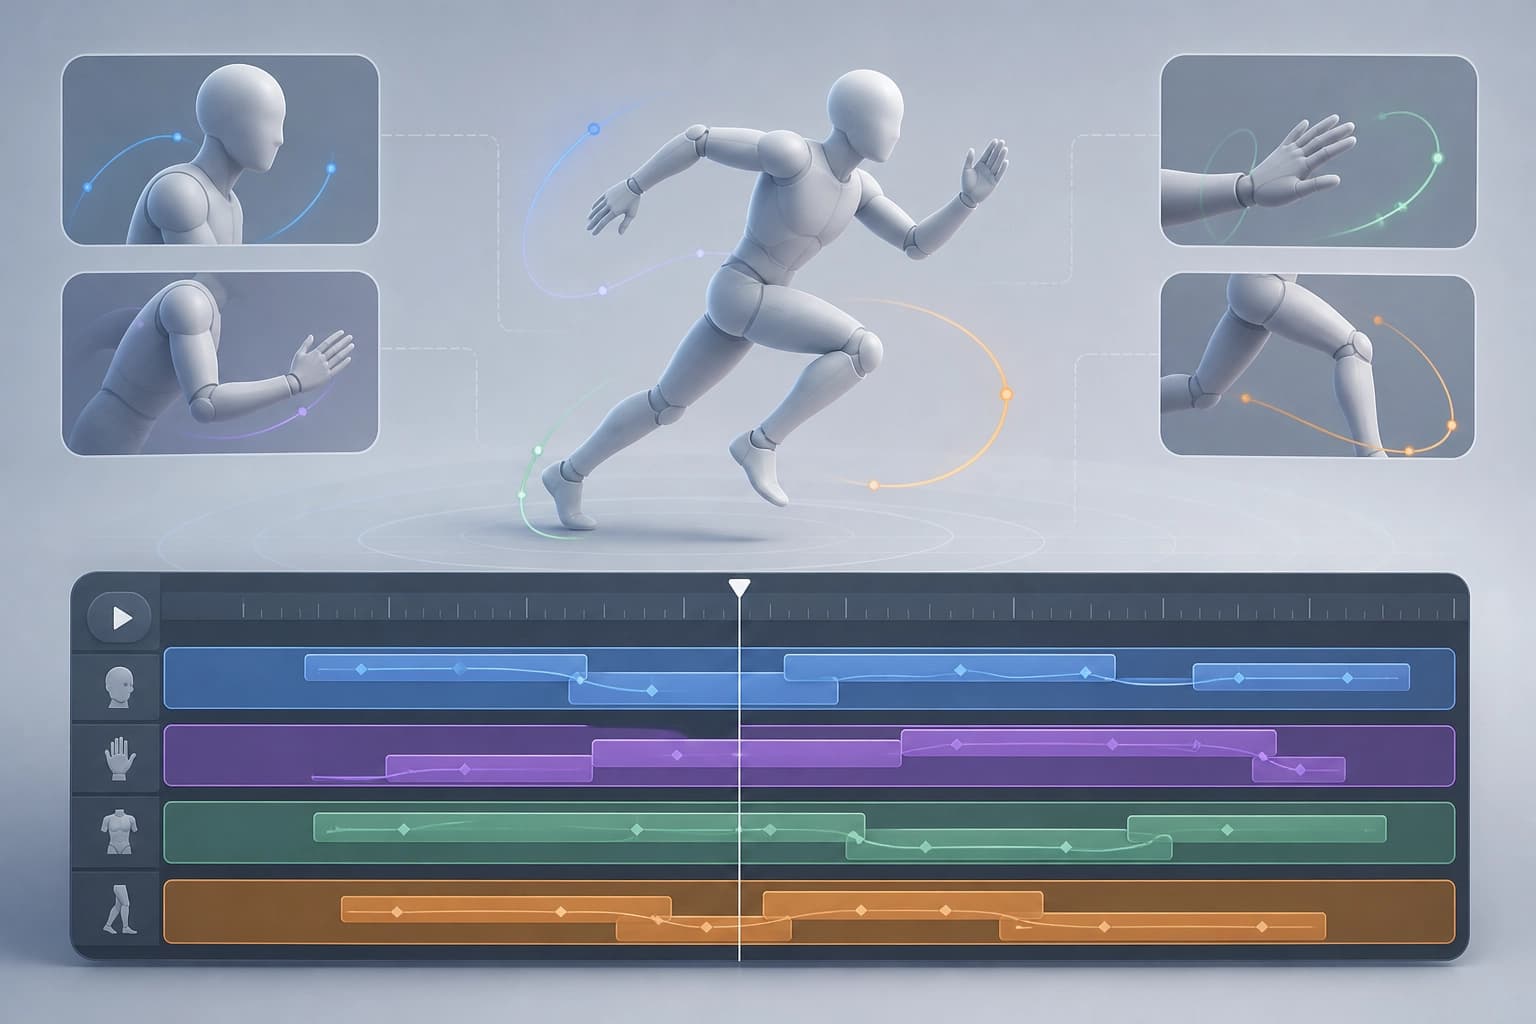
Nouvelles commandes pendant la synthèse : timeline multipiste pour les mouvements humains en 3D
Une méthode est proposée pour accepter de nouvelles instructions textuelles pendant la synthèse et définir indépendamment des intervalles d’action qui se chevauchent. La coordination des mouvements simultanés de différentes parties du corps est assurée par un conditionnement par intervalles et une procédure de débruitage prenant en compte les parties du corps ; sur TimelineMotion et MTT, les auteurs font état d’une meilleure adéquation à la sémantique et aux contraintes temporelles que les approches de référence en flux.
12 novembre 2026