
La mémoire de travail là où compte non pas le chiffre, mais la grandeur
Garder en tête une variable continue — angle de rotation, vitesse, position du curseur, force d'appui — et l'ajuster en douceur : c'est sans doute le test le plus honnête de la mémoire de travail. Retenir un « sept » n'est pas difficile, mais conserver une grandeur sans frontières naturelles, susceptible de se décaler d'une fraction aussi petite soit-elle, c'est une tâche d'une tout autre classe.
Avec elle, les relations des réseaux artificiels sont historiquement tendues. Les modèles à attracteurs continus — c'est-à-dire à états stables formant non pas une poignée de points isolés, mais une surface lisse — tiennent sur parole : décale un peu les paramètres, et le comportement s'effondre.
Pourquoi les architectures récurrentes habituelles « quantifient » l'état
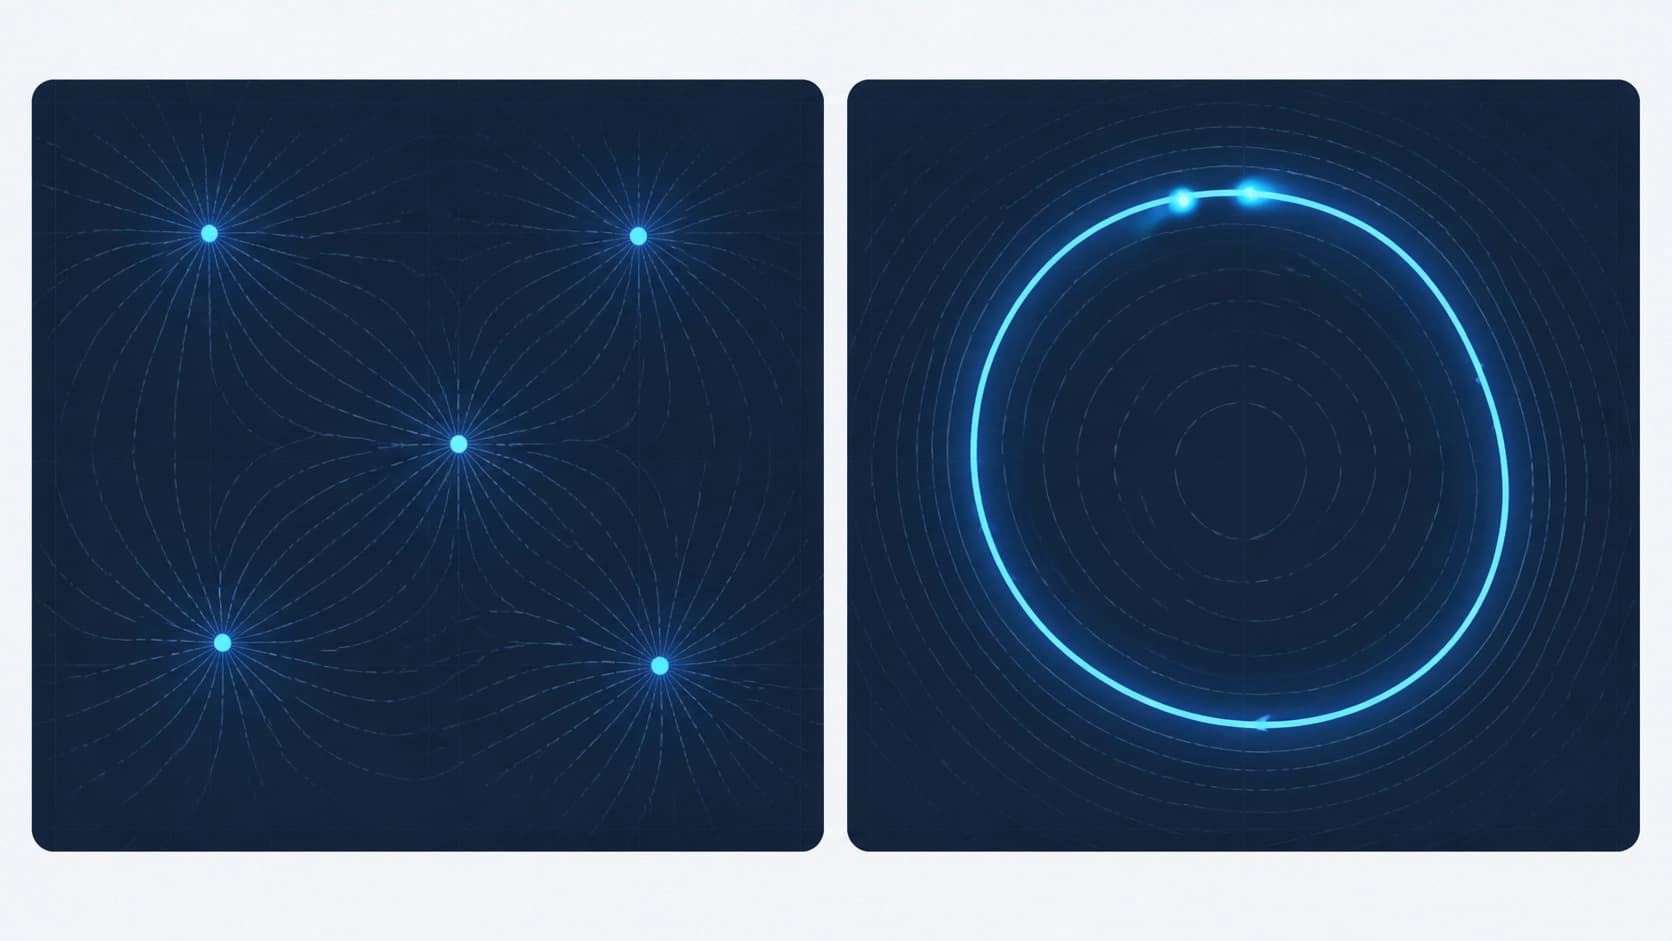
Les solutions récurrentes standard, y compris GRU et LSTM, n'apprennent généralement pas les variétés continues. Au lieu d'un continuum, elles fragmentent l'espace des états en attracteurs ponctuels discrets : le réseau arrondit en quelque sorte l'entrée à la « case » la plus proche. Pour la classification, c'est pratique ; pour l'estimation quantitative, c'est un arrêt de mort.
Une équipe de chercheurs (Zhaotian Gu, Jie Su, Weiwei Wang, Chang Liu, Tianyi Qian, Dahui Wang) a proposé de soigner cela non pas en complexifiant l'architecture, mais par un procédé de calcul précis. Le travail est publié dans Transactions on Machine Learning Research (août 2026), le préprint est disponible sous arXiv:2608.01947 dans les sections q-bio.NC, cs.AI et cs.NE.
Diviser au lieu de soustraire : un modèle minimal
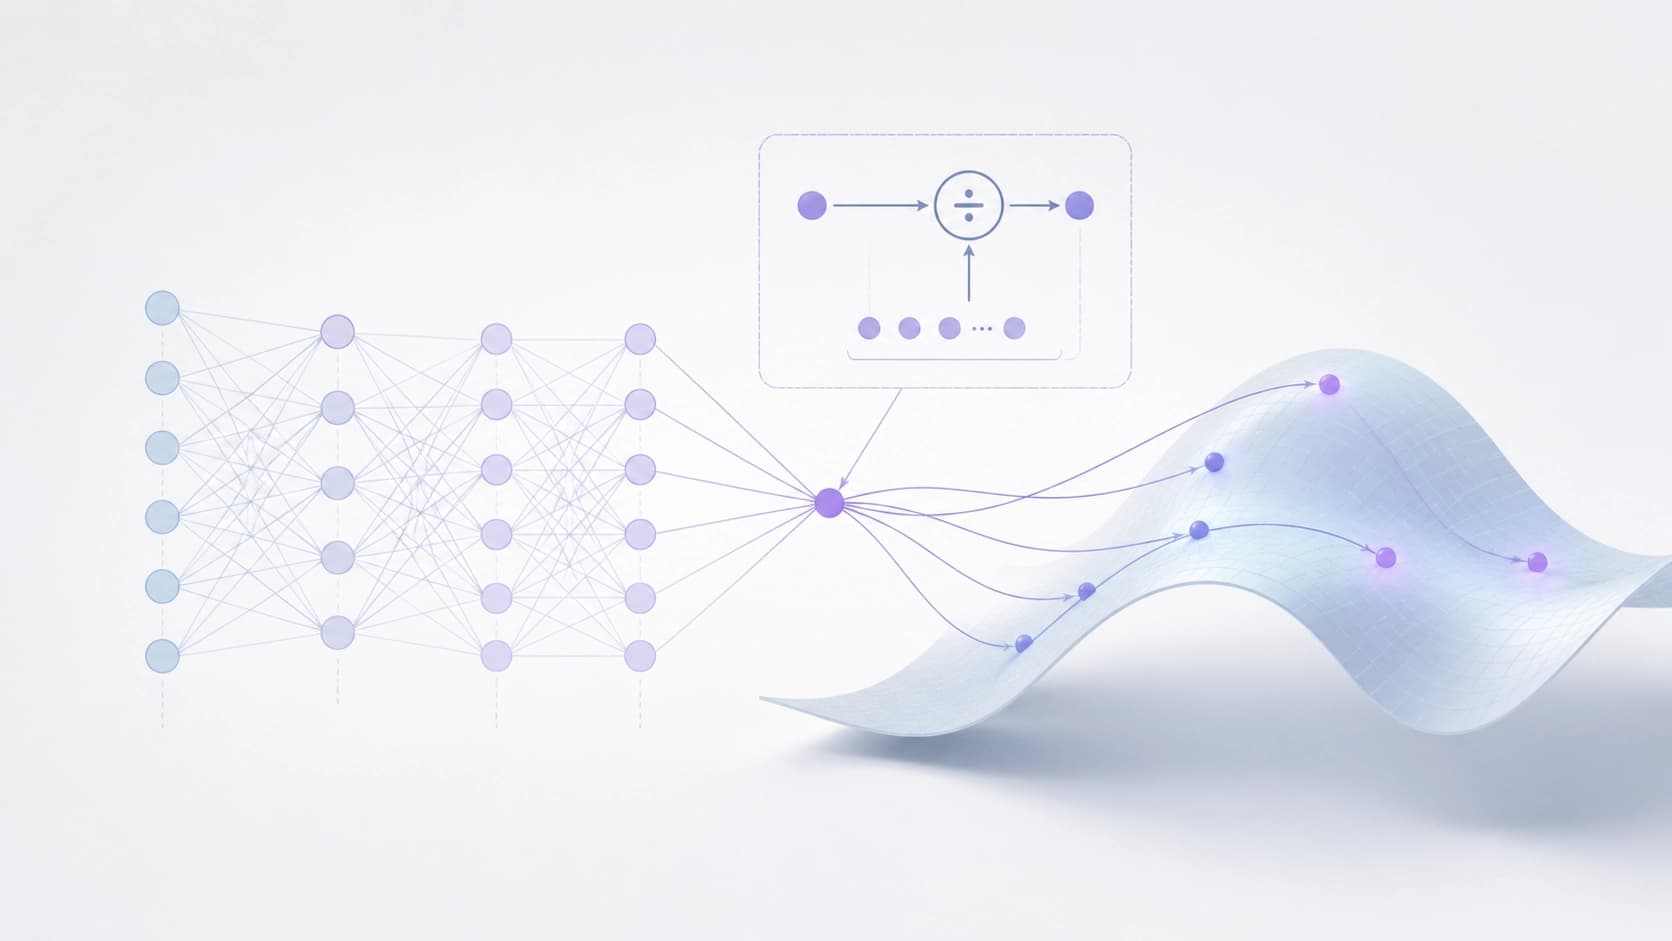
L'idée vient des neurosciences. La division (normalisation divisive) est une opération canonique observée partout dans les circuits corticaux, et les auteurs ont construit autour d'elle un réseau récurrent minimal, algébriquement isolé — Recurrent Divisive Normalization Network, en abrégé RDNN. À l'intérieur, rien de superflu : seulement la dynamique de division et ce qui l'accompagne.
Ensuite vient le geste classique en neurosciences computationnelles : l'analyse des systèmes dynamiques sur les tâches classiques de mémoire de travail. Et ici, une contrainte biophysique se transforme de façon inattendue en avantage. Le réseau converge vers des variétés lentes stables, et ce avec une grande précision : les trajectoires ne divergent pas, mais se posent sur une surface étroite et s'y déplacent tranquillement.
Ce qui arrive au gradient
Un volet distinct du travail — l'analyse de l'apprentissage par rétropropagation dans le temps (BPTT). La division introduit une mise à l'échelle locale du gradient, dépendant de l'activité courante : plus le bloc est excité, plus la mise à jour de ses paramètres est modeste. Il en résulte un frein intégré, qui s'active précisément là où il faut.
L'effet est observable : le rang effectif du réseau se comprime nettement de lui-même, et la dynamique récurrente se retrouve enfermée dans un sous-espace étroit de faible dimension. Les auteurs soulignent toutefois la différence avec une factorisation explicite de rang faible — là, une telle contrainte mène souvent à des pathologies d'optimisation, alors qu'ici elle surgit d'elle-même, comme effet secondaire de l'activité.
Ablations : sans division, la variété s'effondre
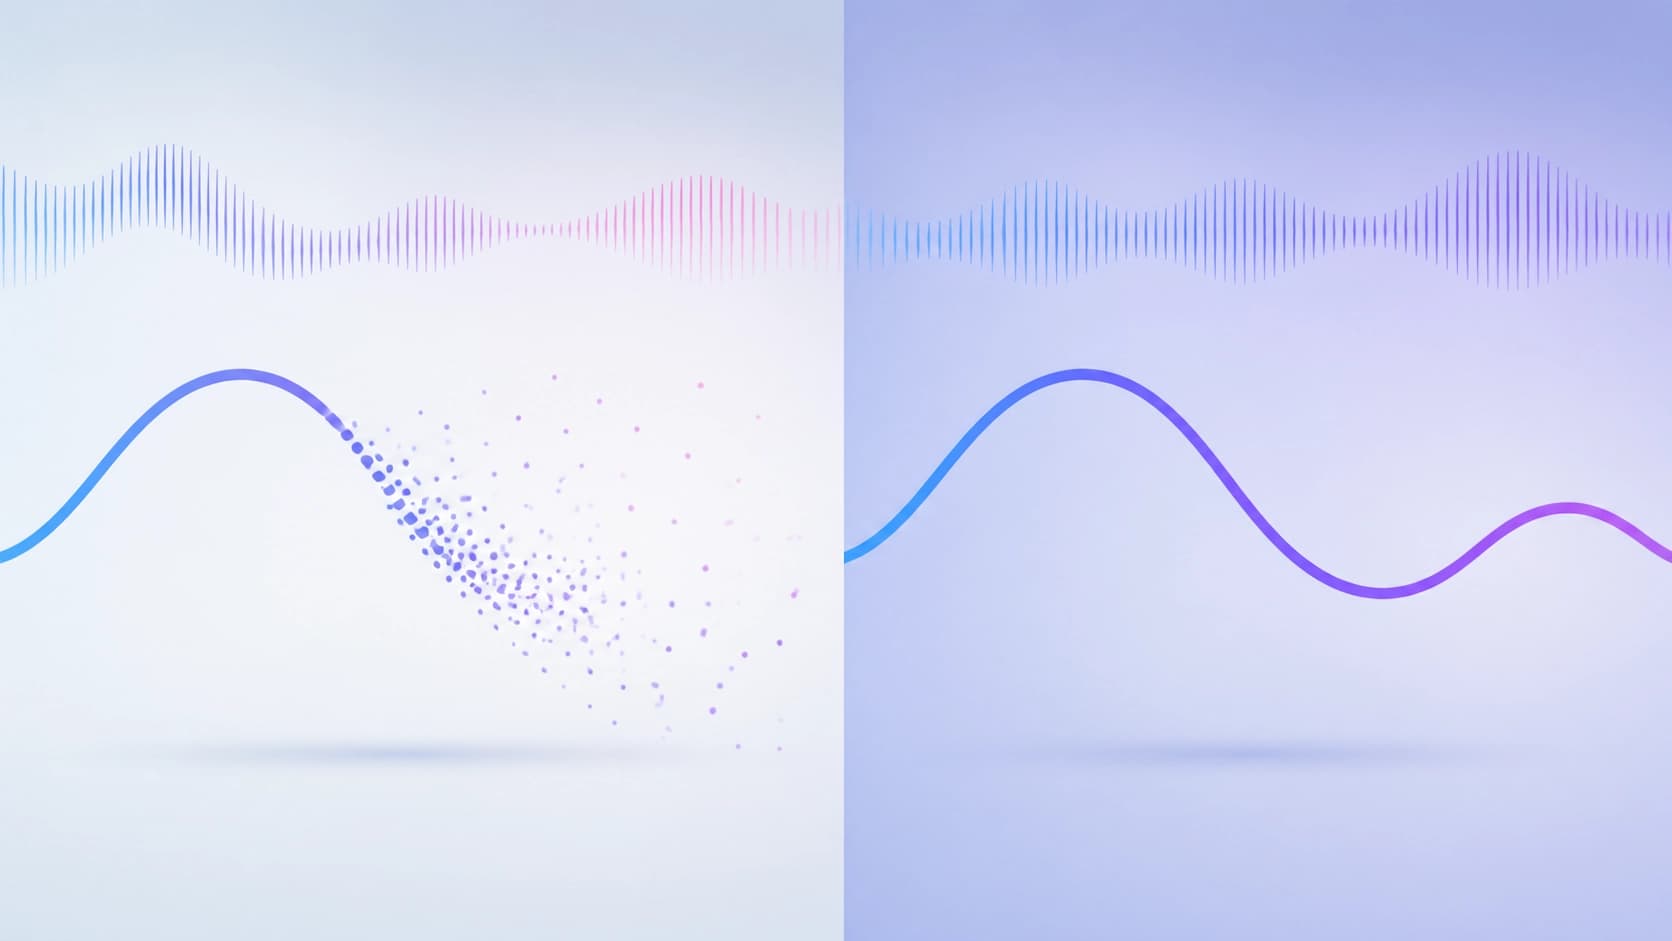
La partie la plus parlante — la comparaison avec l'inhibition soustractive. Un tel remplacement sait retenir des souvenirs statiques : conserver un point fixe n'est pas un problème. Mais il suffit que les signaux d'entrée commencent à varier dans le temps pour que la variété « éclate » (manifold shattering) — la continuité disparaît précisément là où elle est le plus nécessaire.
D'où une conclusion à garder en tête : la division n'est pas une curiosité biologique héritée du cortex, mais un mécanisme de calcul qui fonctionne. Elle est nécessaire pour que le réseau apprenne des représentations continues de haute précision, et pas seulement une discrétisation soignée.
Que faire de tout cela en pratique
L'intérêt pratique n'est pas de réécrire d'urgence tous les modèles récurrents. C'est plutôt un rappel : la normalisation ne concerne pas seulement la stabilité de l'apprentissage, ni seulement la régularisation. C'est un moyen de définir la géométrie de l'espace interne des états, et la division y a un avantage manifeste sur la soustraction.
Si la tâche exige de conserver une grandeur continue et de la mettre à jour en douceur — en commande, en suivi, dans tout système où l'on demande « combien » plutôt que « lequel » — il vaut la peine de s'intéresser aux schémas à normalisation multiplicative. Le coût est minime, et en échange le réseau cesse d'arrondir ce qu'il ne fallait pas arrondir.


